ค่าเฉลี่ย ส่วนเบี่ยงเบนมาตรฐาน: แปลผลและรายงานอย่างไรให้ถูกต้อง
ค่าเฉลี่ย ส่วนเบี่ยงเบนมาตรฐาน (mean และ SD) คือคู่สถิติพื้นฐานที่บอกว่าข้อมูลอยู่ตรงไหนและกระจายกว้างเพียงใด แต่จะแปลผลได้ถูกต้องก็ต่อเมื่อเลือกใช้กับข้อมูลที่ไม่เบ้มาก และไม่นำ SD ไปปะปนกับ SE ซึ่งเป็นความผิดพลาดที่พบได้แม้ในวารสารชั้นนำ
ค่าเฉลี่ย ส่วนเบี่ยงเบนมาตรฐาน คืออะไร และบอกอะไรเกี่ยวกับข้อมูล
ค่าเฉลี่ยเลขคณิต (arithmetic mean, x̄) คือผลรวมของค่าทั้งหมดหารด้วยจำนวนข้อมูล ทำหน้าที่เป็น “จุดศูนย์กลาง” ของข้อมูล ส่วนส่วนเบี่ยงเบนมาตรฐาน (standard deviation, SD หรือ S.D.) บอกว่าค่าของแต่ละหน่วยตัวอย่างอยู่ห่างจากค่าเฉลี่ยโดยทั่วไปมากน้อยเพียงใด คำนวณจากรากที่สองของความแปรปรวน (variance) ซึ่งในตัวอย่างใช้ตัวหาร n − 1 ทั้ง SPSS, R และ Excel (ฟังก์ชัน STDEV.S) ใช้สูตรนี้เป็นค่าตั้งต้น
สิ่งที่นักศึกษามักมองข้ามคือ ค่าเฉลี่ยเพียงตัวเดียวแทบไม่บอกอะไรเลยหากไม่มี SD กำกับ ลองพิจารณาสองกลุ่มที่ได้คะแนนเฉลี่ย 70 เท่ากัน กลุ่ม ก มี SD 5 ส่วนกลุ่ม ข มี SD 15 หากข้อมูลแจกแจงใกล้เคียงปกติ ประมาณ 68% ของกลุ่ม ก จะได้คะแนนระหว่าง 65 ถึง 75 และราว 95% อยู่ระหว่าง 60 ถึง 80 ขณะที่กลุ่ม ข ช่วงเดียวกันกว้างถึง 55 ถึง 85 และ 40 ถึง 100 ตามลำดับ แปลว่ากลุ่ม ข มีทั้งคนที่เก่งมากและคนที่ยังต้องช่วยเหลืออย่างมาก แม้ “ค่าเฉลี่ยเท่ากัน” ก็ตาม
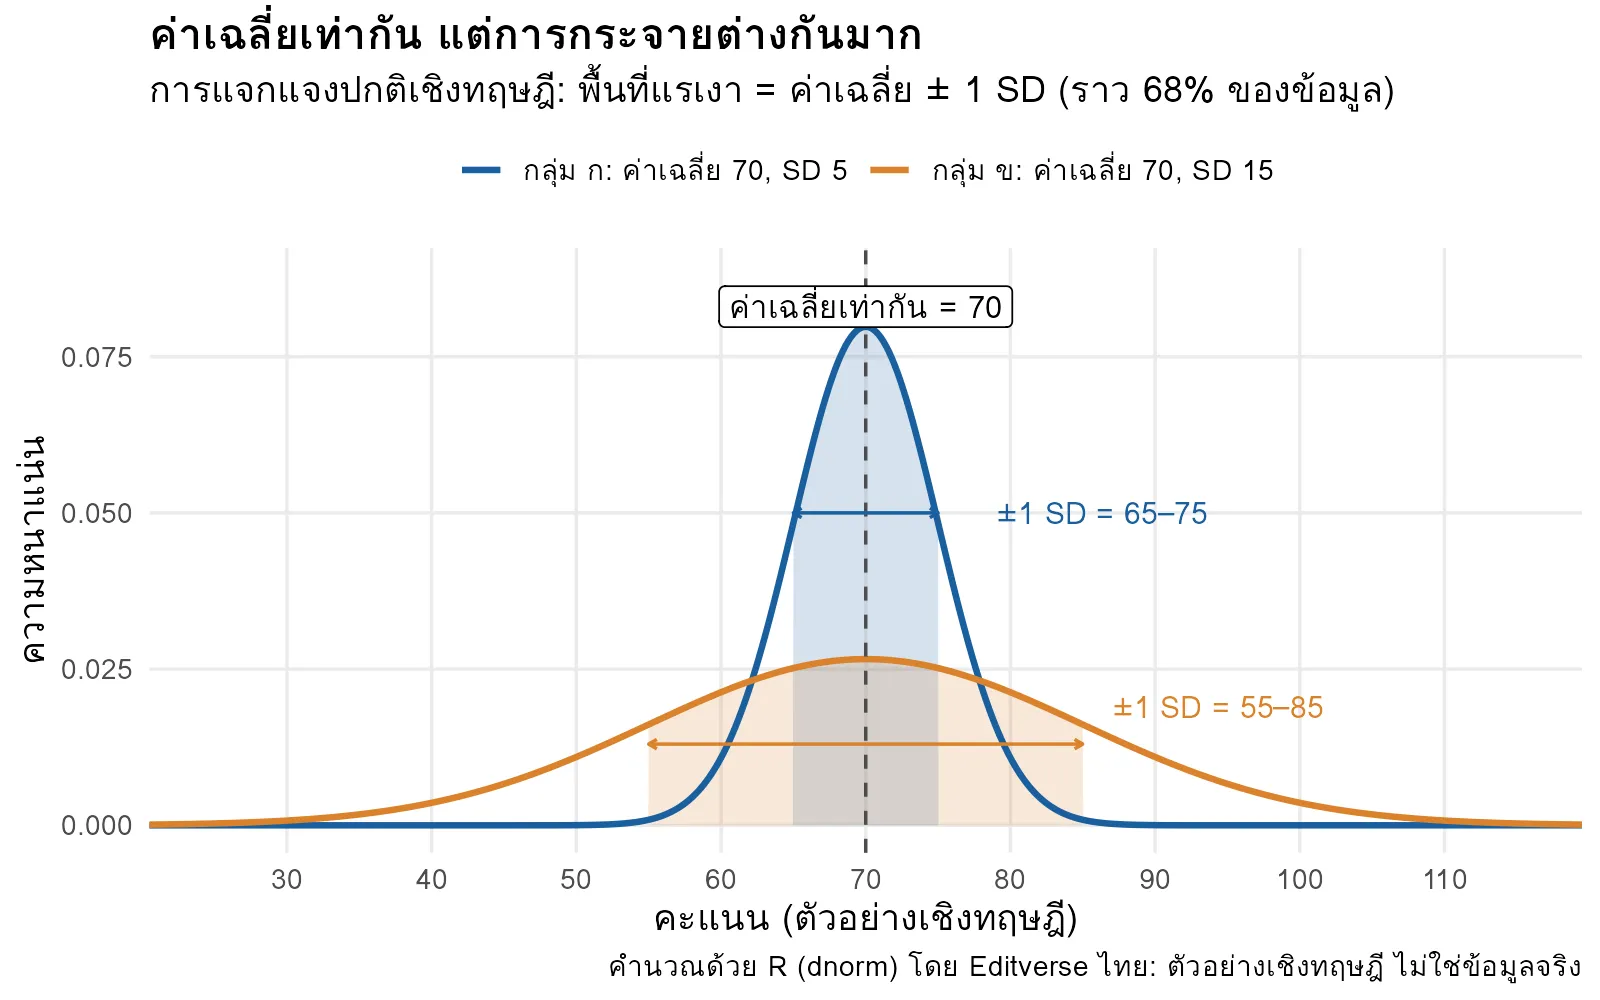
กฎ 68–95–99.7 ข้างต้นใช้ได้เฉพาะเมื่อข้อมูลมีรูปร่างใกล้การแจกแจงปกติเท่านั้น หากข้อมูลเบ้มาก ช่วงค่าเฉลี่ย ± 2SD อาจครอบคลุมค่าที่เป็นไปไม่ได้ เช่น ค่าติดลบของตัวแปรที่ต้องเป็นบวกเสมอ ซึ่งนำไปสู่หัวข้อถัดไป
ค่าเฉลี่ยหรือมัธยฐาน: เลือกอย่างไรเมื่อข้อมูลเบ้
ค่าเฉลี่ยไวต่อค่าสุดโต่ง ข้อมูลอย่างรายได้ ระยะเวลานอนโรงพยาบาล ค่าใช้จ่ายรักษาพยาบาล หรือความเข้มข้นของสารในเลือด มักเบ้ขวา คือมีค่าสูงมากจำนวนน้อยที่ดึงค่าเฉลี่ยให้สูงกว่าค่าของ “หน่วยทั่วไป” ในกรณีนี้มัธยฐาน (median) ซึ่งเป็นค่ากึ่งกลางเมื่อเรียงข้อมูล จะสะท้อนค่าที่พบได้ทั่วไปได้ดีกว่า และควรรายงานคู่กับพิสัยระหว่างควอร์ไทล์ (interquartile range, IQR)
แนวทาง SAMPL ซึ่ง EQUATOR Network รวบรวมไว้เป็นแนวทางการรายงานสถิติพื้นฐาน ระบุชัดว่าข้อมูลที่แจกแจงประมาณปกติให้สรุปด้วยค่าเฉลี่ยและ SD ส่วนข้อมูลที่ไม่แจกแจงปกติให้สรุปด้วยมัธยฐานและพิสัยระหว่างเปอร์เซ็นไทล์ โดยรายงานขอบล่างและขอบบนของช่วง ไม่ใช่เพียงความกว้างของช่วง [1][2]
สัญญาณเตือนว่าข้อมูลเบ้ แม้เห็นเพียงตัวเลขสรุป
Altman และ Bland เสนอวิธีตรวจจากตัวเลขสรุปในบทความ สำหรับตัวแปรที่ต้องมีค่าเป็นบวกเสมอ หากค่าเฉลี่ยน้อยกว่าสองเท่าของ SD ข้อมูลน่าจะเบ้ และหากมีหลายกลุ่มแล้วพบว่ากลุ่มที่ค่าเฉลี่ยสูงกว่ามี SD สูงกว่าตามไปด้วย ก็เป็นข้อบ่งชี้ที่ชัดของข้อมูลเบ้ขวา ซึ่งมักต้องใช้การแปลงลอการิทึม [3] ผู้ทบทวนบทความ (reviewer) ใช้หลักนี้ตรวจตาราง Table 1 ได้ในไม่กี่วินาที ดังนั้นควรตรวจก่อนส่งงานเสมอ
ตัวอย่างจากสถิติทางการของไทย
รายงานการสำรวจภาวะเศรษฐกิจและสังคมของครัวเรือน พ.ศ. 2568 (6 เดือนแรก) ของสำนักงานสถิติแห่งชาติ ระบุว่าครัวเรือนทั่วประเทศมีรายได้ทั้งสิ้นเฉลี่ยเดือนละ 28,151 บาท [4] ตัวเลขนี้เป็นค่าเฉลี่ย เมื่อผู้วิจัยนำไปอ้างในบทนำหรืออภิปรายผล ควรเขียนให้ชัดว่าเป็น “ค่าเฉลี่ย” ไม่ใช่ “รายได้ของครัวเรือนทั่วไป” เพราะตัวแปรรายได้โดยธรรมชาติมีค่าสูงมากเพียงไม่กี่ครัวเรือนที่ดึงค่าเฉลี่ยขึ้นได้ หากงานของคุณเก็บข้อมูลรายได้เอง ให้ตรวจการกระจายด้วยฮิสโทแกรมก่อน และพิจารณารายงานมัธยฐาน (IQR) ควบคู่
SD กับ SE ต่างกันอย่างไร: ความสับสนที่พบบ่อยในบทความ
บทความสถิติสั้นของ Altman และ Bland ใน BMJ อธิบายไว้ตรงที่สุดว่า หากต้องการบอกว่าค่าที่วัดได้กระจายกว้างเพียงใด ให้ใช้ SD แต่หากต้องการบอกความไม่แน่นอนของค่าเฉลี่ยที่ประมาณได้ ให้ใช้ความคลาดเคลื่อนมาตรฐานของค่าเฉลี่ย (standard error of the mean, SE หรือ SEM) โดย SE = SD/√n ดังนั้น SE จะเล็กลงเมื่อขนาดตัวอย่างเพิ่มขึ้น ขณะที่ SD ไม่ได้มีแนวโน้มเปลี่ยนตามขนาดตัวอย่าง [5]
| ประเด็น | ส่วนเบี่ยงเบนมาตรฐาน (SD) | ความคลาดเคลื่อนมาตรฐานของค่าเฉลี่ย (SE หรือ SEM) |
|---|---|---|
| ตอบคำถามว่า | ข้อมูลของแต่ละคนกระจายห่างจากค่าเฉลี่ยมากเพียงใด | ค่าเฉลี่ยที่คำนวณได้จากตัวอย่างนี้แม่นยำเพียงใดในการประมาณค่าเฉลี่ยของประชากร |
| สูตร | รากที่สองของผลรวมกำลังสองของส่วนต่างจากค่าเฉลี่ย หารด้วย n − 1 | SE = SD / √n |
| เมื่อเพิ่มขนาดตัวอย่าง | ไม่ได้มีแนวโน้มเล็กลง | มีแนวโน้มเล็กลงตาม √n |
| ใช้ในส่วนใดของบทความ | สถิติเชิงพรรณนา เช่น ตารางลักษณะของกลุ่มตัวอย่าง | ใช้คำนวณช่วงความเชื่อมั่น ควรรายงาน 95% CI แทนการรายงาน SE เดี่ยว ๆ |
| รูปแบบการรายงานที่แนะนำ | 42.1 (33.0) หรือ M = 42.1, SD = 33.0 | 42.1 (95% CI 36.1 ถึง 48.2) |
ปัญหาคือ SE มีค่าน้อยกว่า SD เสมอ ผู้เขียนบางรายจึงเลือกรายงาน “ค่าเฉลี่ย ± SE” ในตารางลักษณะกลุ่มตัวอย่าง ทำให้ข้อมูลดูสม่ำเสมอกว่าความเป็นจริงมาก การศึกษาของ Nagele สำรวจบทความในวารสารวิสัญญีวิทยาชั้นนำสี่ฉบับที่ตีพิมพ์ในปี 2001 พบว่า 198 จาก 860 บทความ (23%) ใช้ SEM อย่างไม่เหมาะสมเพื่ออธิบายความแปรปรวนของกลุ่มตัวอย่าง โดยมีสัดส่วนตั้งแต่ 11.5% ถึง 27.7% แล้วแต่วารสาร [6]
อีกจุดที่ควรระวังคือสัญลักษณ์ ± Altman และ Bland ชี้ว่าการเขียนแบบ “69.4 ± 9.3 กก.” ไม่ได้บอกผู้อ่านเลยว่าตัวเลขหลังเครื่องหมายคือ SD หรือ SE [5] แนวทาง SAMPL จึงแนะนำให้เขียนในรูป ค่าเฉลี่ย (SD) แทน ค่าเฉลี่ย ± SD และห้ามใช้ SE เพื่อแสดงความแปรปรวนของข้อมูล ส่วนการบอกความแม่นของค่าประมาณให้ใช้ช่วงความเชื่อมั่น 95% แทน SE ซึ่งเทียบเท่าช่วงความเชื่อมั่นเพียงประมาณ 68% [1] คำแนะนำของ ICMJE ก็ขอให้นำเสนอผลพร้อมตัวชี้วัดความคลาดเคลื่อนหรือความไม่แน่นอนที่เหมาะสม เช่น ช่วงความเชื่อมั่น และให้นิยามศัพท์ อักษรย่อ และสัญลักษณ์ทางสถิติที่ใช้ [7]
หลักเดียวกันใช้กับกราฟ Cumming และคณะอธิบายว่าแท่งความคลาดเคลื่อน (error bar) อาจแสดงช่วงความเชื่อมั่น SE หรือ SD ซึ่งให้ข้อมูลต่างกันมาก คำอธิบายภาพจึงต้องระบุให้ชัดว่า error bar คืออะไร [8] หากกราฟในบทที่ 4 ของคุณไม่มีคำอธิบายนี้ ถือเป็นจุดที่กรรมการสอบหรือผู้ทบทวนมักทักท้วง
สัมประสิทธิ์การแปรผัน (CV): เปรียบเทียบการกระจายข้ามหน่วยวัด
SD มีหน่วยเดียวกับข้อมูล จึงเทียบกันตรง ๆ ไม่ได้เมื่อตัวแปรต่างหน่วยหรือมีค่าเฉลี่ยต่างกันมาก สัมประสิทธิ์การแปรผัน (coefficient of variation, CV) แก้ปัญหานี้โดยคิดเป็นร้อยละของค่าเฉลี่ย คือ CV = (SD / ค่าเฉลี่ย) × 100 ทำให้ได้ตัวเลขที่ไม่มีหน่วย และเป็นตัววัดการกระจายสัมพัทธ์ที่ใช้กันมากที่สุดเมื่อต้องการขจัดอิทธิพลของความต่างของค่าเฉลี่ย [9]
เงื่อนไขสำคัญคือ CV มีความหมายเฉพาะกับตัวแปรสเกลอัตราส่วน (ratio scale) ที่ค่าศูนย์หมายถึง “ไม่มีเลย” จริง เช่น น้ำหนัก ความยาว เวลา หรือความเข้มข้น ตารางด้านล่างคำนวณจากชุดข้อมูลจริงชุดเดียวกันใน R [10] ความเร็วลมให้ CV 35.4% ไม่ว่าจะวัดเป็นไมล์หรือกิโลเมตรต่อชั่วโมง แต่อุณหภูมิชุดเดิมให้ CV 12.2% เมื่อเป็นองศาฟาเรนไฮต์ และ 20.6% เมื่อแปลงเป็นองศาเซลเซียส ทั้งที่การกระจายจริงไม่ได้เปลี่ยน เพราะศูนย์ของทั้งสองสเกลถูกกำหนดขึ้นเอง ด้วยเหตุผลเดียวกัน คะแนนที่ไม่มีศูนย์แท้ เช่น คะแนนมาตรวัดแบบ Likert ไม่ควรนำมาคิด CV เพื่อเปรียบเทียบ
| ตัวแปร (ชุดข้อมูล airquality) | หน่วย | ค่าเฉลี่ย | SD | CV |
|---|---|---|---|---|
| ความเร็วลม (n = 153) | ไมล์ต่อชั่วโมง | 9.96 | 3.52 | 35.4% |
| ความเร็วลม (n = 153) | กิโลเมตรต่อชั่วโมง | 16.03 | 5.67 | 35.4% |
| อุณหภูมิสูงสุด (n = 153) | องศาฟาเรนไฮต์ | 77.88 | 9.47 | 12.2% |
| อุณหภูมิสูงสุด (n = 153) | องศาเซลเซียส | 25.49 | 5.26 | 20.6% |
| โอโซน (n = 116) | ppb | 42.13 | 32.99 | 78.3% |
CV ยังไวต่อค่าผิดปกติ เพราะคำนวณจากค่าเฉลี่ยและ SD ซึ่งถูกค่าสุดโต่งดึงได้ งานของ Botta-Dukát ซึ่งศึกษาลักษณะทางนิเวศที่คำนวณเป็นอัตราส่วน (เช่น พื้นที่ใบจำเพาะกับค่าผกผัน) แสดงว่าเมื่อมีค่าผิดปกติ CV อาจให้ผลที่ตีความต่างกัน และพบว่า quartile coefficient of variation ซึ่งคำนวณจากควอร์ไทล์ไวต่อค่าผิดปกติน้อยกว่า [9] หากข้อมูลของคุณเบ้มากจนต้องรายงานมัธยฐาน ก็ไม่ควรใช้ CV แบบดั้งเดิมเป็นตัวสรุปหลัก
ตัวอย่างการคำนวณและแปลผลทีละขั้น: ข้อมูลโอโซน 116 วัน
เพื่อให้เห็นทุกขั้นตอนด้วยข้อมูลจริงที่ใครก็ตรวจซ้ำได้ เราใช้ชุดข้อมูล airquality ที่ติดมากับโปรแกรม R ซึ่งเป็นค่าคุณภาพอากาศรายวันในนิวยอร์ก ตั้งแต่ 1 พฤษภาคม ถึง 30 กันยายน 1973 ค่าโอโซนวัดเป็นส่วนในพันล้านส่วน (ppb) ข้อมูลโอโซนได้จาก New York State Department of Conservation [10] จาก 153 วัน มีค่าโอโซนครบ 116 วัน (สูญหาย 37 วัน ซึ่งต้องรายงานด้วย)
- คำนวณสถิติพื้นฐาน: ค่าเฉลี่ย 42.1 ppb, SD 33.0, มัธยฐาน 31.5, ควอร์ไทล์ที่ 1 และ 3 เท่ากับ 18.0 และ 63.3, ค่าต่ำสุด 1 และสูงสุด 168
- ตรวจความเบ้จากตัวเลขสรุป: โอโซนมีค่าเป็นบวกเสมอ แต่ค่าเฉลี่ย (42.1) น้อยกว่า 2 × SD (66.0) และค่าเฉลี่ย − 2SD = −23.8 ซึ่งเป็นไปไม่ได้ จึงเป็นสัญญาณของข้อมูลเบ้ขวาตามหลักของ Altman และ Bland [3] ค่าเฉลี่ยยังสูงกว่ามัธยฐานราว 10.6 ppb ซึ่งสอดคล้องกัน
- ยืนยันด้วยกราฟ: ฮิสโทแกรมในภาพที่ 2 แสดงหางยาวทางขวาอย่างชัดเจน ค่าความเบ้ (skewness) ที่คำนวณได้เท่ากับ 1.23
- คำนวณ SE และช่วงความเชื่อมั่น: SE = 33.0 / √116 = 3.06 ช่วงความเชื่อมั่น 95% ของค่าเฉลี่ย (ใช้ค่า t ที่ df = 115) เท่ากับ 36.1 ถึง 48.2 ppb
- คำนวณ CV: 33.0 / 42.1 × 100 = 78.3% แสดงว่าการกระจายสัมพัทธ์สูงมาก แต่เนื่องจากข้อมูลเบ้ ตัวเลขนี้ควรใช้เพื่อประกอบการอธิบายเท่านั้น
- ตัดสินใจเลือกสถิติที่รายงาน: ใช้มัธยฐาน (IQR) เป็นตัวสรุปหลัก และให้ค่าเฉลี่ย (SD) เป็นข้อมูลเสริมหากวารสารหรือการวิเคราะห์อภิมานต้องการ
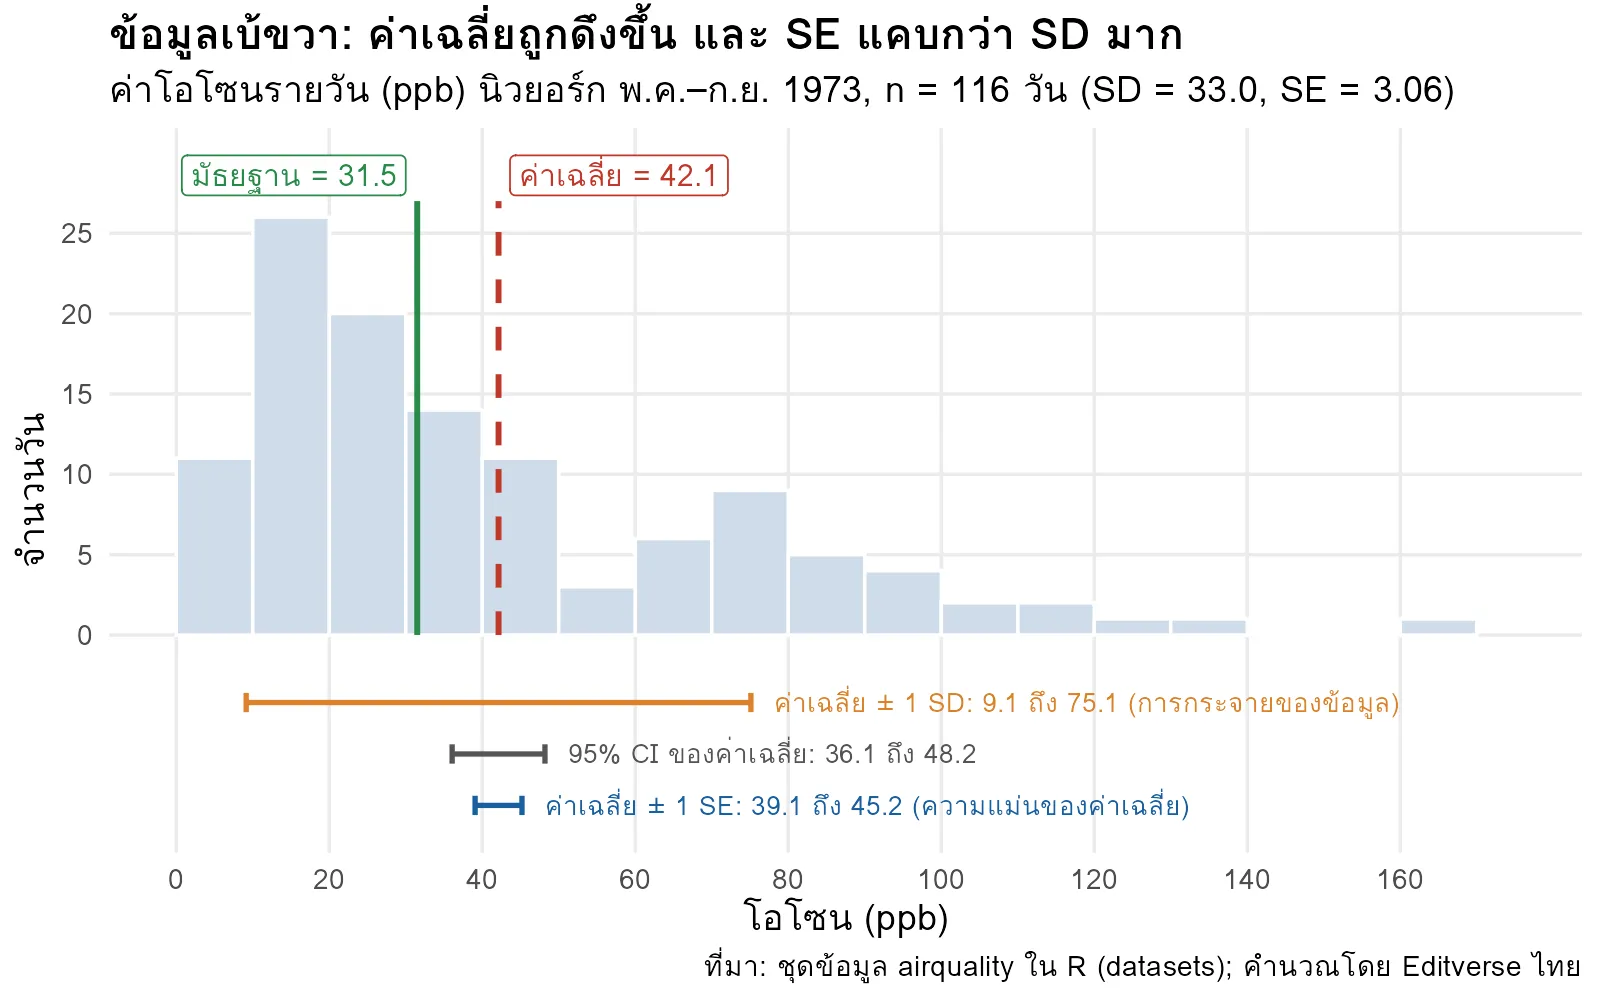
ภาพที่ 2 แสดงให้เห็นว่าทำไมการรายงานผิดตัวจึงอันตราย ถ้าเขียนว่า “โอโซนเฉลี่ย 42.1 ± 3.1 ppb” โดยไม่บอกว่าเป็น SE ผู้อ่านจะเข้าใจว่าแทบทุกวันมีค่าอยู่ราว 39 ถึง 45 ppb ทั้งที่ช่วงค่าเฉลี่ย ± 1 SD กว้างตั้งแต่ 9.1 ถึง 75.1 ppb และครอบคลุมข้อมูลจริงเพียง 72.4% ของวัน (ไม่ใช่ 68% ตามทฤษฎี เพราะข้อมูลไม่ได้แจกแจงปกติ)
ตัวอย่างประโยครายงานผล
ภาษาไทย: “ค่าโอโซนรายวันมีการแจกแจงเบ้ขวา (n = 116; ข้อมูลสูญหาย 37 วัน) มัธยฐานเท่ากับ 31.5 ppb (IQR 18.0–63.3; พิสัย 1–168) ค่าเฉลี่ยเท่ากับ 42.1 ppb (SD 33.0; 95% CI 36.1–48.2)”
ภาษาอังกฤษ: “Daily ozone concentrations were right-skewed (n = 116; 37 days missing); the median was 31.5 ppb (IQR 18.0–63.3; range 1–168) and the mean was 42.1 ppb (SD 33.0; 95% CI 36.1–48.2).”
| สิ่งที่พบในข้อมูล | สถิติที่ควรรายงาน | เหตุผล |
|---|---|---|
| ตัวแปรต่อเนื่อง ฮิสโทแกรมค่อนข้างสมมาตร ไม่มีค่าผิดปกติรุนแรง | ค่าเฉลี่ย (SD) | ค่าเฉลี่ยและ SD สรุปรูปร่างการแจกแจงแบบนี้ได้ครบ |
| ตัวแปรที่ค่าเป็นบวกเสมอ และค่าเฉลี่ยน้อยกว่า 2 เท่าของ SD | มัธยฐาน (IQR) และควรแสดงค่าต่ำสุด–สูงสุดหรือฮิสโทแกรม | เป็นสัญญาณว่าข้อมูลเบ้ขวา ค่าเฉลี่ย − 2SD จะติดลบซึ่งเป็นไปไม่ได้ |
| กลุ่มที่มีค่าเฉลี่ยสูงกว่ามี SD สูงกว่าตามไปด้วย | มัธยฐาน (IQR) หรือวิเคราะห์บนสเกลลอการิทึม | เป็นข้อบ่งชี้ที่ชัดของข้อมูลเบ้ขวา |
| ต้องการบอกความแม่นของค่าเฉลี่ย หรือเปรียบเทียบค่าเฉลี่ยระหว่างกลุ่ม | ค่าเฉลี่ยพร้อม 95% CI | ช่วงความเชื่อมั่นสื่อความไม่แน่นอนได้ชัดกว่า SE |
| ต้องการเทียบการกระจายของตัวแปรต่างหน่วย หรือค่าเฉลี่ยต่างกันมาก | CV (%) เฉพาะตัวแปรสเกลอัตราส่วน | CV ไม่มีหน่วย แต่ใช้ได้เมื่อศูนย์มีความหมายจริงเท่านั้น |
บริบทไทย: การรายงานค่าเฉลี่ยและ SD ในวิทยานิพนธ์และวารสาร
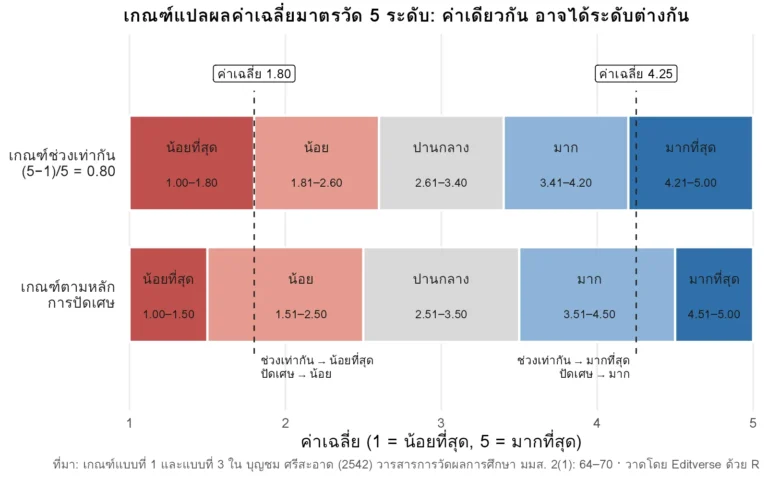
ในวิทยานิพนธ์และบทความภาษาไทย มักพบการรายงานในรูป x̄ และ S.D. ในตารางของบทที่ 4 โดยเฉพาะงานที่ใช้แบบสอบถาม ข้อควรระวังคือ เกณฑ์แปลความหมายค่าเฉลี่ยของมาตรวัด Likert (เช่น ช่วงคะแนนที่แปลว่า “มาก” หรือ “ปานกลาง”) เป็นการตีความระดับ ซึ่งแยกจากเรื่องที่บทความนี้อธิบาย การแปลผลค่าเฉลี่ยต้องอ่านคู่กับ SD เสมอ ค่าเฉลี่ย 3.80 ที่มี SD 0.40 กับค่าเฉลี่ย 3.80 ที่มี SD 1.20 บอกเรื่องราวต่างกันมาก กรณีหลังหมายความว่าผู้ตอบแบ่งความเห็นกันชัดเจน และควรอภิปรายประเด็นนี้ในบทที่ 5 ด้วย
เมื่อเปลี่ยนจากวิทยานิพนธ์ไปเป็นบทความสำหรับวารสาร TCI หรือวารสารนานาชาติ สิ่งที่ต้องปรับมีสามเรื่อง ประการแรก ตรวจคำแนะนำผู้แต่งของวารสารเป้าหมายว่าต้องการรูปแบบ mean (SD) หรือ mean ± SD และวารสารการแพทย์ที่อ้างอิงแนวทาง ICMJE จะคาดหวังให้นิยามสัญลักษณ์และระบุโปรแกรมพร้อมเวอร์ชันที่ใช้ [7] ประการที่สอง ระบุในส่วนวิธีการว่าตรวจการแจกแจงของข้อมูลอย่างไร และเลือกสถิติพรรณนาตามผลนั้น (ดูแนวการเขียนใน การเขียนส่วน Methods) ประการที่สาม ห้ามใช้ SE ในตาราง Table 1 ความผิดพลาดเชิงสถิติพื้นฐานลักษณะนี้อาจทำให้บรรณาธิการตั้งคำถามกับคุณภาพของทั้งบทความ และอาจเป็นเหตุให้บทความถูกปฏิเสธตั้งแต่ขั้นแรก (อ่านเพิ่มเติม 10 สาเหตุที่ทำให้บทความถูก Desk Rejected)
สำหรับผู้ที่ยังลังเลว่าจะคำนวณด้วยโปรแกรมใด ทั้ง SPSS (Analyze → Descriptive Statistics → Explore) และ R (ฟังก์ชัน mean(), sd(), median(), IQR()) ให้ผลตรงกันเมื่อใช้ข้อมูลเดียวกัน เปรียบเทียบข้อดีของแต่ละโปรแกรมได้ใน SPSS vs R vs Python และหากอยู่ในขั้นวางแผนโครงร่าง ควรเขียนแผนการวิเคราะห์ข้อมูลเชิงพรรณนาไว้ตั้งแต่บทที่ 3 ตามแนวทางใน การเขียนโครงร่างวิทยานิพนธ์ในไทย
สรุป
ค่าเฉลี่ยและ SD เป็นสถิติที่ทุกงานวิจัยเชิงปริมาณต้องรายงาน แต่ใช้ได้ดีเฉพาะกับข้อมูลที่ใกล้การแจกแจงปกติ ก่อนส่งวิทยานิพนธ์หรือบทความ ให้ตรวจรายการต่อไปนี้
- ดูฮิสโทแกรมหรือ box plot ของตัวแปรต่อเนื่องทุกตัวก่อนเลือกสถิติพรรณนา
- ตัวแปรที่ต้องเป็นบวก: ถ้าค่าเฉลี่ยน้อยกว่า 2 × SD ให้สงสัยว่าข้อมูลเบ้ และพิจารณารายงานมัธยฐาน (IQR)
- ใช้ SD เพื่อบรรยายการกระจายของกลุ่มตัวอย่าง ไม่ใช้ SE ในตาราง Table 1
- บอกความแม่นของค่าเฉลี่ยด้วยช่วงความเชื่อมั่น 95% แทน SE
- เขียนรูปแบบ ค่าเฉลี่ย (SD) หรือระบุให้ชัดว่าตัวเลขหลัง ± คืออะไร
- ระบุในคำอธิบายภาพทุกภาพว่า error bar แสดง SD, SE หรือ 95% CI
- ใช้ CV เฉพาะตัวแปรสเกลอัตราส่วน และระวังค่าผิดปกติ
- รายงานจำนวนข้อมูลที่ใช้คำนวณจริงและจำนวนข้อมูลสูญหาย
หากคุณมีผลวิเคราะห์อยู่แล้วและต้องการให้ผู้เชี่ยวชาญตรวจว่าเลือกสถิติพรรณนาเหมาะกับลักษณะข้อมูล อ่านค่าถูกต้อง และเขียนรายงานตามมาตรฐานที่วารสารต้องการ ทีม วิเคราะห์สถิติ ของ Editverse มีบรรณาธิการที่จบปริญญาเอกหรือแพทยศาสตร์ในสาขาของคุณช่วยตรวจสอบและขัดเกลางาน เราแก้ไขและยกระดับงานของคุณ — เราไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
เมื่อใดควรรายงานมัธยฐานแทนค่าเฉลี่ย
เมื่อข้อมูลเบ้ สำหรับตัวแปรที่มีค่าเป็นบวกเสมอ ถ้าค่าเฉลี่ยน้อยกว่า 2 × SD ให้สงสัยว่าข้อมูลเบ้ และพิจารณารายงานมัธยฐาน (IQR)
SD กับ SE ต่างกันอย่างไร
SD บรรยายการกระจายของข้อมูลในกลุ่มตัวอย่าง ส่วน SE บอกความแม่นของค่าเฉลี่ย ซึ่งควรรายงานเป็นช่วงความเชื่อมั่น 95% แทน
ควรเขียนค่าเฉลี่ยและ SD รูปแบบใด
เขียนเป็น ค่าเฉลี่ย (SD) หรือระบุให้ชัดว่าตัวเลขหลัง ± คืออะไร และระบุในคำอธิบายภาพว่า error bar แสดง SD, SE หรือ 95% CI
เอกสารอ้างอิง
- Lang, T. A., & Altman, D. G. (2015). Basic statistical reporting for articles published in biomedical journals: The “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. International Journal of Nursing Studies, 52(1), 5–9. doi:10.1016/j.ijnurstu.2014.09.006 PMID: 25441757
- EQUATOR Network. (n.d.). Basic statistical reporting for articles published in biomedical journals: The SAMPL Guidelines. https://www.equator-network.org/reporting-guidelines/sampl/
- Altman, D. G., & Bland, J. M. (1996). Detecting skewness from summary information. BMJ, 313(7066), 1200. doi:10.1136/bmj.313.7066.1200 PMID: 8916759
- สำนักงานสถิติแห่งชาติ. (2568). การสำรวจภาวะเศรษฐกิจและสังคมของครัวเรือน พ.ศ. 2568 (6 เดือนแรก). https://www.nso.go.th/nsoweb/storage/survey_detail/2025/20250924095708_31280.pdf
- Altman, D. G., & Bland, J. M. (2005). Standard deviations and standard errors. BMJ, 331(7521), 903. doi:10.1136/bmj.331.7521.903 PMID: 16223828
- Nagele, P. (2003). Misuse of standard error of the mean (SEM) when reporting variability of a sample. A critical evaluation of four anaesthesia journals. British Journal of Anaesthesia, 90(4), 514–516. doi:10.1093/bja/aeg087 PMID: 12644429
- International Committee of Medical Journal Editors. (2026). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals: Preparing a manuscript for submission to a medical journal. https://www.icmje.org/recommendations/browse/manuscript-preparation/preparing-for-submission.html
- Cumming, G., Fidler, F., & Vaux, D. L. (2007). Error bars in experimental biology. The Journal of Cell Biology, 177(1), 7–11. doi:10.1083/jcb.200611141 PMID: 17420288
- Botta-Dukát, Z. (2023). Quartile coefficient of variation is more robust than CV for traits calculated as a ratio. Scientific Reports, 13(1), 4671. doi:10.1038/s41598-023-31711-8 PMID: 36949089
- R Core Team. (n.d.). airquality: New York air quality measurements (R datasets package documentation). https://stat.ethz.ch/R-manual/R-devel/library/datasets/html/airquality.html
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ