G Power คำนวณ Sample Size ทีละขั้นตอน: t-test, ANOVA, Regression
G Power (G*Power) คือโปรแกรมฟรีสำหรับคำนวณขนาดกลุ่มตัวอย่างจากอำนาจการทดสอบ โดยใช้ค่าสี่ตัว ได้แก่ ชนิดของการทดสอบ ระดับนัยสำคัญ (α) อำนาจการทดสอบ (power) และขนาดอิทธิพล (effect size) บทความนี้สาธิตการกรอกค่าทีละช่องสำหรับ t-test, One-way ANOVA และ Multiple regression พร้อมตัวเลขผลลัพธ์ที่ตรวจซ้ำด้วย R
G Power คืออะไร และต้องเตรียมค่าอะไรก่อนเปิดโปรแกรม
G*Power พัฒนาโดยทีมของ Franz Faul, Edgar Erdfelder, Albert-Georg Lang และ Axel Buchner บทความหลักของเวอร์ชัน 3 ตีพิมพ์ใน Behavior Research Methods ปี 2007 และอธิบายว่าโปรแกรมรองรับการวิเคราะห์อำนาจห้าแบบ ได้แก่ a priori, compromise, criterion, post hoc และ sensitivity [1] สำหรับการวางแผนงานวิจัย เราใช้แบบ a priori คือกำหนด α, power และขนาดอิทธิพล แล้วให้โปรแกรมคำนวณจำนวนตัวอย่างที่ต้องการ ปัจจุบันเว็บไซต์ทางการของ Heinrich-Heine-Universität Düsseldorf ให้ดาวน์โหลดฟรี เวอร์ชัน 3.1.9.7 สำหรับ Windows และ 3.1.9.6 สำหรับ macOS [2]
ก่อนเปิดโปรแกรม ควรมีคำตอบสี่ข้อนี้ในมือ
- การทดสอบทางสถิติหลัก ที่จะใช้ตอบสมมติฐานข้อหลัก เช่น Independent t-test หรือ One-way ANOVA ไม่ใช่ทุกการทดสอบในบทที่ 4
- ระดับนัยสำคัญ α ส่วนใหญ่ใช้ 0.05 และต้องระบุว่าเป็นการทดสอบแบบสองทาง (two-tailed) หรือทางเดียว
- อำนาจการทดสอบ (1 − β) ค่าที่ Cohen เสนอเป็นค่ามาตรฐานคือ 0.80 ซึ่งหมายถึงยอมรับโอกาสพลาดการตรวจพบผลจริง 20% [3]
- ขนาดอิทธิพลที่คาดไว้ ซึ่งเป็นค่าที่ยากที่สุดและมีผลต่อคำตอบมากที่สุด
Cohen (1992) ใน “A power primer” กำหนดค่าอ้างอิงขนาดอิทธิพลเล็ก กลาง และใหญ่ไว้ดังตาราง [3]
| การทดสอบ | ดัชนีขนาดอิทธิพล | เล็ก | กลาง | ใหญ่ |
|---|---|---|---|---|
| t-test (เปรียบเทียบค่าเฉลี่ย 2 กลุ่ม) | d | 0.20 | 0.50 | 0.80 |
| ANOVA (เปรียบเทียบค่าเฉลี่ยหลายกลุ่ม) | f | 0.10 | 0.25 | 0.40 |
| Multiple regression | f² | 0.02 | 0.15 | 0.35 |
ข้อควรจำคือค่าอ้างอิงเหล่านี้เป็นทางเลือกสุดท้ายเมื่อไม่มีข้อมูลอื่น หากมีงานวิจัยก่อนหน้า การศึกษานำร่อง หรือค่าความแตกต่างที่มีความหมายทางคลินิก ควรคำนวณขนาดอิทธิพลจากข้อมูลเหล่านั้นแทน และระบุแหล่งที่มาในโครงร่าง
วิธีใช้ G Power คำนวณ sample size สำหรับ Independent t-test
สถานการณ์: นักศึกษาปริญญาโทต้องการเปรียบเทียบคะแนนสอบระหว่างกลุ่มที่เรียนแบบออนไลน์กับกลุ่มที่เรียนในชั้นเรียน สมมติว่างานวิจัยก่อนหน้ารายงานค่าเฉลี่ย 72 และ 67 คะแนน ส่วนเบี่ยงเบนมาตรฐานรวม 10 คะแนน ขนาดอิทธิพลจึงเท่ากับ d = (72 − 67) / 10 = 0.5 (ตัวเลขชุดนี้เป็นตัวอย่างประกอบการสอน)
ขั้นตอนใน G*Power มีดังนี้
- Test family: เลือก t tests
- Statistical test: Means: Difference between two independent means (two groups)
- Type of power analysis: A priori: Compute required sample size – given α, power, and effect size
- Input parameters: Tail(s) = Two, Effect size d = 0.5, α err prob = 0.05, Power (1−β err prob) = 0.80, Allocation ratio N2/N1 = 1
- กด Calculate
ผลลัพธ์: Sample size group 1 = 64, group 2 = 64, Total sample size = 128 เราตรวจซ้ำด้วยฟังก์ชัน pwr.t.test(d = 0.5, power = 0.80) ในแพ็กเกจ pwr ของ R [4] ได้ n = 63.77 ต่อกลุ่ม ปัดขึ้นเป็น 64 คน และที่ 64 คนต่อกลุ่มจะได้ power จริง 0.801 ตรงกัน เพราะทั้งสองโปรแกรมใช้การแจกแจง noncentral t แบบเดียวกัน
ภาพที่ 1 แสดงว่าจำนวนนี้ไวต่อขนาดอิทธิพลเพียงใด หากผลจริงเล็กกว่าที่คาด เช่น d = 0.3 จะต้องใช้ 176 คนต่อกลุ่ม แต่ถ้า d = 0.8 จะใช้เพียง 26 คนต่อกลุ่ม และหากต้องการ power 0.90 ที่ d = 0.5 จำนวนจะเพิ่มเป็น 86 คนต่อกลุ่ม

กรณี Paired t-test (วัดก่อน-หลังในคนเดิม)
ให้เลือก Statistical test เป็น Means: Difference between two dependent means (matched pairs) ขนาดอิทธิพลในกรณีนี้คือ dz ซึ่งคำนวณจากค่าเฉลี่ยของผลต่างหารด้วยส่วนเบี่ยงเบนมาตรฐานของผลต่าง ไม่ใช่ SD ของแต่ละรอบการวัด ที่ dz = 0.5, α = 0.05 และ power = 0.80 จะได้ 34 คู่ น้อยกว่าแบบสองกลุ่มอิสระเมื่อใช้ตัวเลขขนาดอิทธิพลเท่ากัน แต่ต้องระวังว่า dz ไม่ใช่ d ตัวเดียวกัน เมื่อ SD ของสองรอบการวัดเท่ากัน dz = d / √(2(1 − ρ)) โดย ρ คือสหสัมพันธ์ระหว่างการวัดสองครั้งของคนเดิม จึงหา dz จากงานก่อนหน้าหรือข้อมูลนำร่องที่มี ρ ให้ใช้ ไม่ควรนำ d ของงานสองกลุ่มอิสระมาใส่แทนตรง ๆ การวัดซ้ำจะได้ประโยชน์เมื่อ ρ สูง เพราะตัดความแปรปรวนระหว่างบุคคลออกไป ส่วนรายละเอียดว่าควรเลือก t-test แบบใดเมื่อใด เราอธิบายไว้ในบทความแยกเรื่องชนิดของ t-test
ตัวอย่างที่ 2: G Power สำหรับ One-way ANOVA
สถานการณ์: เปรียบเทียบความพึงพอใจต่อบริการของผู้ป่วยสามกลุ่มอายุด้วย One-way ANOVA ขนาดอิทธิพลของ ANOVA ใน G*Power คือ Cohen’s f ซึ่งแปลงจาก eta-squared ได้ด้วยสูตร f = √(η² / (1 − η²)) ถ้างานก่อนหน้ารายงาน η² = 0.06 จะได้ f = √(0.06 / 0.94) = 0.253 ใกล้เคียงค่า “กลาง” 0.25 ของ Cohen [3]
- Test family: F tests
- Statistical test: ANOVA: Fixed effects, omnibus, one-way
- Type of power analysis: A priori
- Input parameters: Effect size f = 0.25, α err prob = 0.05, Power = 0.80, Number of groups = 3
ผลลัพธ์: Total sample size = 159 หรือ 53 คนต่อกลุ่ม ตรวจซ้ำด้วย pwr.anova.test(k = 3, f = 0.25, power = 0.80) ได้ n = 52.40 ต่อกลุ่ม ปัดขึ้นเป็น 53 หากเพิ่มเป็น 4 กลุ่ม (ค่าอื่นเท่าเดิม) จะได้ 45 คนต่อกลุ่ม รวม 180 คน สังเกตว่าจำนวนต่อกลุ่มลดลงแต่จำนวนรวมเพิ่มขึ้น
ข้อควรระวังคือค่านี้คำนวณสำหรับ การทดสอบรวม (omnibus F) เท่านั้น ถ้าคำถามวิจัยหลักคือการเปรียบเทียบคู่เฉพาะ เช่น กลุ่ม A กับกลุ่ม C หลังการทดสอบ post hoc ควรคำนวณ power สำหรับการเปรียบเทียบคู่นั้นด้วย โดยใช้ α ที่ปรับแล้ว ซึ่งมักต้องการจำนวนมากกว่าค่าที่ได้จาก omnibus test
ตัวอย่างที่ 3: G Power สำหรับ Multiple regression
ส่วนการวิเคราะห์สหสัมพันธ์และการถดถอยได้รับการขยายใน G*Power 3.1 ซึ่ง Faul และคณะ (2009) อธิบายไว้ในบทความแยก [5] สำหรับการถดถอยพหุคูณ ขนาดอิทธิพลคือ Cohen’s f² = R² / (1 − R²) เช่น ถ้าคาดว่าตัวแปรต้นทั้งชุดอธิบายความแปรปรวนได้ R² = 0.13 จะได้ f² = 0.13 / 0.87 = 0.149 ใกล้ค่า “กลาง” 0.15 [3]
- Test family: F tests
- Statistical test: Linear multiple regression: Fixed model, R² deviation from zero
- Type of power analysis: A priori
- Input parameters: Effect size f² = 0.15, α err prob = 0.05, Power = 0.80, Number of predictors = 5
ผลลัพธ์: Total sample size = 92 ตรวจซ้ำด้วย pwr.f2.test(u = 5, f2 = 0.15, power = 0.80) ได้องศาอิสระของตัวหาร v = 85.21 ปัดขึ้นเป็น 86 แล้วบวก u + 1 = 6 ได้ n = 92 ตรงกัน หากคาดว่าผลเล็ก (f² = 0.02) จำนวนจะพุ่งขึ้นเป็น 647 คน ส่วนผลใหญ่ (f² = 0.35) ใช้ 43 คน
ถ้าคำถามหลักคือ “ตัวแปรกลุ่มหนึ่งอธิบายเพิ่มได้หรือไม่หลังควบคุมตัวแปรอื่นแล้ว” (hierarchical regression) ให้เลือก Fixed model, R² increase แทน และใส่จำนวนตัวแปรที่ทดสอบแยกจากจำนวนตัวแปรทั้งหมด การเลือกผิดเมนูเป็นสาเหตุที่พบบ่อยที่ทำให้ตัวเลขในโครงร่างไม่ตรงกับแบบจำลองที่วิเคราะห์จริง
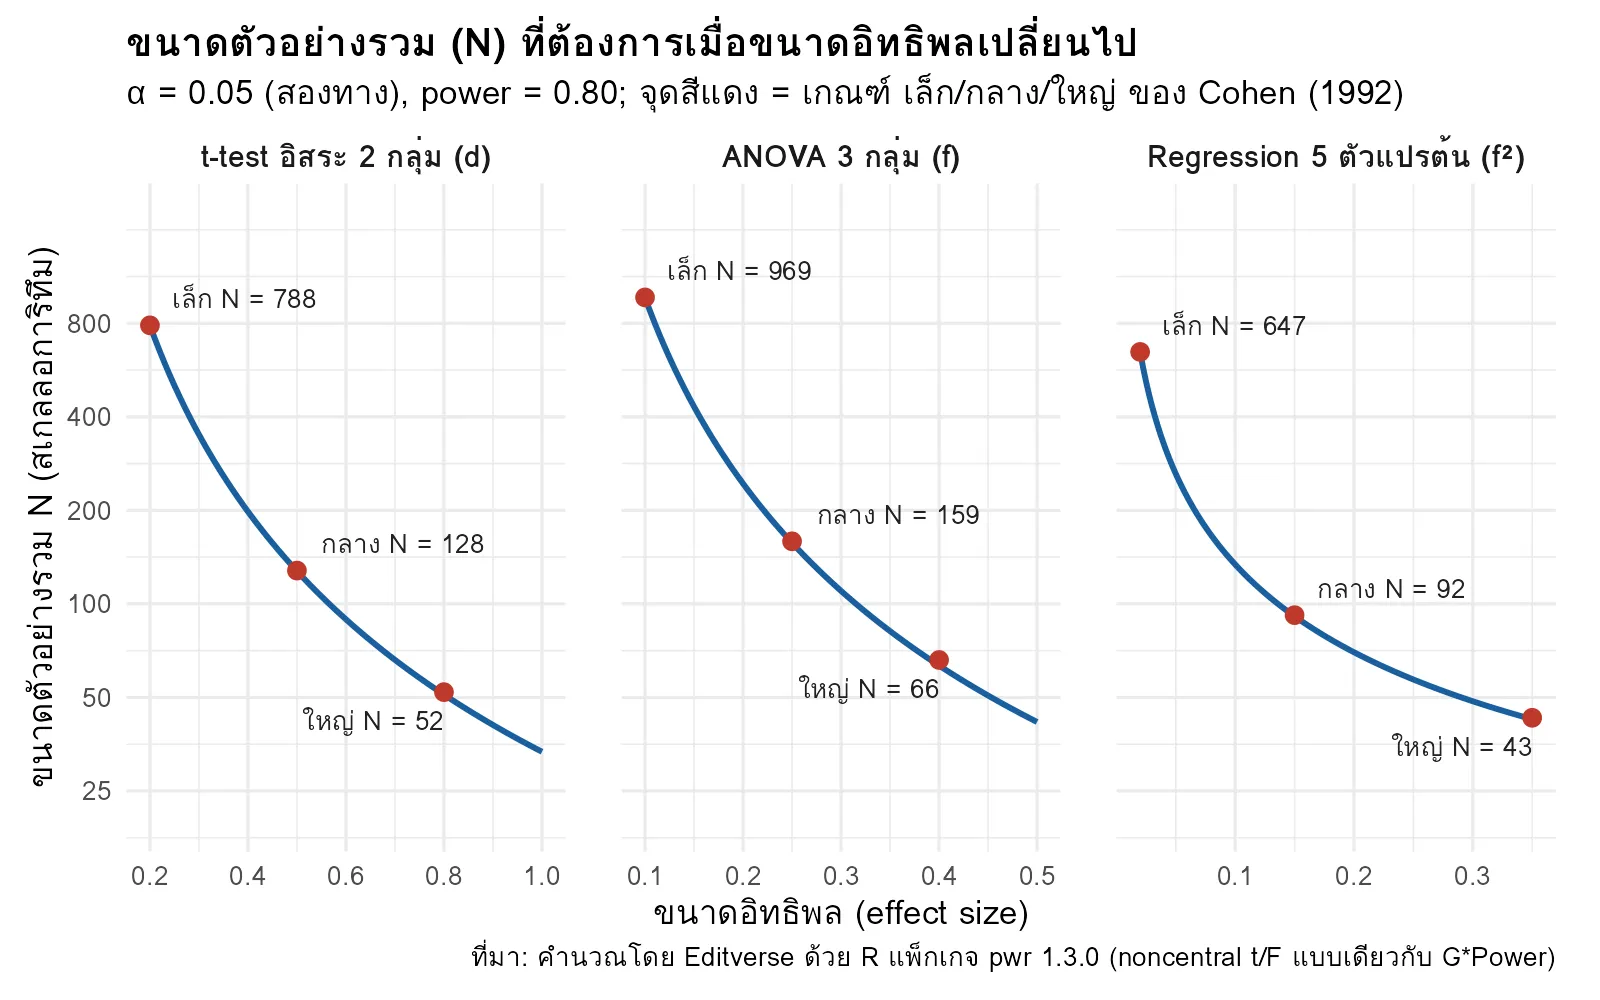
สรุปผลสามตัวอย่าง และการปรับจำนวนสำหรับผู้ถอนตัว
ตารางด้านล่างรวมค่าที่กรอกและผลลัพธ์ทั้งหมด คอลัมน์สุดท้ายปรับเพิ่มสำหรับผู้ถอนตัวหรือข้อมูลที่ใช้ไม่ได้ 10% ด้วยสูตร n ÷ (1 − 0.10) แล้วปัดขึ้น เช่น 64 ÷ 0.9 = 71.1 จึงเป็น 72 คนต่อกลุ่ม
| การทดสอบ | ค่าที่ใส่ใน G*Power | ผลลัพธ์ n | ปรับ dropout 10% |
|---|---|---|---|
| Independent t-test | d = 0.5, α = 0.05 สองทาง, power = 0.80, allocation 1:1 | 64 ต่อกลุ่ม (รวม 128) | 72 ต่อกลุ่ม (รวม 144) |
| Paired t-test | dz = 0.5, α = 0.05 สองทาง, power = 0.80 | 34 คู่ | 38 คู่ |
| One-way ANOVA 3 กลุ่ม | f = 0.25, α = 0.05, power = 0.80, groups = 3 | 53 ต่อกลุ่ม (รวม 159) | 59 ต่อกลุ่ม (รวม 177) |
| Multiple regression | f² = 0.15, α = 0.05, power = 0.80, predictors = 5 | 92 | 103 |
จากภาพที่ 2 จะเห็นว่าเส้นทั้งสามมีลักษณะเดียวกัน คือเมื่อ d หรือ f ลดลงครึ่งหนึ่ง จำนวนตัวอย่างเพิ่มขึ้นราวสี่เท่า (t-test จาก 128 เป็น 506 คน และ ANOVA จาก 159 เป็น 621 คน) ส่วน f² ซึ่งเป็นค่ากำลังสองอยู่แล้ว เมื่อลดลงครึ่งหนึ่งจำนวนจะเพิ่มราวสองเท่า (จาก 92 เป็น 177 คน) ดังนั้นการเลือกขนาดอิทธิพล “กลาง” โดยไม่มีเหตุผลรองรับ เพียงเพราะได้ตัวเลขที่เก็บข้อมูลไหว คือจุดที่กรรมการสอบโครงร่างและผู้ทบทวนวารสารมักตั้งคำถาม
อีกข้อหนึ่งที่ควรหลีกเลี่ยงคือการคำนวณ “post hoc power” จากขนาดอิทธิพลที่สังเกตได้หลังเก็บข้อมูลเสร็จ เพื่ออธิบายว่าผลที่ไม่มีนัยสำคัญเป็นเพราะตัวอย่างน้อย Hoenig และ Heisey (2001) ชี้ว่าค่า observed power ดังกล่าวเป็นฟังก์ชันของค่า p โดยตรง จึงไม่ได้ให้ข้อมูลใหม่ [6] สิ่งที่ควรรายงานแทนคือช่วงความเชื่อมั่นของขนาดอิทธิพล หรือการวิเคราะห์แบบ sensitivity ว่าด้วยจำนวนตัวอย่างที่มี การศึกษาสามารถตรวจพบผลขนาดเล็กที่สุดเท่าใด ซึ่ง G*Power ทำได้จากเมนูเดียวกัน [1] บทความทบทวนของ Kang (2021) ก็สรุปแนวคิดพื้นฐานและขั้นตอนการใช้ G*Power สำหรับการทดสอบที่พบบ่อยไว้ เป็นเอกสารประกอบที่ดีสำหรับผู้เริ่มต้น [7]
ตัวอย่างจริงจากงานวิจัยที่ตีพิมพ์: ตรวจตัวเลข G Power ด้วยตัวเอง
Latt และคณะ (2024) จากคณะพยาบาลศาสตร์ มหาวิทยาลัยมหิดล ศึกษาปัจจัยทำนายความตั้งใจหลีกเลี่ยงการใช้สารเสพติดของวัยรุ่นในเมืองปินลวง ประเทศเมียนมา ตีพิมพ์ใน BMC Public Health ส่วนวิธีวิจัยระบุว่าใช้ G*Power โดยคำนวณขนาดอิทธิพลจากค่าสหสัมพันธ์ r = 0.28 ของงานวิจัยก่อนหน้า กำหนด α = 0.05, power = 0.80, effect size = 0.08 และตัวแปรต้นห้าตัวในการถดถอยพหุคูณ ได้กลุ่มตัวอย่าง 157 คน และเก็บข้อมูลแบบสะดวก (convenience sampling) [8]
เมื่อเราตรวจซ้ำด้วย R พบประเด็นที่น่าสนใจ ถ้าใส่ f² = 0.08 ตรง ๆ จะได้ v = 159.97 หรือ n = 166 คน แต่ถ้าแปลง r = 0.28 ตามสูตร f² = r² / (1 − r²) = 0.0784 / 0.9216 = 0.0851 จะได้ v = 150.42 ปัดขึ้นเป็น 151 บวก 6 ได้ 157 คน พอดี และที่ n = 157 ถ้าขนาดอิทธิพลจริงเท่ากับ 0.08 power จะลดลงเหลือราว 0.77 แทน 0.80 แสดงว่าผู้วิจัยน่าจะใช้ค่า 0.085 ในโปรแกรมแต่รายงานแบบปัดเหลือ 0.08 ในบทความ
บทเรียนจากตัวอย่างนี้มีสามข้อ (1) ควรรายงานขนาดอิทธิพลด้วยทศนิยมที่ใช้จริงในโปรแกรม และแสดงสูตรแปลงจาก r หรือ R² (2) ระบุชื่อเมนูของ G*Power ให้ครบ เช่น “Fixed model, R² deviation from zero” เพื่อให้ผู้อ่านคำนวณซ้ำได้ (3) power analysis ตอบเพียงว่าจำนวนพอสำหรับการทดสอบหรือไม่ แต่ไม่ได้ทำให้กลุ่มตัวอย่างที่เลือกแบบสะดวกเป็นตัวแทนของประชากร ประเด็นนี้ต้องอภิปรายแยกในข้อจำกัดของการศึกษา ข้อสังเกตเหล่านี้ไม่ได้ลดคุณค่าของงานวิจัยดังกล่าว แต่แสดงให้เห็นว่าการรายงานที่ละเอียดช่วยให้ตรวจสอบได้จริง
บริบทไทย: ทำไมวิทยานิพนธ์ไทยจึงหันมาใช้ G Power
ในวงการวิจัยไทย สูตรของ Taro Yamane และตาราง Krejcie & Morgan ถูกใช้อย่างแพร่หลาย สิทธิพรร์ สุนทร และคณะ (2019) แห่งมหาวิทยาลัยราชภัฏมหาสารคาม ตั้งข้อสังเกตในวารสาร Thai Interdisciplinary and Sustainability Review ว่าสูตรและตารางสำเร็จรูปเหล่านี้มักถูกนำไปใช้ ทั้งที่มาตรวัดในการวิจัยไม่ใช่ตัวแปรแบบสองตัวเลือก และเสนอ G*Power เป็นแนวทางกำหนดขนาดตัวอย่างสำหรับการวิจัยเชิงปริมาณ [9] ล่าสุด Mahidol R2R e-Journal ก็ตีพิมพ์บทความวิชาการภาษาไทยเรื่อง “การคำนวณขนาดตัวอย่างด้วยโปรแกรมสำเร็จรูป G*POWER” (2025) ซึ่งเลข DOI ของบทความชี้ไปยังระบบ DOI ของสำนักงานการวิจัยแห่งชาติ (วช.) ที่ doi.nrct.go.th [10]
หลักง่าย ๆ คือ ถ้าเป้าหมายคือ ประมาณค่าสัดส่วนของประชากรที่ทราบจำนวน สูตร Yamane หรือตาราง Krejcie & Morgan ยังใช้ได้ แต่ถ้าเป้าหมายคือ ทดสอบสมมติฐาน เช่น เปรียบเทียบค่าเฉลี่ยหรือหาตัวทำนาย ควรใช้ power analysis อย่าง G*Power (การเลือกระหว่างสามวิธีนี้เราอธิบายละเอียดในบทความเปรียบเทียบแยกต่างหาก) สำหรับงานวิจัยทางคลินิก แนวทาง CONSORT 2025 ข้อ 16a กำหนดให้รายงาน “วิธีกำหนดขนาดตัวอย่าง รวมถึงสมมติฐานทั้งหมดที่ใช้สนับสนุนการคำนวณ” [11] และหากเป็นการทดลองทางคลินิกในไทย ข้อมูลชุดเดียวกันนี้ควรสอดคล้องกับที่ลงทะเบียนไว้ใน TCTR
ตัวอย่างย่อหน้าสำหรับบทที่ 3:
“คำนวณขนาดกลุ่มตัวอย่างด้วยโปรแกรม G*Power 3.1.9.7 (Faul et al., 2007; 2009) เลือก t tests – Means: Difference between two independent means แบบ a priori กำหนดการทดสอบสองทาง α = 0.05, power = 0.80 และขนาดอิทธิพล d = 0.50 ซึ่งคำนวณจากค่าเฉลี่ยและส่วนเบี่ยงเบนมาตรฐานในงานวิจัยของ [ผู้แต่ง, ปี] ได้กลุ่มละ 64 คน รวม 128 คน เพิ่มอีกร้อยละ 10 เพื่อชดเชยการถอนตัว จึงใช้กลุ่มละ 72 คน รวม 144 คน”
ย่อหน้านี้มีครบทุกค่าที่ผู้อ่านต้องใช้คำนวณซ้ำ ได้แก่ ชื่อและเวอร์ชันโปรแกรม เมนูที่เลือก ทิศทางการทดสอบ α, power, ขนาดอิทธิพลพร้อมที่มา และการปรับสำหรับผู้ถอนตัว
สรุป
- ระบุ การทดสอบหลัก ที่ตอบสมมติฐานข้อหลัก และเลือกเมนูใน G*Power ให้ตรงกับการทดสอบนั้น
- ใช้ A priori สำหรับการวางแผน ไม่ใช้ post hoc power อธิบายผลที่ไม่มีนัยสำคัญ
- กำหนด α (และสองทางหรือทางเดียว) กับ power ให้ชัด ค่าทั่วไปคือ 0.05 สองทาง และ 0.80
- คำนวณ ขนาดอิทธิพลจากข้อมูลจริง (งานก่อนหน้า การศึกษานำร่อง) และแสดงสูตรแปลง ใช้ค่าอ้างอิงของ Cohen เมื่อไม่มีข้อมูลอื่นเท่านั้น
- ตรวจคำตอบ: t-test d = 0.5 ได้ 64 ต่อกลุ่ม, ANOVA 3 กลุ่ม f = 0.25 ได้ 159, regression 5 ตัวแปร f² = 0.15 ได้ 92
- ปรับเพิ่มสำหรับผู้ถอนตัว ด้วย n ÷ (1 − อัตราถอนตัว) และปัดขึ้น
- รายงานชื่อ เวอร์ชันโปรแกรมและทุกค่าที่กรอก ให้คำนวณซ้ำได้ และอ้างอิง Faul et al. (2007; 2009)
หากต้องการให้ผู้เชี่ยวชาญตรวจว่าการคำนวณขนาดตัวอย่าง เมนูที่เลือก และย่อหน้าบทที่ 3 สอดคล้องกับแบบแผนการวิจัยและแผนการวิเคราะห์ของคุณหรือไม่ บริการวิเคราะห์สถิติของ Editverse มีบรรณาธิการที่จบปริญญาเอกหรือแพทยศาสตรบัณฑิตในสาขาของคุณช่วยตรวจทานและให้ข้อเสนอแนะ เราแก้ไขและยกระดับงานของคุณ เราไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
G*Power ต้องใช้ค่าอะไรบ้าง
ชนิดของการทดสอบ ระดับนัยสำคัญ α อำนาจการทดสอบ และขนาดอิทธิพล โดยใช้โหมด A priori สำหรับการวางแผนก่อนเก็บข้อมูล
ตัวอย่างในบทความได้ขนาดตัวอย่างเท่าไร
ที่ α = 0.05 และ power = 0.80 t-test ที่ d = 0.5 ได้ 64 คนต่อกลุ่ม ANOVA 3 กลุ่มที่ f = 0.25 ได้ 159 คน และ regression 5 ตัวแปรที่ f² = 0.15 ได้ 92 คน
ปรับเพิ่มสำหรับผู้ถอนตัวอย่างไร
ใช้ n ÷ (1 − อัตราถอนตัว) แล้วปัดขึ้น เช่น 64 ÷ 0.9 = 71.1 จึงเป็น 72 คนต่อกลุ่ม
เอกสารอ้างอิง
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. doi:10.3758/bf03193146 PMID: 17695343
- Heinrich-Heine-Universität Düsseldorf. (n.d.). G*Power: Statistical power analyses for Mac and Windows. https://www.psychologie.hhu.de/arbeitsgruppen/allgemeine-psychologie-und-arbeitspsychologie/gpower
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. doi:10.1037/0033-2909.112.1.155
- Champely, S., et al. (2020). pwr: Basic functions for power analysis (R package version 1.3-0). The Comprehensive R Archive Network. doi:10.32614/CRAN.package.pwr (https://CRAN.R-project.org/package=pwr)
- Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160. doi:10.3758/BRM.41.4.1149 PMID: 19897823
- Hoenig, J. M., & Heisey, D. M. (2001). The abuse of power. The American Statistician, 55(1), 19–24. doi:10.1198/000313001300339897
- Kang, H. (2021). Sample size determination and power analysis using the G*Power software. Journal of Educational Evaluation for Health Professions, 18, 17. doi:10.3352/jeehp.2021.18.17 PMID: 34325496
- Latt, N. N. N., Putdivarnichapong, W., Phetrasuwan, S., & Vongsirimas, N. (2024). Factors predicting the intention of drug abuse avoidance among adolescents in Pinlaung Township, Myanmar: Predictive correlational design. BMC Public Health, 24(1), 8. doi:10.1186/s12889-023-17419-4 PMID: 38166869
- สิทธิพรร์ สุนทร, วัชรินทร์ สุทธิศัย, พงษ์ศักดิ์ ซิมมอนด์ส, รัชนิดา ไสยรส, และ ภัณฑิลา น้อยเจริญ. (2019). แนวคิด และกระบวนทัศน์ในการกำหนดขนาดตัวอย่างด้วย G*Power. Thai Interdisciplinary and Sustainability Review, 8(S), 29–39. https://so03.tci-thaijo.org/index.php/JIRGS/article/view/243622
- ศักดิ์ชัย จันทะแสง. (2025). การคำนวณขนาดตัวอย่างด้วยโปรแกรมสำเร็จรูป G*POWER. Mahidol R2R e-Journal, 12(2), 30–43. doi:10.14456/jmu.2025.17
- Hopewell, S., Chan, A.-W., Collins, G. S., Hróbjartsson, A., Moher, D., Schulz, K. F., et al. (2025). CONSORT 2025 statement: Updated guideline for reporting randomised trials. BMJ, 389, e081123. doi:10.1136/bmj-2024-081123 PMID: 40228833
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ