ขนาดกลุ่มตัวอย่าง: เลือก Yamane, Krejcie & Morgan หรือ G*Power
การกำหนดขนาดกลุ่มตัวอย่างที่ถูกต้องเริ่มจากคำถามวิจัย ไม่ใช่จากสูตร ถ้าต้องการประมาณค่าสัดส่วนในประชากรให้ใช้ Yamane หรือ Krejcie & Morgan แต่ถ้าต้องการเปรียบเทียบกลุ่ม หาความสัมพันธ์ หรือทดสอบสมมติฐาน ต้องใช้การวิเคราะห์อำนาจการทดสอบ (power analysis) เช่น G*Power ที่กำหนดขนาดอิทธิพล ค่า α = 0.05 และอำนาจ 0.80
ทำไมการเลือกวิธีกำหนดขนาดกลุ่มตัวอย่างจึงไม่ใช่เรื่องของความชอบ
บทที่ 3 ของวิทยานิพนธ์ไทยจำนวนมากเขียนว่า “ใช้สูตรของ Taro Yamane ที่ความคลาดเคลื่อน 5%” แล้วนำตัวเลขนั้นไปใช้กับ t-test, ANOVA หรือการถดถอยในบทที่ 4 ทั้งที่สูตรกลุ่มนี้กับการวิเคราะห์อำนาจการทดสอบตั้งอยู่บนปรัชญาคนละแบบ
วัลลภ รัฐฉัตรานนท์ (2562) แห่งคณะสังคมศาสตร์ มหาวิทยาลัยเกษตรศาสตร์ อธิบายไว้ชัดเจนว่าสูตรของ Yamane และ Krejcie & Morgan มาจาก ทฤษฎีการสำรวจตัวอย่าง (theory of sample survey) ตามแนวทางของ Cochran ซึ่งพิจารณาจาก margin of error ที่ยอมรับได้ ขณะที่งานวิจัยเชิงสหสัมพันธ์และงานวิจัยเชิงทดลองต้องกำหนดขนาดตัวอย่างให้มี อำนาจการทดสอบ (statistical power) สูงพอ ตามแนวทางของ Jacob Cohen ซึ่งใช้ทฤษฎีสถิติอนุมานเป็นฐาน ผู้เขียนจึงสรุปว่าการนำสูตรสำรวจไปใช้กับงานประเภทหลังเป็น “เรื่องที่ผิดฝาผิดตัว” [1]
มุมมองนี้สอดคล้องกับวรรณกรรมระดับนานาชาติ Lakens (2022) จำแนกวิธีให้เหตุผลเรื่องขนาดตัวอย่างไว้หกแนวทาง ได้แก่ เก็บข้อมูลจากประชากร (เกือบ) ทั้งหมด เลือกตามข้อจำกัดของทรัพยากร วิเคราะห์อำนาจการทดสอบล่วงหน้า (a-priori power analysis) วางแผนตามความแม่นยำที่ต้องการ ใช้กฎหัวแม่มือ และยอมรับตรง ๆ ว่าไม่มีเหตุผลรองรับ [2] สูตร Yamane และตาราง Krejcie & Morgan จัดอยู่ในกลุ่ม “วางแผนตามความแม่นยำ” ส่วน G*Power คือเครื่องมือของกลุ่ม “วิเคราะห์อำนาจการทดสอบ” ทั้งสองถูกต้องเมื่อใช้ตอบคำถามที่ตรงกับตัวมันเอง
Yamane, Krejcie & Morgan และ G*Power ตอบคำถามต่างกันอย่างไร
ตาราง Krejcie & Morgan (1970) ตีพิมพ์ในวารสาร Educational and Psychological Measurement และสร้างจากสูตรที่กำหนดค่าไคสแควร์ที่องศาอิสระ 1 เท่ากับ 3.841 สัดส่วนประชากร P = 0.50 และระดับความแม่นยำ d = 0.05 ไว้ล่วงหน้า [3] ผลที่ได้จึงแทบเท่ากับสูตร Yamane ที่ใช้ z ≈ 2 และ p = 0.5 เช่นกัน ทั้งสองวิธีจึงเป็น “เครื่องมือเดียวกันในรูปแบบต่างกัน” คือบอกว่าต้องเก็บกี่คนเพื่อประมาณ สัดส่วน ของประชากรที่ทราบจำนวนให้คลาดเคลื่อนไม่เกินค่าที่กำหนด (รายละเอียดการคำนวณแต่ละวิธีอยู่ในบทความแยกของเราเรื่องสูตร Taro Yamane และตาราง Krejcie & Morgan)
G*Power เป็นโปรแกรมฟรีที่พัฒนาโดยกลุ่มวิจัยของ Heinrich-Heine-Universität Düsseldorf ประเทศเยอรมนี ใช้คำนวณอำนาจการทดสอบสำหรับ t-test, F-test, χ² test, z test และ exact test หลายชนิด [4] รายละเอียดเชิงวิธีการตีพิมพ์ไว้ในบทความสองฉบับที่ผู้พัฒนาขอให้อ้างอิงเมื่อใช้โปรแกรม คือ Faul และคณะ (2007) สำหรับ G*Power 3 และ Faul และคณะ (2009) สำหรับการขยายไปยังการวิเคราะห์สหสัมพันธ์และการถดถอยใน G*Power 3.1 [5, 6] คำถามที่ G*Power ตอบคือ “ถ้าผลที่เราสนใจมีอยู่จริงในขนาดนี้ ต้องเก็บตัวอย่างกี่คนจึงมีโอกาสตรวจพบอย่างน้อย 80%”
| วิธี | ตอบคำถามแบบใด | ค่าที่ต้องกำหนด | เหมาะกับ |
|---|---|---|---|
| Taro Yamane | ประมาณค่าสัดส่วนของประชากรให้คลาดเคลื่อนไม่เกิน ±e | N และ e (ความเชื่อมั่น 95% และ p = 0.5 ถูกล็อกไว้ในสูตร) | งานสำรวจเชิงบรรยาย ประชากรทราบจำนวน สุ่มแบบอาศัยความน่าจะเป็น |
| Krejcie & Morgan | เหมือนกัน (ประมาณค่าสัดส่วน) | N (ตารางกำหนด χ² = 3.841, P = 0.50, d = 0.05 ไว้แล้ว) | งานสำรวจเชิงบรรยายแบบเดียวกัน ต้องการเปิดตารางแทนการคำนวณ |
| G*Power (power analysis) | มีตัวอย่างพอที่จะตรวจพบผลที่มีอยู่จริงหรือไม่ | สถิติทดสอบ ขนาดอิทธิพล α อำนาจการทดสอบ และจำนวนกลุ่มหรือตัวแปรทำนาย | การเปรียบเทียบกลุ่ม ความสัมพันธ์ การทำนาย และงานทดลอง |
สังเกตว่า Yamane และ Krejcie & Morgan ไม่มีช่องให้ใส่สถิติทดสอบหรือขนาดผลต่างที่คาดไว้ ตัวเลขจึงเท่าเดิมไม่ว่าจะใช้ t-test, ANOVA หรือ regression ซึ่งบอกว่าวิธีนี้ไม่ได้ออกแบบมาเพื่อการทดสอบสมมติฐาน
ผังตัดสินใจเลือกวิธีกำหนดขนาดกลุ่มตัวอย่าง
ก่อนเปิดตารางหรือโปรแกรมใด ๆ ให้เขียนคำถามวิจัยหลักออกมาเป็นประโยคเดียว แล้วถามว่า “ประโยคนี้ต้องการ ประมาณค่า หรือ ทดสอบ” ภาพที่ 1 สรุปลำดับการตัดสินใจที่ใช้ได้กับวิทยานิพนธ์และบทความส่วนใหญ่
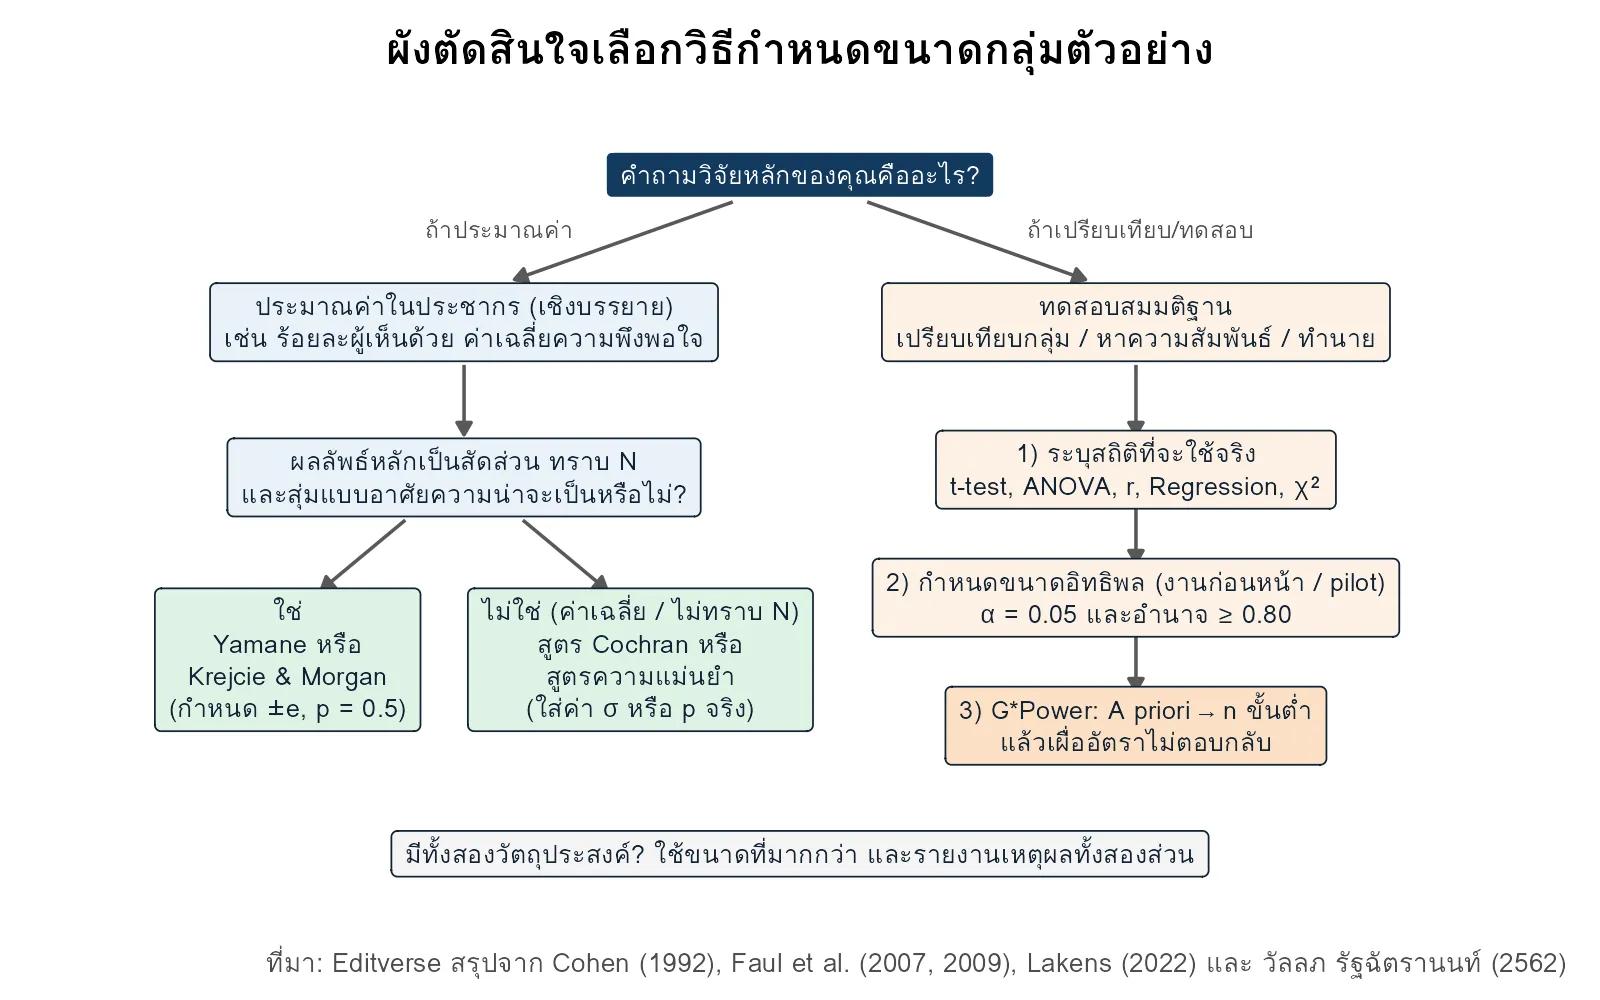
- ประมาณค่าเชิงบรรยาย เช่น ร้อยละผู้สูงอายุที่มีสมาร์ตโฟน ถ้าผลลัพธ์เป็นสัดส่วน ทราบ N และสุ่มแบบอาศัยความน่าจะเป็น ใช้ Yamane หรือ Krejcie & Morgan ได้ ถ้าเป็นค่าเฉลี่ยหรือไม่ทราบ N ใช้สูตรความแม่นยำที่ใส่ค่าส่วนเบี่ยงเบนมาตรฐานหรือสัดส่วนจากงานก่อนหน้า
- ทดสอบสมมติฐาน เช่น เปรียบเทียบกลุ่ม หาความสัมพันธ์ หรือทำนาย ให้ระบุสถิติที่จะใช้จริงในบทที่ 4 ก่อน แล้วกำหนดขนาดอิทธิพล α และอำนาจการทดสอบ จากนั้นใช้ G*Power แบบ A priori คำนวณขนาดขั้นต่ำ
- มีทั้งสองวัตถุประสงค์ ให้คำนวณทั้งสองแบบ ใช้ค่าที่มากกว่า และอธิบายเหตุผลทั้งสองส่วนในบทที่ 3
ขนาดอิทธิพล α และอำนาจ 0.80: สามค่าที่ต้องกำหนดก่อนเปิด G*Power
การวิเคราะห์อำนาจการทดสอบเชื่อมโยงสี่ปริมาณเข้าด้วยกัน ได้แก่ ขนาดตัวอย่าง ขนาดอิทธิพล ระดับนัยสำคัญ (α) และอำนาจการทดสอบ (1 − β) เมื่อกำหนดสามค่าก็หาค่าที่สี่ได้ [7] ในการวางแผนล่วงหน้าเรากำหนดสามค่าแรกเพื่อหาขนาดตัวอย่าง
1) ระดับนัยสำคัญ α
โดยทั่วไปใช้ 0.05 แบบสองทาง ซึ่งหมายถึงยอมรับโอกาสสรุปผิดว่ามีผลต่าง ทั้งที่ไม่มีจริง (Type I error) ได้ไม่เกิน 5%
2) อำนาจการทดสอบ 0.80
อำนาจ 0.80 หมายความว่าถ้าผลที่สนใจมีอยู่จริง การศึกษามีโอกาส 80% ที่จะตรวจพบ และยอมรับโอกาส 20% ที่จะพลาด (Type II error) Cohen (1992) ใช้ค่า 0.80 เป็นฐานของตารางขนาดตัวอย่างสำหรับการทดสอบมาตรฐานแปดชนิดในบทความ “A power primer” [8] ค่านี้จึงเป็นค่าขั้นต่ำที่ใช้กันแพร่หลาย บางสาขาหรือบางโครงการกำหนดสูงกว่านั้น เช่น 0.90 หรือ 0.95 ซึ่งจะต้องใช้ตัวอย่างมากขึ้นตามลำดับ
3) ขนาดอิทธิพล (effect size)
นี่คือค่าที่ยากที่สุดและส่งผลต่อขนาดตัวอย่างมากที่สุด Cohen (1992) เสนอค่าอ้างอิงระดับเล็ก กลาง และใหญ่ สำหรับดัชนีแต่ละชนิด [8] ดังตารางด้านล่าง
| สถิติทดสอบ | ดัชนีขนาดอิทธิพล | เล็ก | กลาง | ใหญ่ |
|---|---|---|---|---|
| เปรียบเทียบค่าเฉลี่ย 2 กลุ่ม (t-test) | d | 0.20 | 0.50 | 0.80 |
| สหสัมพันธ์ (Pearson) | r | 0.10 | 0.30 | 0.50 |
| One-way ANOVA | f | 0.10 | 0.25 | 0.40 |
| Multiple regression | f² | 0.02 | 0.15 | 0.35 |
ค่าอ้างอิงเหล่านี้ไม่ควรถูกเลือกแบบอัตโนมัติ Lakens (2022) แนะนำให้ผู้วิจัยระบุว่าคาดหวังขนาดอิทธิพลเท่าใดและอาศัยข้อมูลอะไร เช่น งานวิจัยก่อนหน้าในบริบทใกล้เคียง การศึกษานำร่อง หรือขนาดผลที่เล็กที่สุดที่ยังมีความหมายในทางปฏิบัติ (smallest effect size of interest) [2] หากเลือก “ใหญ่” เพียงเพราะทำให้ได้ตัวเลขน้อย การศึกษาจะมีอำนาจต่ำเมื่อผลจริงมีขนาดเล็กกว่านั้น Button และคณะ (2013) ชี้ว่าการศึกษาที่อำนาจต่ำไม่ได้มีปัญหาแค่ตรวจไม่พบผล แต่ยังลดโอกาสที่ผลซึ่ง “มีนัยสำคัญ” จะสะท้อนผลที่มีอยู่จริง ทำให้ประมาณขนาดผลสูงเกินจริงและทำซ้ำได้ยาก [9]
ตัวอย่างการคำนวณขนาดกลุ่มตัวอย่าง: ประชากรครู 1,000 คน
สมมติว่านักศึกษาปริญญาโทสาขาบริหารการศึกษามีรายชื่อครูในเขตพื้นที่การศึกษาแห่งหนึ่งครบ 1,000 คน และมีคำถามวิจัยหลายข้อ ตารางนี้แสดงว่าแต่ละคำถามต้องการขนาดตัวอย่างต่างกันมาก แม้ประชากรจะเป็นกลุ่มเดียวกัน ค่าในแถวที่ 2–6 คำนวณด้วยแพ็กเกจ pwr ใน R ที่ α = 0.05 แบบสองทาง และปัดขึ้นเป็นจำนวนเต็ม ซึ่งให้ผลตรงกับ G*Power ยกเว้นสหสัมพันธ์ที่ pwr (ประมาณด้วย Fisher z) ให้ 85 คน ส่วน G*Power แบบ exact ที่เราตรวจด้วยการคำนวณเองให้ 84 คน
| คำถามวิจัย | สถิติที่จะใช้ | ค่าที่กำหนด | ขนาดขั้นต่ำ |
|---|---|---|---|
| ร้อยละครูที่ใช้สื่อดิจิทัลทุกสัปดาห์ (ประมาณค่า) | สัดส่วน | N = 1,000, e = 0.05 | 286 (Yamane) / 278 (Krejcie & Morgan) |
| ความพึงพอใจในงานต่างกันระหว่างครูโรงเรียนรัฐกับเอกชนหรือไม่ | Independent t-test | d = 0.30, α = 0.05, อำนาจ 0.80 | 176 ต่อกลุ่ม (รวม 352) |
| คำถามเดียวกัน แต่คาดว่าผลต่างระดับกลาง | Independent t-test | d = 0.50, α = 0.05, อำนาจ 0.80 | 64 ต่อกลุ่ม (รวม 128) |
| ความพึงพอใจต่างกันตามขนาดโรงเรียน 4 ขนาดหรือไม่ | One-way ANOVA | f = 0.25, k = 4, α = 0.05, อำนาจ 0.80 | 45 ต่อกลุ่ม (รวม 180) |
| ภาระงานสัมพันธ์กับความเหนื่อยล้าหรือไม่ | Pearson correlation | r = 0.30, α = 0.05, อำนาจ 0.80 | 85 |
| ตัวแปรทำนาย 4 ตัวอธิบายความตั้งใจลาออกได้หรือไม่ | Multiple regression | f² = 0.15, 4 ตัวทำนาย, α = 0.05, อำนาจ 0.80 | 85 |
วิธีอ่านตาราง:
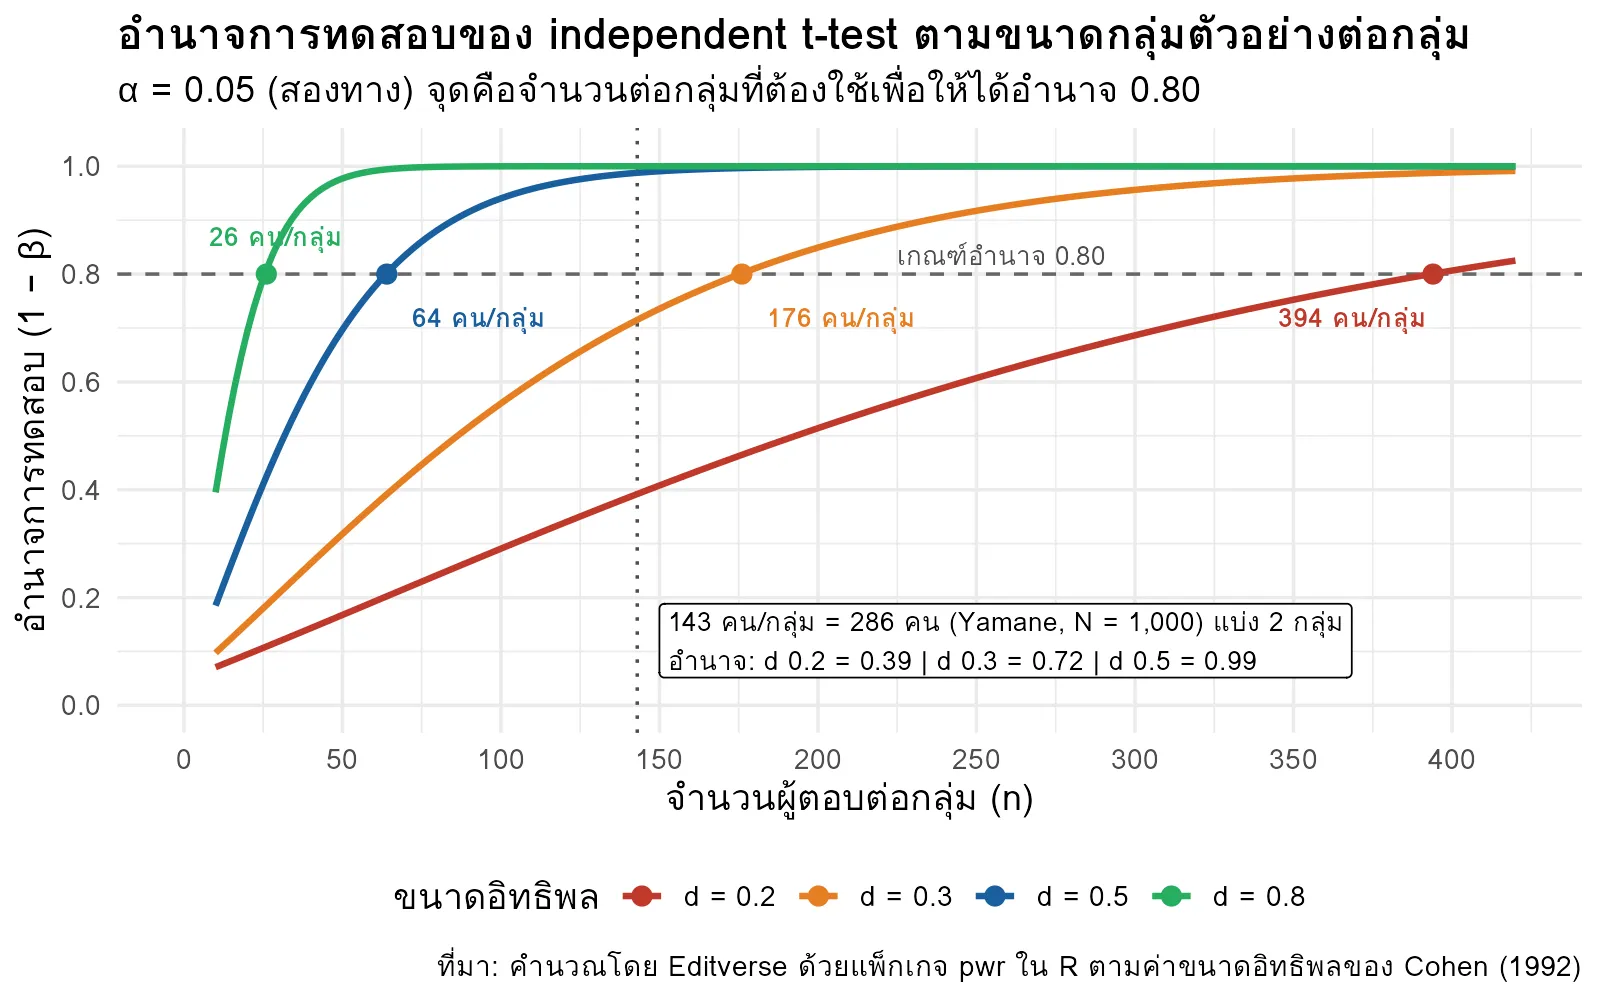
- ถ้าใช้ Yamane แล้วจบ นักศึกษาจะเก็บ 286 คน หากแบ่งเป็นครูรัฐและเอกชนกลุ่มละ 143 คนเท่ากันพอดี อำนาจในการตรวจพบผลต่างขนาด d = 0.30 จะอยู่ที่ประมาณ 0.72 และถ้าผลจริงเล็กเพียง d = 0.20 อำนาจจะเหลือราว 0.39 นั่นคือมีโอกาสมากกว่าครึ่งที่จะสรุปว่า “ไม่แตกต่าง” ทั้งที่แตกต่างจริง (ภาพที่ 2)
- ตัวเลขจาก Yamane ไม่ได้ “เผื่อไว้ก่อน” เสมอ สำหรับ ANOVA สี่กลุ่มหรือสหสัมพันธ์ระดับกลาง 286 คนเกินพอ แต่สำหรับผลต่างขนาดเล็กระหว่างสองกลุ่มกลับไม่พอ จึงต้องคำนวณตามสถิติจริง
- สัดส่วนกลุ่มย่อยสำคัญ ถ้าครูเอกชนมีเพียงราว 15% ของประชากร การสุ่มอย่างง่าย 286 คนจะได้ครูเอกชนประมาณ 43 คน ซึ่งต่ำกว่า 176 มาก ควรใช้การสุ่มแบบแบ่งชั้นและกำหนดจำนวนต่อกลุ่มตามผลการวิเคราะห์อำนาจ
ขั้นสุดท้าย: เผื่อการไม่ตอบกลับ ขนาดจาก G*Power คือจำนวนข้อมูลที่วิเคราะห์ได้จริง หากคาดว่าอัตราตอบกลับเท่ากับ 80% สำหรับคำถาม t-test ที่ d = 0.30 ต้องแจก 352 ÷ 0.80 = 440 ชุด แล้วรายงานอัตราตอบกลับจริงในบทที่ 4
กฎการตัดสินใจ: คำนวณขนาดสำหรับทุกคำถามที่ใช้ทดสอบสมมติฐานหลัก เลือกค่าที่มากที่สุด ตรวจว่าทุกกลุ่มย่อยได้จำนวนพอ แล้วปรับสำหรับการไม่ตอบกลับ หากค่าที่ได้เกินทรัพยากรที่มี ให้ทำ sensitivity analysis เพื่อรายงานว่าขนาดตัวอย่างที่เก็บได้จริงตรวจพบผลขนาดเล็กที่สุดเท่าใดที่อำนาจ 0.80 [2]
ทำไมผู้ทบทวนจึงทักท้วงเมื่อใช้ Yamane กับงานวิจัยเชิงเปรียบเทียบ
วัลลภ รัฐฉัตรานนท์ (2562) สรุปข้อจำกัดของสูตร Yamane และ Krejcie & Morgan ไว้เจ็ดข้อ แต่ละข้อเป็นจุดที่กรรมการสอบหรือผู้ทบทวนบทความสามารถใช้ตั้งคำถามกับบทที่ 3 ได้ทันที [1]
- ใช้สำหรับการวิจัยเชิงสำรวจเท่านั้น ไม่ใช่งานวิจัยเชิงสหสัมพันธ์หรือเชิงทดลอง
- ใช้กับการประมาณค่าสัดส่วนของตัวแปรสองค่า (Bernoulli) เช่น ใช่/ไม่ใช่ ไม่ใช่ค่าเฉลี่ยหรือความแปรปรวน
- สมมติว่าสัดส่วนเท่ากับ 0.5 ซึ่งให้ความแปรปรวนสูงสุด
- ใช้ได้กับประชากรที่ทราบจำนวนแน่นอน (finite population) เท่านั้น
- ใช้ได้เมื่อเลือกตัวอย่างแบบสุ่มที่อาศัยความน่าจะเป็น
- ตารางชุดเดียวถูกนำไปใช้กับสถิติทดสอบทุกชนิด ซึ่งไม่น่าจะถูกต้อง
- ใช้ค่า z โดยประมาณ (เช่น 2 แทน 1.96) ทำให้ผลคำนวณคลาดเคลื่อน
ผู้เขียนเตือนด้วยว่าหากผู้อ่านพบข้อบกพร่องเพียงประเด็นเดียวในรายงานวิจัย จะส่งผลให้งานทั้งฉบับขาดความน่าเชื่อถือทันที [1] สำหรับงานที่ส่งวารสารนานาชาติ มาตรฐานการรายงานก็ระบุเรื่องนี้ไว้ชัด เช่น แนวทาง CONSORT 2010 สำหรับการทดลองแบบสุ่มมีข้อ 7a กำหนดให้รายงาน “How sample size was determined” [10] ซึ่งผู้ทบทวนคาดหวังให้เห็นสถิติทดสอบ ขนาดอิทธิพลและที่มา α และอำนาจการทดสอบ ไม่ใช่เพียงชื่อสูตรสำรวจ ข้อความ “ใช้สูตร Yamane ได้ 286 คน” ในงานที่ทดสอบผลของโปรแกรมการสอนจึงเปิดช่องให้ถามทันทีว่า 286 คนมีอำนาจพอสำหรับการวิเคราะห์ที่รายงานหรือไม่
บริบทไทย: ตัวอย่างจริงจากบทความในวารสาร TCI
ในวงวิชาการไทย การถกเถียงเรื่องนี้ปรากฏในวารสารที่อยู่ในฐาน TCI อย่างต่อเนื่อง นอกจากบทความของวัลลภ รัฐฉัตรานนท์ (2562) ในวารสารสหวิทยาการวิจัย: ฉบับบัณฑิตศึกษา ที่ตั้งชื่ออย่างตรงไปตรงมาว่าเป็น “มายาคติ” ในการใช้สูตรของ Yamane และ Krejcie & Morgan [1] ยังมีบทความของศักดิ์ชัย จันทะแสง (2568) จากมหาวิทยาลัยเทคโนโลยีราชมงคลกรุงเทพ ใน Mahidol R2R e-Journal ที่สรุปการใช้ G*Power เป็นห้าขั้นตอน ได้แก่ เลือกกลุ่มของสถิติ เลือกสถิติทดสอบ ระบุประเภทการวิเคราะห์อำนาจ ใส่ค่าพารามิเตอร์ (α อำนาจการทดสอบ และขนาดอิทธิพล) และกดคำนวณ [11] บทความนี้มี DOI ของไทย 10.14456/jmu.2025.17 ซึ่งลิงก์ไปยังระบบ DOI ของสำนักงานการวิจัยแห่งชาติ (วช.)
ตารางที่ 4 ในบทความของศักดิ์ชัยรวบรวมตัวอย่างงานวิจัยไทยปี 2563–2565 จำนวน 10 เรื่องที่ใช้ G*Power ทั้งหมดใช้ α = 0.05 โดย 4 เรื่องกำหนดอำนาจ 0.80 และ 6 เรื่องกำหนด 0.95 และงานที่ใช้ t-test (บางเรื่องเป็น paired หรือ dependent t-test) 3 เรื่องกำหนดขนาดอิทธิพลไว้ที่ 0.70–0.80 ซึ่งให้ขนาดตัวอย่างที่คำนวณได้เพียง 23–34 คน โดยผู้วิจัยเก็บข้อมูลจริงมากกว่านั้น เช่น 40 คน หรือกลุ่มละ 30 คน [11] ตัวอย่างนี้มีประโยชน์สองทาง ด้านหนึ่งแสดงว่าการรายงาน α อำนาจ และขนาดอิทธิพลอย่างครบถ้วนกลายเป็นแนวปฏิบัติที่พบได้ในงานไทย อีกด้านหนึ่งเตือนว่าค่า d = 0.80 จัดเป็นผล “ใหญ่” ตามเกณฑ์ของ Cohen [8] หากไม่มีหลักฐานจากงานก่อนหน้าว่าผลน่าจะใหญ่ขนาดนั้น ผู้ทบทวนอาจขอให้อธิบายที่มาของค่า ภาพที่ 2 แสดงว่าที่กลุ่มละ 30 คน อำนาจในการตรวจพบผลขนาด d = 0.50 มีเพียงประมาณ 0.48
วิธีเขียนเหตุผลของขนาดกลุ่มตัวอย่างในบทที่ 3 หรือส่วน Methods
Kang (2021) อ้างหลักของคณะกรรมการบรรณาธิการวารสารการแพทย์นานาชาติ (ICMJE) ว่าวิธีทางสถิติต้องเขียนละเอียดพอให้ผู้อ่านที่มีความรู้ตรวจสอบผลได้ และชี้ว่าหลักเดียวกันใช้กับการคำนวณขนาดตัวอย่าง โดยต้องระบุสมมติฐาน ขนาดอิทธิพล α และอำนาจการทดสอบ [7] ตัวอย่างข้อความภาษาไทยสำหรับคำถาม t-test ข้างต้น
กำหนดขนาดกลุ่มตัวอย่างด้วยการวิเคราะห์อำนาจการทดสอบล่วงหน้าโดยใช้โปรแกรม G*Power 3.1 (Faul et al., 2009) สำหรับ independent t-test แบบสองทาง กำหนดขนาดอิทธิพล d = 0.30 อ้างอิงจาก [งานวิจัยก่อนหน้าที่ใกล้เคียง] ระดับนัยสำคัญ 0.05 และอำนาจการทดสอบ 0.80 ได้ขนาดขั้นต่ำกลุ่มละ 176 คน รวม 352 คน เผื่ออัตราไม่ตอบกลับร้อยละ 20 จึงแจกแบบสอบถาม 440 ชุด โดยสุ่มแบบแบ่งชั้นตามประเภทโรงเรียน
สำหรับบทความภาษาอังกฤษ ใช้โครงสร้างเดียวกัน: “An a priori power analysis (G*Power 3.1) indicated that 176 participants per group were required to detect a small-to-medium effect (d = 0.30; based on …) with 80% power at a two-sided α of .05.” ข้อความนี้ควรอยู่ในส่วน Methods ร่วมกับวิธีสุ่ม ดูโครงสร้างส่วน Methods เพิ่มเติมได้ที่บทความ การเขียนส่วน Methods ของเรา
สิ่งที่ไม่ควรเขียนคือ “ใช้ G*Power ได้ 85 คน” โดยไม่ระบุสถิติทดสอบและขนาดอิทธิพล เพราะตรวจสอบไม่ได้ ส่วนกรณีที่เก็บข้อมูลไปแล้วและต้องอธิบายว่าการศึกษามีอำนาจพอหรือไม่ Lakens (2022) เสนอให้รายงาน sensitivity power analysis ว่าขนาดตัวอย่างที่มีอยู่ตรวจพบผลในช่วงขนาดใดได้ด้วยอำนาจเพียงพอ [2]
สรุป
เช็กลิสต์ก่อนเขียนเรื่องขนาดกลุ่มตัวอย่างในโครงร่างวิทยานิพนธ์หรือบทความ
- เขียนคำถามวิจัยหลักเป็นประโยคเดียว และระบุว่าเป็นการ ประมาณค่า หรือ ทดสอบสมมติฐาน
- งานสำรวจที่ประมาณสัดส่วน ทราบ N และสุ่มแบบอาศัยความน่าจะเป็น: ใช้ Yamane หรือ Krejcie & Morgan ได้ และระบุ e ที่ใช้
- งานเปรียบเทียบ สหสัมพันธ์ ทำนาย หรือทดลอง: ระบุสถิติทดสอบ แล้วใช้ G*Power แบบ A priori
- กำหนด α (มัก 0.05 สองทาง) อำนาจอย่างน้อย 0.80 และขนาดอิทธิพลพร้อมแหล่งอ้างอิง ไม่เลือก “ใหญ่” เพียงเพื่อลดจำนวน
- คำนวณทุกคำถามหลัก ใช้ค่าที่มากที่สุด และตรวจจำนวนในกลุ่มย่อยที่เล็กที่สุด
- ปรับเพิ่มสำหรับการไม่ตอบกลับ และรายงานอัตราตอบกลับจริง
- เขียนข้อความในบทที่ 3 ให้ผู้อ่านคำนวณซ้ำได้ อ้างอิงโปรแกรมและเวอร์ชัน
การกำหนดขนาดกลุ่มตัวอย่างเป็นการตัดสินใจเชิงระเบียบวิธีของผู้วิจัยเอง หากต้องการผู้เชี่ยวชาญช่วยตรวจว่าเหตุผลของขนาดตัวอย่าง ค่าที่ใส่ใน G*Power และข้อความในบทที่ 3 สอดคล้องกับสถิติที่จะใช้จริงหรือไม่ ทีมงาน บริการวิเคราะห์สถิติ ของ Editverse ตรวจทานและให้ข้อเสนอแนะได้ โดยงานวิจัยและข้อสรุปยังเป็นของคุณทั้งหมด
คำถามที่พบบ่อย
ควรใช้ Yamane หรือ G*Power
ขึ้นกับคำถามวิจัย ถ้าต้องการประมาณค่าสัดส่วนในประชากรที่ทราบ N ใช้ Yamane หรือ Krejcie & Morgan ได้ แต่ถ้าเปรียบเทียบกลุ่ม หาความสัมพันธ์ หรือทดสอบสมมติฐาน ต้องใช้ power analysis เช่น G*Power
ต้องกำหนดค่าอะไรบ้างก่อนเปิด G*Power
ขนาดอิทธิพลพร้อมแหล่งอ้างอิง ระดับนัยสำคัญ α ซึ่งมักใช้ 0.05 แบบสองทาง และอำนาจการทดสอบอย่างน้อย 0.80
มีหลายคำถามวิจัย ควรใช้ขนาดตัวอย่างใด
คำนวณทุกคำถามหลัก แล้วใช้ค่าที่มากที่สุด ตรวจจำนวนในกลุ่มย่อยที่เล็กที่สุด และปรับเพิ่มสำหรับการไม่ตอบกลับ
เอกสารอ้างอิง
- วัลลภ รัฐฉัตรานนท์. (2562). การหาขนาดตัวอย่างที่เหมาะสมสำหรับการวิจัย: มายาคติในการใช้สูตรของ ทาโร ยามาเน่ และเครทซี-มอร์แกน. วารสารสหวิทยาการวิจัย: ฉบับบัณฑิตศึกษา, 8(1), 11–28. https://so03.tci-thaijo.org/index.php/JIRGS/article/view/243621
- Lakens, D. (2022). Sample size justification. Collabra: Psychology, 8(1), 33267. doi:10.1525/collabra.33267
- Krejcie, R. V., & Morgan, D. W. (1970). Determining sample size for research activities. Educational and Psychological Measurement, 30(3), 607–610. doi:10.1177/001316447003000308
- Heinrich-Heine-Universität Düsseldorf. (2026). G*Power: Statistical power analyses for Mac and Windows. https://www.psychologie.hhu.de/arbeitsgruppen/allgemeine-psychologie-und-arbeitspsychologie/gpower
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. doi:10.3758/bf03193146 PMID: 17695343
- Faul, F., Erdfelder, E., Buchner, A., & Lang, A.-G. (2009). Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behavior Research Methods, 41(4), 1149–1160. doi:10.3758/BRM.41.4.1149 PMID: 19897823
- Kang, H. (2021). Sample size determination and power analysis using the G*Power software. Journal of Educational Evaluation for Health Professions, 18, 17. doi:10.3352/jeehp.2021.18.17 PMID: 34325496
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155–159. doi:10.1037/0033-2909.112.1.155 PMID: 19565683
- Button, K. S., Ioannidis, J. P. A., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S. J., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. doi:10.1038/nrn3475 PMID: 23571845
- Schulz, K. F., Altman, D. G., & Moher, D., for the CONSORT Group. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. doi:10.1136/bmj.c332 PMID: 20332509
- ศักดิ์ชัย จันทะแสง. (2568). การคำนวณขนาดตัวอย่างด้วยโปรแกรมสำเร็จรูป G*POWER. Mahidol R2R e-Journal, 12(2), 30–43. doi:10.14456/jmu.2025.17
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ