Linear กับ Logistic Regression ต่างกันอย่างไร เลือกใช้แบบไหน
Linear regression ใช้เมื่อตัวแปรตามเป็นค่าต่อเนื่อง ส่วน logistic regression ใช้เมื่อตัวแปรตามมีเพียง 2 ค่า ชนิดของตัวแปรตามจึงเป็นตัวตัดสินแรก ตามด้วยข้อตกลงเบื้องต้น จำนวนเหตุการณ์ต่อตัวแปร และวิธีแปลค่าสัมประสิทธิ์ซึ่งต่างกันระหว่างสองโมเดล
Linear กับ Logistic Regression ต่างกันที่ตรงไหน: เริ่มจากชนิดของตัวแปรตาม
ทั้งสองโมเดลอยู่ในตระกูลเดียวกัน คือหาความสัมพันธ์ระหว่างตัวแปรอิสระ (X) หนึ่งตัวหรือหลายตัวกับตัวแปรตาม (Y) และควบคุมตัวแปรกวนได้พร้อมกัน ความต่างอยู่ที่ชนิดของ Y Schober และ Vetter อธิบายว่า linear regression ประมาณการเปลี่ยนแปลงเฉลี่ยของ Y ที่เป็นค่าต่อเนื่องเมื่อ X เปลี่ยน 1 หน่วย และ t-test กับ ANOVA เป็นกรณีพิเศษของ linear regression [1] ส่วน logistic regression ใช้กับ Y ที่มี 2 ค่า เช่น เกิดภาวะแทรกซ้อนหรือไม่ และเป็นส่วนขยายของ linear regression ที่ไม่ได้จำลองความน่าจะเป็นด้วยเส้นตรง แต่จำลองเส้นตรงกับ logit หรือ ln ของ odds [2]
เหตุผลที่ห้ามใช้เส้นตรงกับ Y แบบ 0/1 คือเส้นตรงไม่มีขอบเขต ค่าทำนายจึงต่ำกว่า 0 หรือเกิน 1 ได้ ซึ่งเป็นไปไม่ได้สำหรับความน่าจะเป็น และละเมิดข้อตกลงของ linear regression อย่างชัดเจน [2] เมื่อแปลง logit กลับเป็นความน่าจะเป็น จะได้โค้งรูปตัว S ที่อยู่ระหว่าง 0 ถึง 1 เสมอ ภาพที่ 1 สรุปกฎเลือกโมเดลจากชนิดของ Y รวมทั้งกรณีที่ Y มีมากกว่า 2 กลุ่ม ซึ่งใช้ multinomial หรือ ordinal logistic regression [2]

| ประเด็น | Linear regression | Binary logistic regression |
|---|---|---|
| ตัวแปรตาม (Y) | ต่อเนื่อง เช่น คะแนนสอบ ความดันโลหิต | มี 2 ค่า (0/1) เช่น ผ่าน/ไม่ผ่าน ป่วย/ไม่ป่วย |
| สิ่งที่โมเดลทำนาย | ค่าเฉลี่ยของ Y | logit = ln[P/(1 − P)] แล้วแปลงกลับเป็นความน่าจะเป็น P |
| รูปความสัมพันธ์ | เส้นตรงระหว่าง X กับ Y | เส้นตรงระหว่าง X กับ logit ซึ่งเป็นโค้งรูปตัว S บนสเกลความน่าจะเป็น |
| วิธีประมาณค่า | กำลังสองน้อยที่สุด (OLS) | ภาวะน่าจะเป็นสูงสุด (maximum likelihood) |
| ค่าที่รายงานหลัก | b, 95% CI, R² | OR = eb, 95% CI, ค่าความเหมาะสมของโมเดล (เช่น C-statistic) |
| ข้อตกลงหลัก | เส้นตรง, ส่วนเหลือแจกแจงปกติและความแปรปรวนคงที่, ข้อมูลอิสระ | X สัมพันธ์เชิงเส้นกับ logit, ข้อมูลอิสระ, จำนวนเหตุการณ์เพียงพอ |
คำถามที่พบได้ในงานวิทยานิพนธ์คือ ถ้า Y เป็นคะแนนต่อเนื่อง จะตัดเป็น “ผ่าน/ไม่ผ่าน” แล้วใช้ logistic ได้หรือไม่ คำตอบคือทำได้ทางเทคนิค แต่เสียข้อมูลความแปรผันภายในกลุ่ม ถ้าคำถามวิจัยไม่ได้ต้องการผลลัพธ์แบบสองกลุ่มจริง ๆ ควรวิเคราะห์ Y ในรูปต่อเนื่องด้วย linear regression และกำหนดเหตุผลไว้ในแผนการวิเคราะห์ตั้งแต่บทที่ 3
ข้อตกลงเบื้องต้นที่ต้องตรวจก่อนรายงานผล
Linear regression
Schober และ Vetter ระบุข้อตกลงหลัก 3 ข้อ ได้แก่ ส่วนเหลือ (residual) ต้องแจกแจงใกล้เคียงปกติและมีความแปรปรวนใกล้เคียงกันตลอดช่วงค่าทำนาย ข้อมูลแต่ละรายต้องอิสระต่อกัน เช่น ไม่ใช่การวัดซ้ำในคนเดิม (ถ้าวัดซ้ำต้องใช้ linear mixed-effects model) และโมเดลต้องระบุถูกต้อง ทั้งการเลือกตัวแปรและรูปความสัมพันธ์ เพราะการตัดตัวแปรหรือ interaction ที่สำคัญออกทำให้ค่าประมาณเอนเอียง [1] ข้อสังเกตคือข้อตกลงเรื่องการแจกแจงปกติเป็นของส่วนเหลือ ไม่ใช่ของ X หรือ Y ดิบ
Logistic regression
Logistic regression ไม่ต้องการส่วนเหลือแจกแจงปกติหรือความแปรปรวนคงที่ แต่มีข้อตกลงของตัวเอง ได้แก่ ตัวแปรอิสระที่เป็นค่าต่อเนื่องต้องสัมพันธ์เชิงเส้นกับ logit (ถ้าไม่ใช่ ให้ระบุโมเดลแบบโค้งได้) ข้อมูลต้องอิสระต่อกัน (ถ้ามีข้อมูลซ้อนหรือวัดซ้ำต้องใช้ generalized linear mixed-effects model) และโมเดลต้องระบุถูกต้อง [2] นอกจากนี้ควรประเมิน calibration (ความเสี่ยงที่ทำนายตรงกับที่สังเกตได้แค่ไหน) และ discrimination (มักใช้พื้นที่ใต้โค้ง ROC หรือ C-statistic) [2] ข้อตกลงที่มักถูกลืมคือจำนวนเหตุการณ์ต้องเพียงพอเมื่อเทียบกับจำนวนตัวแปร ซึ่งจะอธิบายในหัวข้อถัดไป
ตัวอย่างคำนวณทีละขั้นด้วยชุดข้อมูล mtcars
ตัวอย่างนี้ใช้ชุดข้อมูล mtcars ที่ติดมากับโปรแกรม R ตามเอกสารทางการของ R ข้อมูลมาจากนิตยสาร Motor Trend ของสหรัฐฯ ปี 1974 มีรถยนต์ 32 รุ่น (รุ่นปี 1973–74) และตัวแปร 11 ตัว ต้นทางคือบทความของ Henderson และ Velleman (1981) [3] [4] ข้อมูลชุดเดียวกันมีทั้ง Y ต่อเนื่อง (mpg ไมล์ต่อแกลลอน) และ Y สองค่า (am: 0 = เกียร์อัตโนมัติ 19 คัน, 1 = เกียร์ธรรมดา 13 คัน) จึงเปรียบเทียบสองโมเดลได้ด้วย X ตัวเดียวกันคือน้ำหนักรถ (wt หน่วย 1,000 ปอนด์) ผู้อ่านรันซ้ำได้และควรได้ตัวเลขตรงกับบทความ (R 4.3.3)
data(mtcars)                         # ชุดข้อมูลที่ติดมากับ R (แพ็กเกจ datasets)
table(mtcars$am)                     # 0 = อัตโนมัติ 19 คัน, 1 = ธรรมดา 13 คัน

# 1) Linear regression: Y ต่อเนื่อง
fit_lm <- lm(mpg ~ wt, data = mtcars)
summary(fit_lm); confint(fit_lm)
shapiro.test(residuals(fit_lm))      # ส่วนเหลือแจกแจงปกติหรือไม่
lmtest::bptest(fit_lm)               # ความแปรปรวนคงที่ (Breusch-Pagan)

# 2) Logistic regression: Y มี 2 ค่า
mtcars$wt100 <- mtcars$wt * 10      # หน่วยละ 100 ปอนด์ เพื่อให้ OR อ่านง่าย
fit_glm <- glm(am ~ wt100, family = binomial, data = mtcars)
exp(cbind(OR = coef(fit_glm), confint.default(fit_glm)))
predict(fit_glm, data.frame(wt100 = c(20, 30, 35, 40)), type = "response")

# 3) ขนาดตัวอย่างตามเกณฑ์ Riley et al.
pmsampsize::pmsampsize(type = "b", cstatistic = 0.75,
                       parameters = 10, prevalence = 0.30)
ขั้นที่ 1: Linear regression ของ mpg ตามน้ำหนักรถ
| ตัวแปร | b | 95% CI | p |
|---|---|---|---|
| ค่าคงที่ (Intercept) | 37.29 | [33.45, 41.12] | < .001 |
| น้ำหนักรถ (wt, 1,000 ปอนด์) | −5.34 | [−6.49, −4.20] | < .001 |
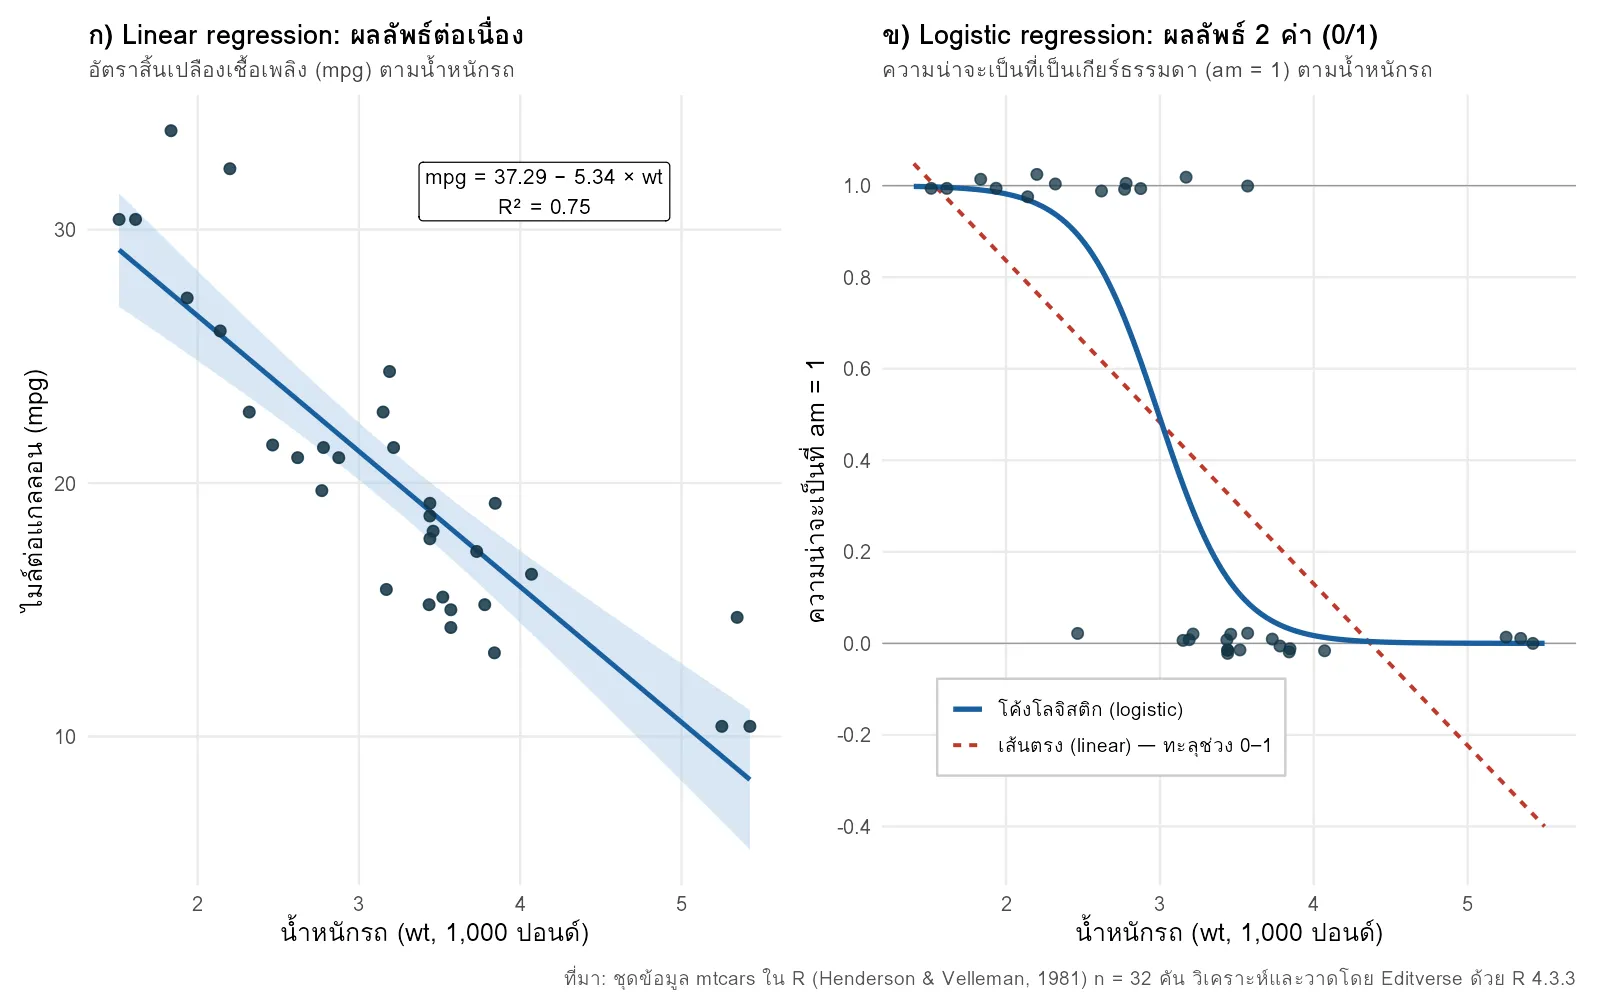
สมการที่ได้คือ mpg = 37.29 − 5.34 × wt โมเดลอธิบายความแปรปรวนของ mpg ได้ R² = .75 (adjusted R² = .74), F(1, 30) = 91.38, p < .001 ตรวจข้อตกลงแล้ว Shapiro-Wilk ของส่วนเหลือ W = 0.945, p = .104 และ Breusch-Pagan = 0.04, p = .841 จึงไม่พบหลักฐานว่าละเมิดข้อตกลงเรื่องการแจกแจงปกติและความแปรปรวนคงที่ เมื่อเพิ่มแรงม้า (hp) เป็นตัวแปรที่สอง สัมประสิทธิ์ของ wt ลดเหลือ −3.88 (95% CI [−5.17, −2.58]) และ R² เพิ่มเป็น .83 แสดงว่าผลของน้ำหนักส่วนหนึ่งซ้อนกับแรงม้า
ขั้นที่ 2: ลองใช้เส้นตรงกับ Y แบบ 0/1 (สิ่งที่ไม่ควรทำ)
ถ้าใช้ lm(am ~ wt) ซึ่งเป็นเส้นตรงกับ Y ที่มี 2 ค่า ค่าทำนายจะอยู่ระหว่าง −0.37 ถึง 1.01 และรถ 3 คันได้ “ความน่าจะเป็น” ติดลบ ตรงตามที่ Schober และ Vetter เตือนไว้ [2] เส้นประสีแดงในภาพที่ 2 ข) แสดงปัญหานี้
ขั้นที่ 3: Logistic regression ของ am ตามน้ำหนักรถ
ใน R ใช้ glm() กับ family = binomial ซึ่งเป็นโมเดลเชิงเส้นวางนัยทั่วไปที่ใช้ logit link เป็นค่าเริ่มต้น [5] ผลคือ logit(P) = 12.04 − 4.02 × wt (z = −2.80, p = .005) เพื่อให้แปลผลง่ายขึ้นจึงแปลงหน่วยน้ำหนักเป็นทีละ 100 ปอนด์
| ตัวแปร | b (log-odds) | OR ต่อ 100 ปอนด์ | 95% CI ของ OR (Wald) | p |
|---|---|---|---|---|
| น้ำหนักรถ (โมเดล 1: wt ตัวเดียว) | −4.02 ต่อ 1,000 ปอนด์ | 0.67 | [0.50, 0.89] | .005 |
| น้ำหนักรถ (โมเดล 2: wt + hp) | −8.08 ต่อ 1,000 ปอนด์ | 0.45 | [0.24, 0.81] | .008 |
แปลผลสัมประสิทธิ์ b กับ Odds Ratio ให้ถูกต้อง
ใน linear regression ค่า b คือการเปลี่ยนแปลงเฉลี่ยของ Y ในหน่วยเดิมของ Y เมื่อ X เพิ่ม 1 หน่วย โดยควบคุมตัวแปรอื่นในโมเดลไว้คงที่ [1] จากตัวอย่าง รถที่หนักขึ้น 1,000 ปอนด์มีอัตราสิ้นเปลืองเฉลี่ยลดลง 5.34 ไมล์ต่อแกลลอน (95% CI 4.20 ถึง 6.49) ค่านี้เท่ากันทุกช่วงของน้ำหนัก
ใน logistic regression ค่า b อยู่ในหน่วย log-odds ซึ่งอ่านตรง ๆ ไม่ได้ ต้องยกกำลัง e ก่อนเพื่อให้เป็น odds ratio (OR) ซึ่งบอกว่า odds ของผลลัพธ์เปลี่ยนไปกี่เท่าเมื่อ X เพิ่ม 1 หน่วย หรือเมื่อเทียบกับกลุ่มอ้างอิง [2] จากตัวอย่าง OR = 0.67 ต่อ 100 ปอนด์ หมายความว่า odds ที่จะเป็นเกียร์ธรรมดาลดลงประมาณ 33% ทุกครั้งที่น้ำหนักเพิ่ม 100 ปอนด์
จุดที่ผู้วิจัยมักแปลผิดคือ OR ไม่ใช่การเปลี่ยนแปลงของความน่าจะเป็น ตารางด้านล่างคำนวณจากโมเดลเดียวกัน OR เท่ากันทุกช่วง แต่ความน่าจะเป็นลดลงต่างกันมากตามจุดเริ่มต้น
| น้ำหนักรถ (1,000 ปอนด์) | ความน่าจะเป็นที่เป็นเกียร์ธรรมดา | เปลี่ยนเมื่อหนักขึ้น 100 ปอนด์ |
|---|---|---|
| 2.0 → 2.1 | 98.2% → 97.3% | ลดลง 0.9 จุดร้อยละ |
| 3.0 → 3.1 | 49.2% → 39.3% | ลดลง 9.9 จุดร้อยละ |
| 3.5 | 11.5% | – |
| 4.0 | 1.7% | – |
ตัวอย่างจากงานตีพิมพ์จริง Schober และ Vetter ยกผลของ Park และคณะที่ศึกษาภาวะออกซิเจนในเลือดต่ำระหว่างการใส่ท่อช่วยหายใจแบบ rapid sequence induction (RSI) ในทารกที่ผ่าตัด pyloromyotomy ได้ adjusted OR = 2.8 (95% CI 1.5–5.3) และอธิบายว่า odds ของภาวะออกซิเจนต่ำในกลุ่ม RSI แบบดั้งเดิมสูงกว่ากลุ่มเทคนิคดัดแปลงเกือบ 3 เท่าหลังควบคุมตัวแปรกวนแล้ว [2] สังเกตว่าคำอธิบายใช้คำว่า “odds” ไม่ใช่ “ความเสี่ยง” และระบุกลุ่มอ้างอิงชัดเจน ซึ่งเป็นรูปแบบที่ควรใช้ในบทที่ 4
ตัวอย่างการเขียนรายงาน
ผลการวิเคราะห์การถดถอยโลจิสติกพบว่าน้ำหนักรถสัมพันธ์กับโอกาสที่รถเป็นเกียร์ธรรมดาอย่างมีนัยสำคัญทางสถิติ (b = −0.40 ต่อ 100 ปอนด์, OR = 0.67, 95% CI [0.50, 0.89], p = .005) กล่าวคือ น้ำหนักที่เพิ่มขึ้นทุก 100 ปอนด์สัมพันธ์กับ odds ของการเป็นเกียร์ธรรมดาที่ลดลงร้อยละ 33 (n = 32, เหตุการณ์ = 13)
การระบุจำนวนเหตุการณ์ หน่วยของ X และกลุ่มอ้างอิงช่วยให้ผู้ทบทวนตรวจได้ทันที ดูการเขียนวิธีวิเคราะห์ให้ครบได้ในบทความการเขียนส่วน Methods
จำนวนเหตุการณ์ต่อตัวแปร (EPV) และขนาดตัวอย่างของ Logistic Regression
ใน logistic regression ขนาดตัวอย่างที่มีผลจริงไม่ใช่ n ทั้งหมด แต่เป็นจำนวน “เหตุการณ์” ในกลุ่มที่เล็กกว่า กฎ 10 EPV มาจากงานจำลองของ Peduzzi และคณะ (1996) ซึ่งใช้ข้อมูลจริงจากการทดลองทางหัวใจ 673 ราย มีผู้เสียชีวิต 252 ราย และตัวทำนาย 7 ตัว (EPV = 36) แล้วสุ่มตัวอย่างซ้ำที่ EPV = 2, 5, 10, 15, 20 และ 25 กลุ่มละ 500 ชุด ผลพบว่าเมื่อ EPV ตั้งแต่ 10 ขึ้นไปไม่มีปัญหาสำคัญ แต่เมื่อ EPV น้อยกว่า 10 สัมประสิทธิ์เอนเอียงทั้งทางบวกและลบ ช่วงความเชื่อมั่นครอบคลุมไม่ถูกต้อง และความสัมพันธ์ที่มีนัยสำคัญในทิศทางผิดพบบ่อยขึ้น [6]
ต่อมา Vittinghoff และ McCulloch (2007) ทำการจำลองขนาดใหญ่และพบหลายสถานการณ์ที่ EPV ต่ำกว่า 10 แต่ความเอนเอียงและความครอบคลุมยังอยู่ในระดับรับได้ จึงเสนอให้ผ่อนกฎนี้ได้ โดยเฉพาะในการวิเคราะห์ความไวเพื่อแสดงการควบคุมตัวแปรกวน [7] ในทางกลับกัน Riley และคณะ (2019) แสดงว่าสำหรับโมเดลทำนาย จำนวนที่ต้องการขึ้นกับบริบท ตัวอย่างจริงในบทความคือโมเดลวินิจฉัยโรค Chagas ต้องการเหตุการณ์ต่อพารามิเตอร์ (EPP) อย่างน้อย 4.8 แต่โมเดลพยากรณ์การเกิดลิ่มเลือดดำซ้ำต้องการอย่างน้อย 23 จึงไม่ควรใช้กฎหัวแม่มืออย่าง 10 EPP [8]
เกณฑ์ของ Riley และตัวอย่างคำนวณ
Riley และคณะเสนอให้ขนาดตัวอย่างผ่าน 3 เกณฑ์สำหรับผลลัพธ์สองค่า ได้แก่ (1) ค่า global shrinkage ≥ 0.9 (2) ผลต่างระหว่าง Nagelkerke R² ที่ปรากฏกับที่ปรับแล้วไม่เกิน 0.05 และ (3) ประมาณความเสี่ยงเฉลี่ยของประชากรได้แม่นยำ [8] [9] เกณฑ์เหล่านี้คำนวณได้ด้วยแพ็กเกจ pmsampsize ใน R [10] สมมติว่าคุณจะพัฒนาโมเดลทำนายที่มีพารามิเตอร์ 10 ตัว ความชุกของผลลัพธ์ 30% และคาดว่า C-statistic ประมาณ 0.75 (ควรอ้างจากงานก่อนหน้า) ผลการคำนวณเป็นดังนี้
| เกณฑ์ | ขนาดตัวอย่าง (n) | EPP |
|---|---|---|
| 1) ค่า shrinkage ≥ 0.90 (คุม overfitting) | 514 | 15.42 |
| 2) ผลต่าง Nagelkerke R² ≤ 0.05 | 255 | 7.65 |
| 3) ประมาณความเสี่ยงเฉลี่ยคลาดเคลื่อนไม่เกิน ±0.05 | 323 | 9.69 |
| ขนาดขั้นต่ำ (ค่าสูงสุดของ 3 เกณฑ์) | 514 | 15.42 |
| เทียบกฎ 10 EPV แบบเดิม | 334 | 10 |
ขนาดขั้นต่ำคือ 514 ราย หรือประมาณ 155 เหตุการณ์ (EPP 15.4) ขณะที่กฎ 10 EPV ให้เพียง 100 เหตุการณ์ หรือ 100 / 0.30 ≈ 334 ราย ความต่างนี้มาจากเกณฑ์ที่ 1 ซึ่งคุม overfitting ส่วนการคำนวณกำลังทดสอบสำหรับการทดสอบสมมติฐานของ regression ทั่วไปเป็นอีกแนวทางหนึ่ง ซึ่งทำได้ด้วยโปรแกรม G*Power
EPV ในตัวอย่าง mtcars
ข้อมูล mtcars มีเหตุการณ์ (เกียร์ธรรมดา) 13 คัน โมเดลที่มี wt ตัวเดียวจึงมี EPV = 13 เมื่อเพิ่ม hp เป็นตัวที่สอง EPV ลดเหลือ 6.5 สัมประสิทธิ์ของ wt เปลี่ยนจาก −4.02 เป็น −8.08 และช่วงความเชื่อมั่นของ OR ต่อ 100 ปอนด์กว้างขึ้นเป็น 0.24–0.81 การเปลี่ยนแปลงส่วนหนึ่งเกิดจากการปรับตัวแปร hp แต่ช่วงที่กว้างมากสะท้อนข้อมูลที่มีเหตุการณ์น้อย ซึ่งเป็นสถานการณ์ที่ Peduzzi และคณะเตือนไว้ [6] ข้อมูลชุดนี้จึงเหมาะเป็นตัวอย่างสอน ไม่เหมาะสร้างโมเดลทำนายจริง
บริบทไทย: ตัวอย่างจากบทความบน ThaiJO และการรายงานในวิทยานิพนธ์
ตัวอย่างที่ตีพิมพ์จริงในไทยคือบทความของ จิรภา คำทา (2558) ในวารสาร Veridian E-Journal มหาวิทยาลัยศิลปากร ซึ่งเผยแพร่บนระบบ ThaiJO ผู้วิจัยศึกษานักศึกษาปริญญาตรีของสถาบันเทคโนโลยีไทย-ญี่ปุ่น ปีการศึกษา 2557 จำนวน 260 คน ใช้ logistic regression ทำนายผลการสอบวิชาสถิติ และพบตัวทำนาย 3 ตัว คือ เกรดเฉลี่ยสะสม (GPAX) แรงจูงใจใฝ่สัมฤทธิ์ และการส่งเสริมการเรียนจากผู้ปกครอง ตามบทคัดย่อ ตัวแปรทั้งสามร่วมกันอธิบายผลการสอบได้ถูกต้องร้อยละ 47.9 และรายงานสมการ P(Y) = −10.63 + 3.24GPAX + 1.02Motivation + 0.67Supporting [11]
บทความนี้ใช้ฝึกอ่านผลได้ดี ค่าสัมประสิทธิ์ทั้งหมดอยู่ในสเกล log-odds ด้านซ้ายของสมการจึงหมายถึง logit ของความน่าจะเป็น ไม่ใช่ความน่าจะเป็นโดยตรง ถ้าแปลงเป็น OR จะได้ e3.24 ≈ 25.5 ต่อ GPAX 1 หน่วย, e1.02 ≈ 2.77 และ e0.67 ≈ 1.95 ต่อคะแนนของแต่ละด้าน 1 หน่วย ค่า 25.5 ดูสูงมากเพราะ GPAX 1 หน่วยคือช่วงที่กว้าง (เช่น จาก 2.00 เป็น 3.00) ถ้ารายงาน OR ต่อ 0.5 หน่วยจะอ่านได้สมจริงกว่า เมื่อคุณเขียนงานเอง ควรเขียนด้านซ้ายเป็น logit(P) หรือ ln[P/(1 − P)] ระบุว่าร้อยละที่รายงานเป็นความถูกต้องของการจำแนกหรือเป็น pseudo R² แบบใด และรายงานจำนวนผู้ที่เกิดเหตุการณ์ในแต่ละกลุ่ม เพื่อให้ผู้อ่านประเมิน EPV ได้ ข้อมูลเหล่านี้ประเมินจากบทคัดย่ออย่างเดียวไม่ได้
สำหรับผู้ใช้ SPSS ทั้งสองโมเดลอยู่ในเมนู Analyze → Regression คือ Linear และ Binary Logistic ส่วน R ใช้ lm() และ glm() ตามโค้ดข้างต้น ดูการเปรียบเทียบโปรแกรมได้ในบทความ SPSS vs R vs Python หากงานของคุณเป็นการพัฒนาหรือตรวจสอบโมเดลทำนายทางคลินิก ให้ใช้แนวทาง TRIPOD+AI (2024) ที่เครือข่าย EQUATOR เผยแพร่ ซึ่งครอบคลุมโมเดลทั้งแบบ regression และ machine learning [12] [13] ถ้าผู้ทบทวนถามเรื่อง EPV หรือขนาดตัวอย่าง ให้ตอบด้วยการคำนวณตามเกณฑ์ข้างต้นและเอกสารอ้างอิง ดูแนวทางในบทความการแก้ไขหลังได้รับ Major Reviewer Comments
ข้อผิดพลาดที่พบบ่อย
- ใช้ linear regression กับผลลัพธ์ 0/1 ทำให้ได้ค่าทำนายนอกช่วง 0–1 [2]
- รายงาน b ของ logistic regression เป็น “ความน่าจะเป็นเพิ่มขึ้น” แทนที่จะแปลงเป็น OR และอธิบายเป็น odds
- ไม่ระบุหน่วยของ X และกลุ่มอ้างอิง ทำให้ OR อ่านไม่ได้
- ใส่ตัวแปรจำนวนมากทั้งที่เหตุการณ์น้อย โดยไม่ตรวจ EPV หรือเกณฑ์ของ Riley [6] [9]
- ตรวจการแจกแจงปกติของ Y ดิบ แทนการตรวจส่วนเหลือของ linear regression [1]
- ใช้โมเดลปกติกับข้อมูลวัดซ้ำหรือข้อมูลซ้อน ซึ่งต้องใช้ mixed-effects model [1] [2]
สรุป
- ระบุชนิดของตัวแปรตามก่อน: ต่อเนื่อง → linear regression, สองค่า → binary logistic regression, อันดับหรือหลายกลุ่ม → ordinal หรือ multinomial logistic
- Linear: ตรวจความเป็นเส้นตรง การแจกแจงปกติและความแปรปรวนคงที่ของส่วนเหลือ และความเป็นอิสระของข้อมูล
- Logistic: ตรวจความเป็นเส้นตรงกับ logit ความเป็นอิสระ และจำนวนเหตุการณ์ในกลุ่มที่เล็กกว่า
- คำนวณ EPV และสำหรับโมเดลทำนาย ใช้เกณฑ์ของ Riley (เช่น pmsampsize) แทนกฎ 10 EPV อย่างเดียว
- Linear: รายงาน b, 95% CI, p และ R² / Logistic: รายงาน OR = eb, 95% CI, p, จำนวนเหตุการณ์ และ C-statistic หรือ calibration
- ระบุหน่วยของ X กลุ่มอ้างอิง โปรแกรมและเวอร์ชันที่ใช้
- งานโมเดลทำนายทางคลินิกตรวจตามรายการ TRIPOD+AI
ถ้าคุณวิเคราะห์ข้อมูลเสร็จแล้วแต่ยังไม่มั่นใจว่าเลือกโมเดลถูก ขนาดตัวอย่างพอหรือแปลค่า OR ได้ถูกต้อง ทีมของเราตรวจทานแผนวิเคราะห์ ผลลัพธ์ และการเขียนรายงานให้สอดคล้องกับข้อมูลจริงของคุณผ่านบริการวิเคราะห์สถิติ โดยบรรณาธิการที่มีวุฒิปริญญาเอกหรือแพทยศาสตร์ในสาขาใกล้เคียงกับงานของคุณ เราช่วยตรวจสอบและยกระดับงานของคุณ ไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
เลือก linear หรือ logistic regression จากอะไร
ดูชนิดของตัวแปรตามก่อน ต่อเนื่องใช้ linear สองค่าใช้ binary logistic และถ้าเป็นอันดับหรือหลายกลุ่มใช้ ordinal หรือ multinomial logistic
แปลผลค่าสัมประสิทธิ์ต่างกันอย่างไร
linear รายงาน b ซึ่งเป็นการเปลี่ยนแปลงของตัวแปรตามเมื่อ X เพิ่มหนึ่งหน่วย ส่วน logistic แปลงเป็น Odds Ratio = e^b ซึ่งบอกการเปลี่ยนแปลงของ odds
กฎ 10 EPV เพียงพอหรือไม่
สำหรับโมเดลทำนาย ควรใช้เกณฑ์ของ Riley และคณะ เช่น pmsampsize แทนการพึ่งกฎ 10 EPV เพียงอย่างเดียว
เอกสารอ้างอิง
- Schober, P., & Vetter, T. R. (2021). Linear regression in medical research. Anesthesia & Analgesia, 132(1), 108–109. doi:10.1213/ANE.0000000000005206 PMID: 33315608
- Schober, P., & Vetter, T. R. (2021). Logistic regression in medical research. Anesthesia & Analgesia, 132(2), 365–366. doi:10.1213/ANE.0000000000005247 PMID: 33449558
- R Core Team. (n.d.). mtcars: Motor Trend Car Road Tests. R Documentation, package datasets. https://stat.ethz.ch/R-manual/R-devel/library/datasets/html/mtcars.html
- Henderson, H. V., & Velleman, P. F. (1981). Building multiple regression models interactively. Biometrics, 37(2), 391–411. doi:10.2307/2530428
- R Core Team. (n.d.). glm: Fitting Generalized Linear Models. R Documentation, package stats. https://stat.ethz.ch/R-manual/R-devel/library/stats/html/glm.html
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. doi:10.1016/s0895-4356(96)00236-3 PMID: 8970487
- Vittinghoff, E., & McCulloch, C. E. (2007). Relaxing the rule of ten events per variable in logistic and Cox regression. American Journal of Epidemiology, 165(6), 710–718. doi:10.1093/aje/kwk052 PMID: 17182981
- Riley, R. D., Snell, K. I., Ensor, J., Burke, D. L., Harrell, F. E., Jr., Moons, K. G., & Collins, G. S. (2019). Minimum sample size for developing a multivariable prediction model: PART II – binary and time-to-event outcomes. Statistics in Medicine, 38(7), 1276–1296. doi:10.1002/sim.7992 PMID: 30357870
- Riley, R. D., Ensor, J., Snell, K. I. E., Harrell, F. E., Martin, G. P., Reitsma, J. B., Moons, K. G. M., Collins, G., & van Smeden, M. (2020). Calculating the sample size required for developing a clinical prediction model. BMJ, 368, m441. doi:10.1136/bmj.m441 PMID: 32188600
- Ensor, J. (2023). pmsampsize: Sample Size for Development of a Prediction Model (R package version 1.1.3). CRAN. https://cran.r-project.org/package=pmsampsize
- จิรภา คำทา. (2558). การทำนายผลการสอบวิชาสถิติของนักศึกษาระดับปริญญาตรี สถาบันเทคโนโลยีไทย-ญี่ปุ่น ด้วยการวิเคราะห์การถดถอยโลจิสติกเชิงพหุ. Veridian E-Journal, Silpakorn University (มนุษยศาสตร์ สังคมศาสตร์ และศิลปะ), 8(3), 942–957. https://he02.tci-thaijo.org/index.php/Veridian-E-Journal/article/view/47948
- Collins, G. S., Moons, K. G. M., Dhiman, P., Riley, R. D., Beam, A. L., Van Calster, B., et al. (2024). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. BMJ, 385, e078378. doi:10.1136/bmj-2023-078378 PMID: 38626948
- EQUATOR Network. (n.d.). TRIPOD+AI statement: Updated guidance for reporting clinical prediction models that use regression or machine learning methods. https://www.equator-network.org/reporting-guidelines/tripod-statement/
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ