p-value คืออะไร และทำไมต้องรายงาน Effect Size ควบคู่เสมอ
p-value คือความน่าจะเป็นที่จะได้ข้อมูลแบบที่เห็นหรือสุดโต่งกว่านั้น ภายใต้สมมติฐานว่างและสมมติฐานเบื้องต้นทั้งหมดของแบบจำลอง จึงบอกไม่ได้ว่าผลใหญ่แค่ไหนหรือสำคัญเพียงใด บทความนี้อธิบายหลักการ 6 ข้อของ American Statistical Association ความเข้าใจผิดที่พบบ่อย และวิธีรายงาน effect size พร้อมช่วงความเชื่อมั่น 95% ด้วยตัวอย่างคำนวณใน R และกรณีศึกษาจากการทดลองทางคลินิกที่ตีพิมพ์จริง
p-value คืออะไร: นิยามที่ถูกต้องในประโยคเดียว
นักศึกษาบัณฑิตศึกษาจำนวนมากจำได้ว่า “ถ้า p น้อยกว่า 0.05 แปลว่ามีนัยสำคัญ” แต่เมื่อถูกถามต่อว่า p-value คือความน่าจะเป็นของอะไร คำตอบมักคลาดเคลื่อน นิยามที่ถูกต้องคือ ค่า p เป็นความน่าจะเป็นที่จะได้ค่าสถิติทดสอบเท่ากับที่สังเกตได้หรือสุดโต่งกว่านั้น ถ้า สมมติฐานว่าง (H0) เป็นจริงและสมมติฐานเบื้องต้นอื่นของแบบจำลองถูกต้องทั้งหมด เช่น การสุ่ม ความเป็นอิสระของข้อมูล และรูปแบบการแจกแจง [1, 2]
คำว่า “ถ้า” ในนิยามนี้คือหัวใจของเรื่อง ค่า p ถูกคำนวณภายใต้เงื่อนไขว่าสมมติฐานว่างเป็นจริงอยู่แล้ว ดังนั้นค่า p จึงไม่สามารถบอกความน่าจะเป็นที่สมมติฐานว่างเป็นจริงได้ และไม่ได้บอกว่าผลที่พบมีขนาดใหญ่หรือมีความหมายทางคลินิกเพียงใด ค่า p ขึ้นกับสามสิ่งพร้อมกัน คือ ขนาดของผลจริง ความแปรปรวนของข้อมูล และจำนวนตัวอย่าง เมื่อจำนวนตัวอย่างมากพอ ผลที่เล็กมากก็ให้ค่า p ต่ำกว่า 0.05 ได้ ส่วนการศึกษาขนาดเล็กอาจได้ค่า p สูงแม้ผลจริงจะใหญ่พอสมควร
ด้วยเหตุนี้วารสารสายแพทย์และสายสังคมศาสตร์จึงคาดหวังให้ผู้เขียนรายงาน ขนาดผล (effect size) และ ช่วงความเชื่อมั่น (confidence interval, CI) ควบคู่กับค่า p ค่า p ตอบคำถามว่า “ข้อมูลเข้ากันได้กับสมมติฐานว่างแค่ไหน” ส่วน effect size ตอบคำถามที่ผู้อ่านอยากรู้จริง คือ “ผลใหญ่แค่ไหน” และ CI ตอบว่า “เรามั่นใจในตัวเลขนั้นเพียงใด” [3]
แถลงการณ์ ASA ปี 2016: หลักการ 6 ข้อที่ผู้เขียนทุกคนควรรู้
วันที่ 7 มีนาคม 2016 สมาคมสถิติอเมริกัน (American Statistical Association, ASA) ออกแถลงการณ์อย่างเป็นทางการเรื่องนัยสำคัญทางสถิติและค่า p โดยประธาน ASA ขณะนั้นระบุว่าเป็นครั้งแรกที่ประชาคมนักสถิติในนามคณะกรรมการบริหารของ ASA ออกแถลงการณ์ในประเด็นนี้ แถลงการณ์เผยแพร่ใน The American Statistician โดย Wasserstein และ Lazar [1] เอกสารข่าวของ ASA อ้างคำพูดของผู้อำนวยการบริหารว่า “ค่า p ไม่เคยถูกออกแบบมาให้ใช้แทนการให้เหตุผลทางวิทยาศาสตร์” และระบุว่าแถลงการณ์นี้ตั้งใจนำงานวิจัยเข้าสู่ยุคหลัง p < 0.05 [4] หลักการทั้ง 6 ข้อและความหมายเชิงปฏิบัติสรุปได้ดังตาราง
| หลักการ ASA (2016) | ความหมายเชิงปฏิบัติสำหรับผู้เขียนบทความ |
|---|---|
| 1. ค่า p บอกได้ว่าข้อมูลไม่เข้ากันกับแบบจำลองทางสถิติที่ระบุไว้มากน้อยเพียงใด | ค่า p ยิ่งเล็ก ข้อมูลยิ่งดูผิดปกติ ถ้า สมมติฐานว่างและสมมติฐานเบื้องต้นทุกข้อเป็นจริง |
| 2. ค่า p ไม่ได้วัดความน่าจะเป็นที่สมมติฐานเป็นจริง และไม่ใช่ความน่าจะเป็นที่ผลเกิดจากความบังเอิญล้วน ๆ | ห้ามเขียนว่า “มีโอกาสเพียง 3% ที่ผลนี้เกิดจากความบังเอิญ” เมื่อได้ p = 0.03 |
| 3. ข้อสรุปทางวิทยาศาสตร์และการตัดสินใจเชิงนโยบายไม่ควรอิงเพียงว่าค่า p ผ่านเกณฑ์ที่กำหนดหรือไม่ | p = 0.049 กับ p = 0.051 ให้หลักฐานแทบไม่ต่างกัน อย่าตีความเป็นขาวกับดำ |
| 4. การอนุมานที่ถูกต้องต้องรายงานอย่างครบถ้วนและโปร่งใส | รายงานทุกการวิเคราะห์ที่ทำ ไม่เลือกเฉพาะผลที่ได้ p < 0.05 |
| 5. ค่า p หรือ “นัยสำคัญทางสถิติ” ไม่ได้วัดขนาดของผลหรือความสำคัญของผลลัพธ์ | ต้องรายงาน effect size พร้อมช่วงความเชื่อมั่นเสมอ |
| 6. ค่า p เพียงลำพังไม่ใช่มาตรวัดหลักฐานที่ดีเกี่ยวกับแบบจำลองหรือสมมติฐาน | ใช้ค่า p ร่วมกับการออกแบบ คุณภาพข้อมูล และหลักฐานภายนอก |
สามปีต่อมา The American Statistician ออกฉบับพิเศษกว่า 40 บทความในหัวข้อ “a world beyond p < 0.05” โดยบทบรรณาธิการนำของ Wasserstein, Schirm และ Lazar สรุปว่าถึงเวลาเลิกใช้คำว่า “statistically significant” โดยสิ้นเชิง (it is time to stop using the term entirely) ทั้งนี้บทบรรณาธิการระบุชัดว่าเป็นความเห็นของบรรณาธิการทั้งสามในฐานะบุคคล ไม่ใช่จุดยืนที่ ASA รับรอง [5] ในเดือนเดียวกัน วารสาร Nature ตีพิมพ์บทความความเห็นของ Amrhein, Greenland และ McShane ที่มีผู้ร่วมลงนามกว่า 800 คน เรียกร้องให้เลิกใช้แนวคิดนัยสำคัญทางสถิติแบบแบ่งขั้ว แต่ผู้เขียนย้ำว่าไม่ได้เรียกร้องให้ห้ามใช้ค่า p [6] ข้อเสนอที่ตรงกันของทุกฝ่ายจึงไม่ใช่การยกเลิกค่า p แต่เป็นการรายงานค่า p ที่แท้จริง (เช่น p = 0.032 แทน p < 0.05) และตีความร่วมกับขนาดผลและความไม่แน่นอนของการประมาณค่า
ความเข้าใจผิดเรื่องค่า p ที่พบบ่อย (Greenland et al., 2016)
บทความของ Greenland และคณะใน European Journal of Epidemiology รวบรวมการตีความผิดของค่า p ช่วงความเชื่อมั่น และอำนาจการทดสอบไว้ 25 ข้อ พร้อมคำอธิบายว่าทำไมจึงผิด [2] ข้อที่เกี่ยวข้องกับการเขียนผลและอภิปรายผลในบทความโดยตรงมีดังนี้
| ความเข้าใจผิด | ความหมายที่ถูกต้อง |
|---|---|
| p = 0.01 แปลว่าสมมติฐานว่างมีโอกาสเป็นจริงเพียง 1% | ค่า p คำนวณโดย สมมติ ว่าสมมติฐานว่างเป็นจริงอยู่แล้ว จึงไม่ใช่ความน่าจะเป็นของสมมติฐาน |
| p = 0.08 แปลว่ามีโอกาส 8% ที่ความสัมพันธ์เกิดจากความบังเอิญ | เป็นความน่าจะเป็นที่คำนวณภายใต้เงื่อนไขว่ามีแต่ความบังเอิญทำงาน ไม่ใช่ความน่าจะเป็นของความบังเอิญเอง |
| p > 0.05 แปลว่าไม่มีผล หรือยอมรับสมมติฐานว่างได้ | แปลเพียงว่าข้อมูลไม่ผิดปกติภายใต้สมมติฐานว่าง ข้อมูลชุดเดียวกันอาจเข้ากันได้ดีกับผลขนาดปานกลางด้วย ให้ดูช่วงความเชื่อมั่น |
| ผลมีนัยสำคัญทางสถิติ แปลว่าผลนั้นสำคัญทางคลินิกหรือทางปฏิบัติ | ในการศึกษาขนาดใหญ่ ผลที่เล็กมากก็ให้ค่า p เล็กได้ ต้องดูขนาดผลและ CI |
| งานสองชิ้นได้ p คนละฝั่งของ 0.05 แปลว่าผลขัดแย้งกัน | อาจได้ผลเท่ากันทุกประการแต่ค่าความคลาดเคลื่อนมาตรฐานต่างกัน ต้องทดสอบผลต่างระหว่างงานโดยตรง |
ตัวอย่างในบทความของ Greenland และคณะที่ควรจำคือ การทดลองแบบสุ่มสองชิ้น A และ B ที่เหมือนกันทุกอย่าง ยกเว้นค่า standard error ของผลต่างระหว่างกลุ่มเท่ากับ 2 ในการทดลอง A และ 1 ในการทดลอง B ถ้าทั้งสองการทดลองพบผลต่างเท่ากันคือ 3 การทดสอบแบบปกติจะให้ p = 0.13 ในการทดลอง A แต่ p = 0.003 ในการทดลอง B ทั้งที่ผลของสองการศึกษาตรงกันทุกประการ [2] เราตรวจซ้ำด้วย R ได้ค่า 0.134 และ 0.0027 ตรงกัน
ตัวอย่างจากงานตีพิมพ์จริงที่ Amrhein และคณะยกไว้ใน Nature คือ งานศึกษาผลไม่พึงประสงค์ของยาต้านการอักเสบชุดหนึ่งสรุปว่ายา “ไม่สัมพันธ์” กับการเกิดภาวะหัวใจห้องบนสั่นพลิ้วรายใหม่ และอ้างว่าผลขัดแย้งกับงานก่อนหน้าที่มีนัยสำคัญ ทั้งที่งานนั้นพบ risk ratio 1.2 โดย 95% CI ครอบตั้งแต่ความเสี่ยงลดลง 3% ถึงเพิ่มขึ้น 48% (P = 0.091) ส่วนงานก่อนหน้าก็พบ risk ratio 1.2 เท่ากันพอดี เพียงแต่แม่นยำกว่า โดยมี CI จากความเสี่ยงเพิ่มขึ้น 9% ถึง 33% (P = 0.0003) [6] ผู้เขียนที่อภิปรายว่า “ผลของเราขัดแย้งกับงานก่อนหน้าเพราะงานนั้นไม่มีนัยสำคัญ” จึงกำลังตีความผิดตามข้อนี้โดยตรง วิธีที่ถูกต้องคือเปรียบเทียบขนาดผลและช่วงความเชื่อมั่นของทั้งสองงาน
ตัวอย่างคำนวณ: ผลเท่าเดิม แต่ค่า p เปลี่ยนตามขนาดตัวอย่าง
สมมติว่าโปรแกรมให้ความรู้ก่อนผ่าตัดช่วยลดคะแนนความวิตกกังวลได้จริงเฉลี่ย 3 คะแนน โดยคะแนนมีส่วนเบี่ยงเบนมาตรฐาน 10 คะแนน ขนาดผลที่แท้จริงจึงเท่ากับ Cohen’s d = 3/10 = 0.30 ซึ่ง Cohen จัดว่าอยู่ระหว่างผลขนาดเล็ก (0.2) กับปานกลาง (0.5) [7] เราจะเปรียบเทียบการศึกษาสองชิ้นที่พบผลต่างค่าเฉลี่ยเท่ากันพอดี ต่างกันเพียงจำนวนผู้เข้าร่วม
- คำนวณ standard error ของผลต่าง: SE = SD × √(2/n) ได้ 2.58 เมื่อ n = 30 ต่อกลุ่ม และ 0.82 เมื่อ n = 300 ต่อกลุ่ม
- คำนวณสถิติ t = ผลต่าง ÷ SE: ได้ t(58) = 1.16 และ t(598) = 3.67
- แปลงเป็นค่า p สองทาง: การศึกษา A ได้ p = 0.250 การศึกษา B ได้ p = 0.00026
- คำนวณ 95% CI ของผลต่าง = ผลต่าง ± t0.975 × SE: การศึกษา A ได้ −2.17 ถึง 8.17 การศึกษา B ได้ 1.40 ถึง 4.60
- เทียบ CI กับค่าความแตกต่างที่มีความหมายทางคลินิก (MCID): สมมติว่ากำหนด MCID ไว้ล่วงหน้าที่ 5 คะแนน การศึกษา A มี CI ครอบทั้ง 0 และ 5 จึงยังสรุปไม่ได้ทั้งสองทาง ส่วนการศึกษา B มี CI อยู่ต่ำกว่า 5 ทั้งช่วง แปลว่าโปรแกรมน่าจะมีผลจริง แต่ผลนั้นน่าจะเล็กกว่าระดับที่ผู้ป่วยรู้สึกได้
| ตัวชี้วัด | การศึกษา A (30 คน/กลุ่ม) | การศึกษา B (300 คน/กลุ่ม) |
|---|---|---|
| ผลต่างค่าเฉลี่ย (SD = 10) | 3.0 คะแนน | 3.0 คะแนน |
| Standard error ของผลต่าง = 10 × √(2/n) | 2.58 | 0.82 |
| สถิติ t (df) | t(58) = 1.16 | t(598) = 3.67 |
| ค่า p สองทาง | 0.250 | 0.00026 (รายงาน p < .001) |
| 95% CI ของผลต่างค่าเฉลี่ย | −2.17 ถึง 8.17 | 1.40 ถึง 4.60 |
| Cohen’s d [95% CI] | 0.30 [−0.21, 0.81] | 0.30 [0.14, 0.46] |
| เทียบกับ MCID สมมติ 5 คะแนน | CI ครอบทั้ง 0 และ 5: ยังสรุปไม่ได้ ต้องการข้อมูลเพิ่ม | CI ทั้งช่วงต่ำกว่า 5: มีผลจริงแต่น่าจะเล็กกว่าระดับที่มีความหมายทางคลินิก |
ผลสรุปที่สำคัญคือ ค่า p ของสองการศึกษาต่างกันเกือบพันเท่า ทั้งที่ขนาดผลเท่ากันทุกตำแหน่งทศนิยม ถ้าผู้เขียนรายงานเพียง “การศึกษา A ไม่มีนัยสำคัญ การศึกษา B มีนัยสำคัญ” ผู้อ่านจะเข้าใจผิดว่าทั้งสองงานให้ข้อสรุปตรงข้ามกัน การจำลองในภาพที่ 1 ขยายตัวอย่างนี้ไปยังขนาดตัวอย่าง 10 ถึง 500 คนต่อกลุ่ม โดยสุ่มข้อมูลใหม่ 2,000 ครั้งต่อขนาดตัวอย่าง จะเห็นว่าค่า p แกว่งมากระหว่างการศึกษาที่ทำซ้ำ และลดลงอย่างต่อเนื่องเมื่อ n เพิ่มขึ้น ขณะที่ผลจริงยังเท่าเดิม
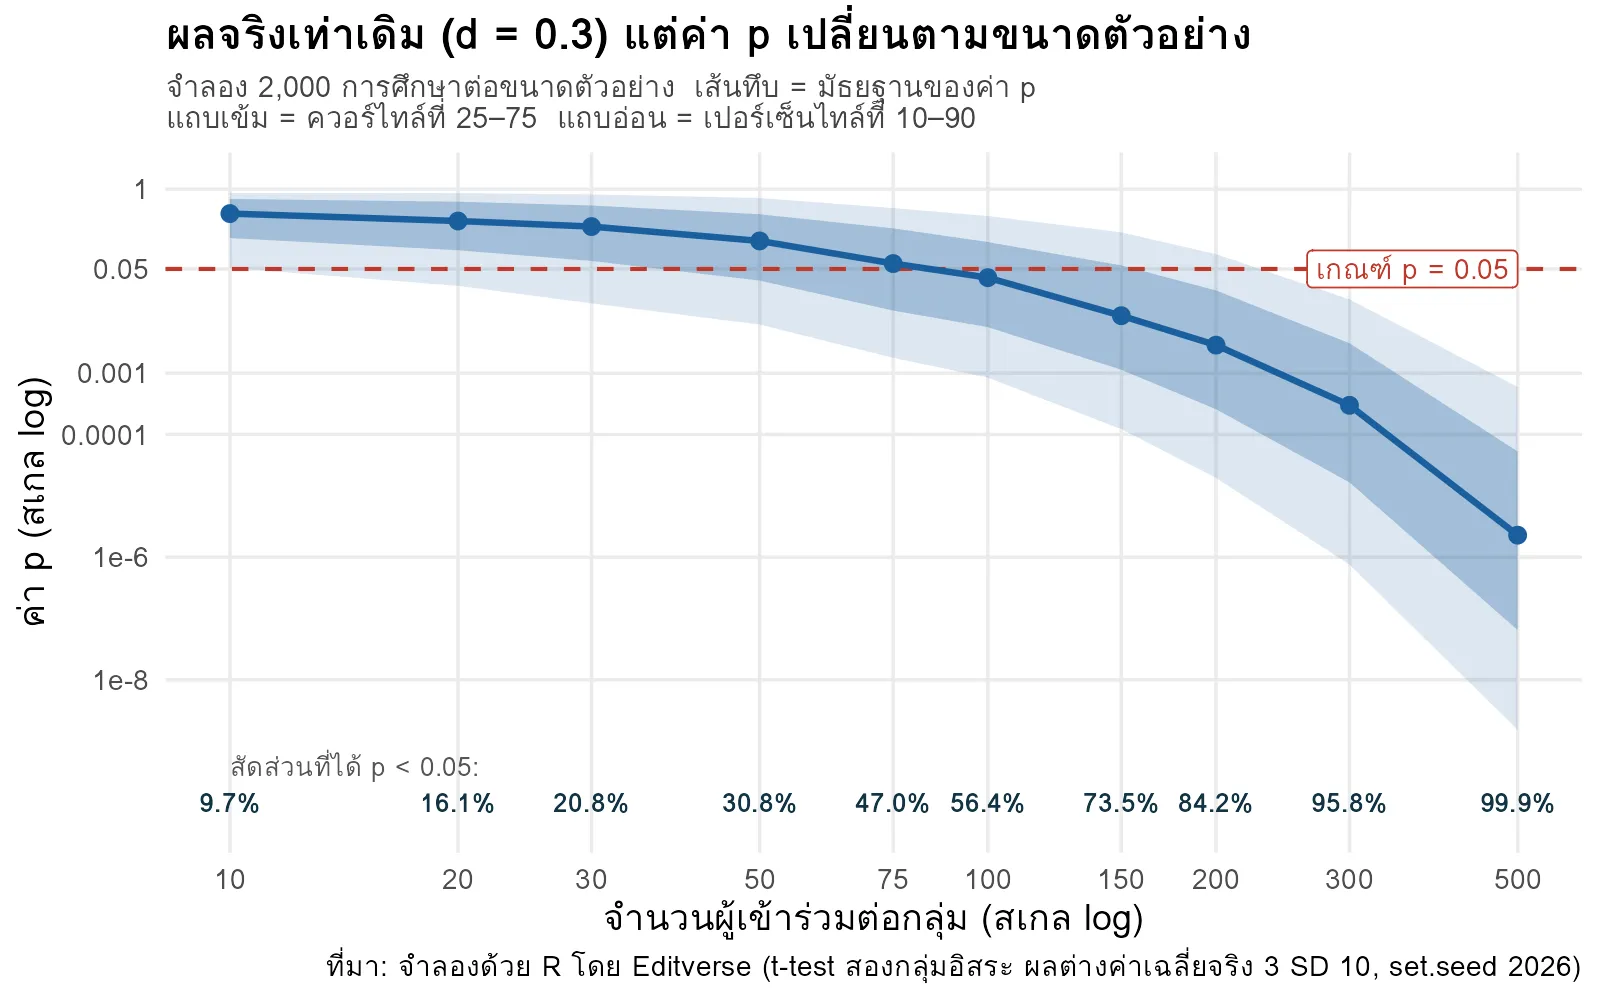
ภาพที่ 2 แสดงอีกด้านของเรื่องเดียวกัน เมื่อผลที่พบเท่ากับ d = 0.30 ทุกครั้ง สิ่งที่เปลี่ยนตามจำนวนตัวอย่างคือความกว้างของช่วงความเชื่อมั่นเท่านั้น CI ที่แคบทำให้ค่า p เล็ก แต่ไม่ได้ทำให้ผลใหญ่ขึ้น การรายงาน d พร้อม CI จึงบอกผู้อ่านได้ครบทั้งขนาดผลและความแม่นยำ ส่วนค่า p ให้ข้อมูลเพียงมิติเดียว ตัวอย่างนี้ยังชี้ว่าการศึกษา A มีจำนวนตัวอย่างไม่พอตั้งแต่แรก หากต้องการอำนาจการทดสอบ 80% ที่ d = 0.3 ต้องใช้ประมาณ 176 คนต่อกลุ่ม

โค้ด R ด้านล่างทำซ้ำตัวเลขทั้งหมดในตารางได้ และใช้เป็นแม่แบบสำหรับข้อมูลจริงของคุณ
# การศึกษา B: ผลต่างค่าเฉลี่ย 3 คะแนน, SD 10, 300 คนต่อกลุ่ม
n <- 300; md <- 3; s <- 10
se <- s * sqrt(2 / n)                      # 0.8165
t  <- md / se; df <- 2 * n - 2              # t = 3.674, df = 598
p  <- 2 * pt(-abs(t), df)                   # p = 0.00026
md + c(-1, 1) * qt(0.975, df) * se          # 95% CI 1.40 ถึง 4.60
d  <- md / s                                # Cohen's d = 0.30
d + c(-1, 1) * 1.96 * sqrt(2/n + d^2/(4*n)) # 95% CI ของ d 0.14 ถึง 0.46

# ถ้ามีข้อมูลดิบ ใช้คำสั่งสำเร็จรูปได้
# t.test(score ~ group, data = dat, var.equal = TRUE)
# effectsize::cohens_d(score ~ group, data = dat)

# จำนวนตัวอย่างที่ต้องใช้เพื่อมีอำนาจการทดสอบ 80% ที่ d = 0.3
power.t.test(delta = 3, sd = 10, power = 0.80)  # n = 175.4 -> 176 คนต่อกลุ่ม
ตัวอย่างจริง: Physicians’ Health Study กับค่า p ที่เล็กมาก
รายงานฉบับสุดท้ายของการทดลองแอสไพรินใน Physicians’ Health Study ตีพิมพ์ใน New England Journal of Medicine ปี 1989 เป็นตัวอย่างที่ดีว่าค่า p ที่เล็กมากกับขนาดผลเชิงสัมบูรณ์เป็นคนละเรื่องกัน การทดลองแบบสุ่มนี้ติดตามแพทย์ 22,071 คน เฉลี่ย 60.2 เดือน และพบว่าการกินแอสไพริน 325 มิลลิกรัมวันเว้นวันลดความเสี่ยงกล้ามเนื้อหัวใจตายได้ร้อยละ 44 (relative risk 0.56, 95% CI 0.45 ถึง 0.70, P < 0.00001) [8]
ตัวเลขทั้งหมดดูน่าประทับใจ แต่บทคัดย่อเดียวกันรายงานอุบัติการณ์ไว้ที่ 254.8 ต่อ 100,000 คนต่อปีในกลุ่มแอสไพริน เทียบกับ 439.7 ในกลุ่มยาหลอก [8] เมื่อคำนวณผลต่างสัมบูรณ์จะได้ 184.9 ต่อ 100,000 คนต่อปี หรือราว 0.18 จุดร้อยละต่อปี ตลอดระยะติดตามเฉลี่ยราว 5 ปี ผลต่างสัมบูรณ์อยู่ที่ประมาณ 0.9 จุดร้อยละ คิดเป็น number needed to treat ประมาณ 108 คนในห้าปีเพื่อป้องกันกล้ามเนื้อหัวใจตายหนึ่งครั้ง (ตัวเลขชุดนี้เราคำนวณเองจากอัตราในบทคัดย่อ) นอกจากนี้ การศึกษาเดียวกันไม่พบการลดลงของการเสียชีวิตจากโรคหัวใจและหลอดเลือดโดยรวม (relative risk 0.96, 95% CI 0.60 ถึง 1.54) [8]
บทเรียนสำหรับผู้เขียนคือ ค่า P < 0.00001 บอกเพียงว่าข้อมูลไม่เข้ากับสมมติฐานว่าไม่มีผล ส่วนการตัดสินใจทางคลินิกต้องอาศัยผลสัมพัทธ์ ผลสัมบูรณ์ และช่วงความเชื่อมั่นร่วมกัน ซึ่งเป็นเหตุผลที่ CONSORT 2010 ข้อ 17b แนะนำให้รายงานทั้งผลสัมพัทธ์และผลสัมบูรณ์สำหรับผลลัพธ์แบบสองค่า [9]
ต้องรายงาน Effect Size และช่วงความเชื่อมั่นอย่างไร
มาตรฐานการรายงานหลักทั้งสายการแพทย์และสายสังคมศาสตร์พูดในทิศทางเดียวกัน ข้อแนะนำของ ICMJE (ปรับปรุงมกราคม 2026) ส่วนสถิติระบุว่า ผู้เขียนควรแสดงผลเป็นตัวเลขพร้อมตัวบ่งชี้ความคลาดเคลื่อนหรือความไม่แน่นอนที่เหมาะสม เช่น ช่วงความเชื่อมั่น และหลีกเลี่ยงการพึ่งการทดสอบสมมติฐานเพียงอย่างเดียว เช่น ค่า P ซึ่งไม่ได้สื่อข้อมูลสำคัญเรื่องขนาดผลและความแม่นยำของการประมาณค่า [10] CONSORT 2010 ข้อ 17a กำหนดให้รายงานผลของแต่ละกลุ่ม ขนาดผลที่ประมาณได้ และความแม่นยำ เช่น 95% CI สำหรับผลลัพธ์หลักและรอง [9]
ตารางต่อไปนี้สรุป effect size ที่เหมาะกับการวิเคราะห์ที่พบบ่อยในวิทยานิพนธ์และบทความวิจัย ตัวเลขในคอลัมน์ขวาเป็นตัวอย่างรูปแบบการเขียน ยกเว้นตัวเลขในแถว RR และ ARD/NNT ซึ่งมาจาก Physicians’ Health Study (ARD และ NNT เราคำนวณเองจากบทคัดย่อ)
| รูปแบบการวิเคราะห์ | Effect size หลักที่ควรรายงาน | ตัวอย่างรูปแบบการเขียน |
|---|---|---|
| เปรียบเทียบค่าเฉลี่ยสองกลุ่ม (t-test) | ผลต่างค่าเฉลี่ยพร้อม 95% CI และ Cohen’s d หรือ Hedges’ g | Mdiff = 3.0, 95% CI [1.40, 4.60], d = 0.30 |
| ANOVA หลายกลุ่ม | η² หรือ partial η² (หรือ ω²) และผลต่างรายคู่พร้อม CI | F(2, 147) = 5.21, p = .007, η² = .07 |
| ตาราง 2×2 / ไคสแควร์ | Cramér’s V หรือ φ และสำหรับผลลัพธ์ทางคลินิกให้ RR หรือ OR พร้อม 95% CI | RR = 0.56, 95% CI [0.45, 0.70] |
| ผลลัพธ์แบบสองค่าในการทดลองทางคลินิก | ทั้งผลสัมพัทธ์ (RR/OR/HR) และผลสัมบูรณ์ (risk difference, NNT) ตาม CONSORT ข้อ 17b | ARD = 0.9 จุดร้อยละใน 5 ปี, NNT ≈ 108 |
| สหสัมพันธ์และการถดถอย | r พร้อม CI, สัมประสิทธิ์ B พร้อม 95% CI และ R² | B = 0.42, 95% CI [0.18, 0.66], R² = .12 |
หลักการเขียนผลที่ Reviewer คาดหวังมีสามส่วนเสมอ คือ ค่าประมาณ (point estimate) ช่วงความเชื่อมั่น และค่า p ที่แท้จริง เช่น “กลุ่มทดลองมีคะแนนความวิตกกังวลต่ำกว่ากลุ่มควบคุมเฉลี่ย 3.0 คะแนน (95% CI 1.4 ถึง 4.6; p < .001; d = 0.30)” จากนั้นในส่วน Discussion จึงตีความว่าขนาดผลนี้มีความหมายในทางปฏิบัติหรือไม่ โดยเทียบกับ MCID หรือหลักฐานจากงานก่อนหน้า ไม่ใช่เขียนเพียงว่า “พบความแตกต่างอย่างมีนัยสำคัญทางสถิติที่ระดับ .05” ซึ่งเป็นหนึ่งในจุดที่ทำให้บทความถูกส่งกลับตั้งแต่รอบแรก (ดูเพิ่มเติมใน 10 สาเหตุที่ทำให้บทความถูก Desk Rejected และวิธีป้องกัน)
ข้อควรระวังเรื่องเกณฑ์ 0.2, 0.5 และ 0.8 ของ Cohen คือ เกณฑ์เหล่านี้เป็นแนวทางทั่วไปสำหรับงานทางพฤติกรรมศาสตร์ ไม่ใช่มาตรฐานสากลสำหรับทุกสาขา [7] ในงานคลินิก ผลที่ d = 0.2 อาจสำคัญมากถ้าเป็นการลดอัตราตาย ส่วนในงานการศึกษา d = 0.5 อาจยังไม่คุ้มค่าถ้าโปรแกรมมีต้นทุนสูง การตีความจึงควรอิงบริบทของสาขาเสมอ
บริบทไทย: วารสารไทยและวิทยานิพนธ์คาดหวังอะไร
วารสารการแพทย์ไทยหลายฉบับอ้างอิงมาตรฐานสากลโดยตรง ตัวอย่างเช่น แนวทางสำหรับผู้เขียนของ Journal of the Medical Association of Thailand (J Med Assoc Thai) บนระบบ ThaiJO แนะนำอย่างยิ่งให้ผู้เขียนปฏิบัติตามแนวทางจริยธรรมการตีพิมพ์ของ COPE ข้อกำหนดการเตรียมต้นฉบับของ ICMJE และแนวทางการรายงานของเครือข่าย EQUATOR รวมถึงให้รายงานการทดลองแบบสุ่มตาม CONSORT 2010 เป็นขั้นต่ำ [11] เมื่อวารสารยึด ICMJE และ CONSORT การรายงานเพียงค่า p โดยไม่มีขนาดผลและ CI จึงสวนทางกับแนวทางที่วารสารแนะนำไว้เอง
ในสายสังคมศาสตร์และบริหารธุรกิจ นักวิชาการไทยก็เสนอประเด็นนี้ในวารสารไทยบนระบบ ThaiJO แล้ว บทความของสำเริง ไกยวงค์ ในวารสารปัญญาภิวัฒน์ ปี 2560 สรุปว่าผลลัพธ์ที่สำคัญที่สุดของการทดสอบสมมติฐานไม่ใช่ค่า p-value แต่เป็นขนาดผลกระทบ เพราะขนาดผลกระทบช่วยสื่อความสำคัญในทางปฏิบัติที่การทดสอบนัยสำคัญบอกไม่ได้ และผู้นำผลวิจัยไปปฏิบัติต้องการทราบขนาดของผลกระทบ ไม่ใช่เพียงนัยสำคัญทางสถิติ [12]
สำหรับวิทยานิพนธ์ระดับบัณฑิตศึกษา รูปแบบหนึ่งที่ยังพบได้คือการรายงานผลเป็นเครื่องหมายดอกจัน (* p < .05, ** p < .01) โดยไม่มีค่าประมาณหรือ CI เมื่อนำบทหนึ่งของวิทยานิพนธ์ไปเขียนเป็นบทความภาษาอังกฤษเพื่อส่งวารสารนานาชาติ ผู้เขียนควรปรับตารางผลใหม่ทั้งหมดให้มีผลต่างหรืออัตราส่วนพร้อม 95% CI ค่า p ที่แท้จริง และขนาดผลที่เหมาะกับสถิติที่ใช้ ประเด็นนี้ควรวางแผนตั้งแต่บท Methods โดยระบุ effect size ที่จะรายงานและเหตุผลของขนาดตัวอย่าง (อ่านเพิ่มเติมใน การเขียนส่วน Methods)
สรุป
- เขียนนิยามให้ถูก: p-value คือความน่าจะเป็นของข้อมูลแบบที่เห็นหรือสุดโต่งกว่า ภายใต้ สมมติฐานว่างและแบบจำลองที่ใช้ ไม่ใช่ความน่าจะเป็นที่สมมติฐานเป็นจริง
- รายงานค่า p ที่แท้จริง (เช่น p = .032) และใช้ p < .001 เมื่อค่าน้อยมาก แทนการใช้เครื่องหมายดอกจันหรือ “p < .05” อย่างเดียว
- ทุกผลการทดสอบหลักควรมีค่าประมาณ (ผลต่างค่าเฉลี่ย, RR, OR, HR, B) พร้อม 95% CI ตามที่ ICMJE แนะนำ (เมื่อเป็นไปได้) และ CONSORT ข้อ 17a กำหนดสำหรับการทดลองแบบสุ่ม
- เพิ่ม effect size มาตรฐานที่เหมาะกับการวิเคราะห์ (d หรือ g, η², Cramér’s V, r) และสำหรับผลลัพธ์แบบสองค่าทางคลินิกให้รายงานทั้งผลสัมพัทธ์และผลสัมบูรณ์
- กำหนด MCID หรือขนาดผลที่มีความหมายไว้ล่วงหน้า แล้วตีความ CI เทียบกับค่านั้น
- อย่าเขียนว่า “ไม่มีความแตกต่าง” เมื่อ p > 0.05 ให้รายงาน CI และบอกว่าข้อมูลยังเข้ากันได้กับผลขนาดใดบ้าง
- อย่าสรุปว่างานของคุณ “ขัดแย้ง” กับงานอื่นเพียงเพราะค่า p อยู่คนละฝั่งของ 0.05 ให้เทียบขนาดผลและ CI
- ระบุการคำนวณขนาดตัวอย่างหรืออำนาจการทดสอบในส่วน Methods เพื่อให้ผู้อ่านประเมินได้ว่าผลที่ไม่มีนัยสำคัญมาจากการขาดผลจริงหรือจากตัวอย่างไม่พอ
ถ้าคุณต้องการให้ผู้เชี่ยวชาญที่จบปริญญาเอกหรือแพทยศาสตร์ในสาขาเดียวกับงานของคุณตรวจว่าตารางผล ค่า p ขนาดผล และช่วงความเชื่อมั่นในต้นฉบับรายงานครบและตีความถูกต้องก่อนส่งวารสาร ดูรายละเอียดบริการตรวจสอบสถิติก่อนส่งวารสารของเรา เราตรวจและให้คำแนะนำบนข้อมูลและผลวิเคราะห์ของคุณ โดยไม่ได้ทำวิจัยแทนคุณ และไม่รับประกันผลการพิจารณาของวารสาร
คำถามที่พบบ่อย
p-value หมายถึงอะไร
ความน่าจะเป็นที่จะได้ข้อมูลแบบที่เห็นหรือสุดโต่งกว่า ภายใต้สมมติฐานว่างและแบบจำลองที่ใช้ ไม่ใช่ความน่าจะเป็นที่สมมติฐานเป็นจริง
p มากกว่า 0.05 แปลว่าไม่มีความแตกต่างหรือไม่
ไม่ใช่ ควรรายงานช่วงความเชื่อมั่นและบอกว่าข้อมูลยังเข้ากันได้กับผลขนาดใดบ้าง แทนการเขียนว่าไม่มีความแตกต่าง
ควรรายงาน effect size แบบใด
รายงานค่าประมาณ เช่น ผลต่างค่าเฉลี่ย RR OR หรือ HR พร้อม 95% CI และเพิ่ม effect size มาตรฐานที่เหมาะกับการวิเคราะห์ เช่น d, η² หรือ Cramér’s V
เอกสารอ้างอิง
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. doi:10.1080/00031305.2016.1154108
- Greenland, S., Senn, S. J., Rothman, K. J., Carlin, J. B., Poole, C., Goodman, S. N., & Altman, D. G. (2016). Statistical tests, P values, confidence intervals, and power: A guide to misinterpretations. European Journal of Epidemiology, 31(4), 337–350. doi:10.1007/s10654-016-0149-3 PMID: 27209009
- Sullivan, G. M., & Feinn, R. (2012). Using effect size—or why the P value is not enough. Journal of Graduate Medical Education, 4(3), 279–282. doi:10.4300/JGME-D-12-00156.1 PMID: 23997866
- American Statistical Association. (2016). American Statistical Association releases statement on statistical significance and p-values (press release, March 7, 2016). https://www.amstat.org/asa/files/pdfs/p-valuestatement.pdf
- Wasserstein, R. L., Schirm, A. L., & Lazar, N. A. (2019). Moving to a world beyond “p < 0.05″. The American Statistician, 73(sup1), 1–19. doi:10.1080/00031305.2019.1583913
- Amrhein, V., Greenland, S., & McShane, B. (2019). Scientists rise up against statistical significance. Nature, 567(7748), 305–307. doi:10.1038/d41586-019-00857-9 PMID: 30894741
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. doi:10.4324/9780203771587
- Steering Committee of the Physicians’ Health Study Research Group. (1989). Final report on the aspirin component of the ongoing Physicians’ Health Study. New England Journal of Medicine, 321(3), 129–135. doi:10.1056/NEJM198907203210301 PMID: 2664509
- Schulz, K. F., Altman, D. G., & Moher, D. (2010). CONSORT 2010 statement: Updated guidelines for reporting parallel group randomised trials. BMJ, 340, c332. doi:10.1136/bmj.c332 PMID: 20332509
- International Committee of Medical Journal Editors. (2026). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (updated January 2026), Section IV.A.3.d.iii Statistics. https://www.icmje.org/icmje-recommendations.pdf
- Journal of the Medical Association of Thailand. (n.d.). Submissions: Author guidelines. ThaiJO. https://he04.tci-thaijo.org/index.php/JMAThai/about/submissions
- สำเริง ไกยวงค์. (2560). ขนาดผลกระทบ: ผลลัพธ์ที่สำคัญที่สุดของการทดสอบสมมติฐาน. วารสารปัญญาภิวัฒน์, 9(1), 276–287. https://so05.tci-thaijo.org/index.php/pimjournal/article/view/85055
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ