SEM คืออะไร: CFA, AMOS หรือ SmartPLS และค่า Model Fit
SEM คือ แบบจำลองสมการโครงสร้าง (structural equation modeling) ที่ทดสอบความสัมพันธ์ระหว่างตัวแปรแฝงพร้อมกันทั้งโมเดล โดยมี CFA เป็นขั้นตรวจโมเดลการวัดก่อนทดสอบเส้นทาง ส่วนการเลือก AMOS หรือ SmartPLS และชุดค่า Model Fit ที่ต้องรายงานขึ้นกับว่างานเป็น CB-SEM หรือ PLS-SEM
SEM คือ อะไร และ CFA อยู่ตรงไหนในแบบจำลองสมการโครงสร้าง
งานวิจัยเชิงสำรวจจำนวนมากวัดสิ่งที่มองไม่เห็นโดยตรง เช่น ความพึงพอใจ ความเชื่อเรื่องยา หรือความผูกพันต่อองค์กร เราจึงใช้ข้อคำถามหลายข้อเป็น “ตัวชี้วัด” (indicator) ของ “ตัวแปรแฝง” (latent variable) หนึ่งตัว SEM รวมสองส่วนไว้ในโมเดลเดียว ส่วนแรกคือ โมเดลการวัด (measurement model) ที่บอกว่าข้อคำถามใดวัดตัวแปรแฝงใด และส่วนที่สองคือ โมเดลโครงสร้าง (structural model) ที่บอกว่าตัวแปรแฝงส่งผลต่อกันอย่างไร
การวิเคราะห์องค์ประกอบเชิงยืนยัน หรือ CFA (confirmatory factor analysis) คือการทดสอบเฉพาะโมเดลการวัด ผู้วิจัยกำหนดล่วงหน้าตามทฤษฎีว่าข้อคำถามแต่ละข้อโหลดบนองค์ประกอบใด แล้วดูว่าข้อมูลจริงสอดคล้องกับโครงสร้างนั้นหรือไม่ ซึ่งต่างจาก EFA ที่ปล่อยให้ข้อมูลจัดกลุ่มเอง ลำดับงานที่ผู้ทบทวนคาดหวังจึงมักเป็น ตรวจโมเดลการวัดด้วย CFA ให้ผ่านก่อน จากนั้นจึงทดสอบเส้นทางในโมเดลโครงสร้าง
CB-SEM กับ PLS-SEM: เลือก AMOS หรือ SmartPLS อย่างไร
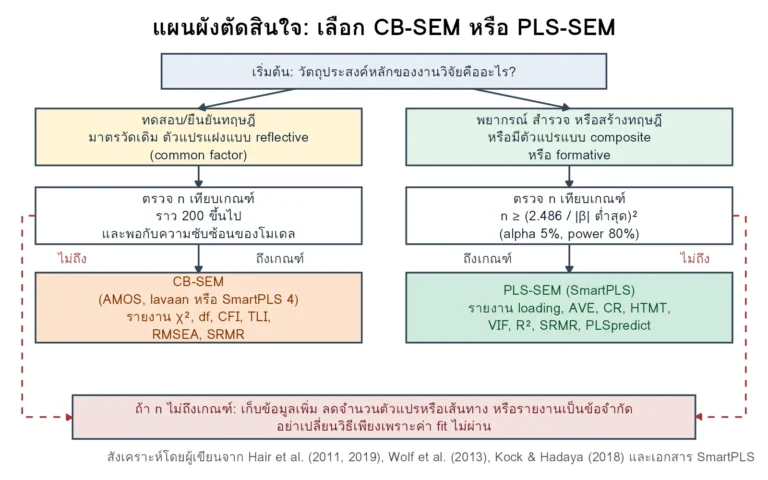
คำถามว่า “ใช้ AMOS หรือ SmartPLS ดี” ที่จริงคือคำถามว่าจะใช้ SEM ตระกูลไหน CB-SEM (covariance-based) ประมาณค่าเพื่อให้เมทริกซ์ความแปรปรวนร่วมที่โมเดลสร้างขึ้นใกล้กับข้อมูลจริงที่สุด จึงมีค่า Model Fit ไว้ทดสอบทฤษฎีทั้งโมเดล ส่วน PLS-SEM เป็น SEM แบบอิงความแปรปรวน (variance-based) ที่เน้นอธิบายและทำนายตัวแปรตาม Hair และคณะสรุปเหตุผลในการเลือก PLS-SEM ข้อพิจารณาเรื่องขนาดตัวอย่าง การแจกแจงข้อมูล และตัวชี้วัดที่ควรรายงาน รวมถึงวิธีใหม่อย่าง PLSpredict สำหรับประเมินการทำนายนอกตัวอย่าง [1]
| ประเด็น | CB-SEM (covariance-based) | PLS-SEM (variance-based) |
|---|---|---|
| หลักการประมาณค่า | หาค่าพารามิเตอร์ที่ทำให้เมทริกซ์ความแปรปรวนร่วมที่โมเดลสร้างขึ้นใกล้กับเมทริกซ์ของข้อมูลจริงมากที่สุด (เช่น ML) | สร้างคะแนนองค์ประกอบจากผลรวมถ่วงน้ำหนักของตัวชี้วัด แล้วประมาณเส้นทางเพื่อให้อธิบายความแปรปรวนของตัวแปรตามได้มากที่สุด |
| เป้าหมายหลัก | ยืนยันหรือทดสอบทฤษฎี และทดสอบว่าโมเดลทั้งโมเดลสอดคล้องกับข้อมูลหรือไม่ | อธิบายและทำนายตัวแปรตาม เหมาะกับงานเชิงสำรวจหรือโมเดลที่ซับซ้อน |
| ค่า Model Fit | เป็นหัวใจของการรายงาน: χ², CFI, TLI, RMSEA, SRMR | ใช้ชุดตัวชี้วัดของ PLS-SEM เอง ได้แก่ คุณภาพการวัด R² และความสามารถในการทำนาย (เช่น PLSpredict) ไม่ใช่ชุด CFI/TLI/RMSEA แบบ CB-SEM [1] |
| ความตรงเชิงจำแนก | Fornell-Larcker หรือ HTMT | แนะนำ HTMT เพราะ Fornell-Larcker และ cross-loadings ตรวจจับปัญหาได้ไม่ดีพอ |
| โปรแกรมที่พบบ่อย | IBM SPSS Amos, LISREL, Mplus, R (lavaan) | SmartPLS, R (เช่น seminr) |
ในเชิงโปรแกรม IBM SPSS Amos เป็นซอฟต์แวร์ CB-SEM ที่ผูกกับระบบ SPSS [2] ขณะที่ SmartPLS เริ่มจาก PLS-SEM แต่ปัจจุบันเว็บไซต์ทางการระบุว่ารองรับทั้ง PLS-SEM และ CB-SEM [3] ดังนั้นชื่อโปรแกรมไม่ได้บอกวิธีวิเคราะห์เสมอไป สิ่งที่ต้องเขียนในบทที่ 3 คือ “ใช้ CB-SEM ด้วยตัวประมาณค่าแบบใด” หรือ “ใช้ PLS-SEM พร้อม bootstrapping กี่รอบ” ไม่ใช่แค่ชื่อโปรแกรม ส่วนผู้ที่ไม่มีงบซื้อไลเซนส์ แพ็กเกจ lavaan ใน R เป็นซอฟต์แวร์โอเพนซอร์สฟรีที่ทำ CB-SEM ได้ [4] ดูการเปรียบเทียบเครื่องมือเพิ่มเติมได้ที่ SPSS vs R vs Python
กฎตัดสินใจแบบย่อ: ถ้าคำถามวิจัยคือ “ทฤษฎีนี้อธิบายข้อมูลได้หรือไม่” และตัวแปรแฝงเป็นแบบสะท้อน (reflective) ให้เริ่มที่ CB-SEM และรายงาน Model Fit เต็มชุด ถ้าเป้าหมายคือทำนายตัวแปรตาม โมเดลมีตัวแปรจำนวนมาก หรือมีตัวแปรแฝงแบบก่อรูป (formative) PLS-SEM มักเหมาะกว่า แต่ต้องรายงานตามมาตรฐานของ PLS-SEM โดยเฉพาะ ไม่ใช่ยกเกณฑ์ CFI หรือ RMSEA ของ CB-SEM มาใช้ตรง ๆ
ค่า Model Fit ที่ต้องรายงานและเกณฑ์ของ Hu และ Bentler (1999)
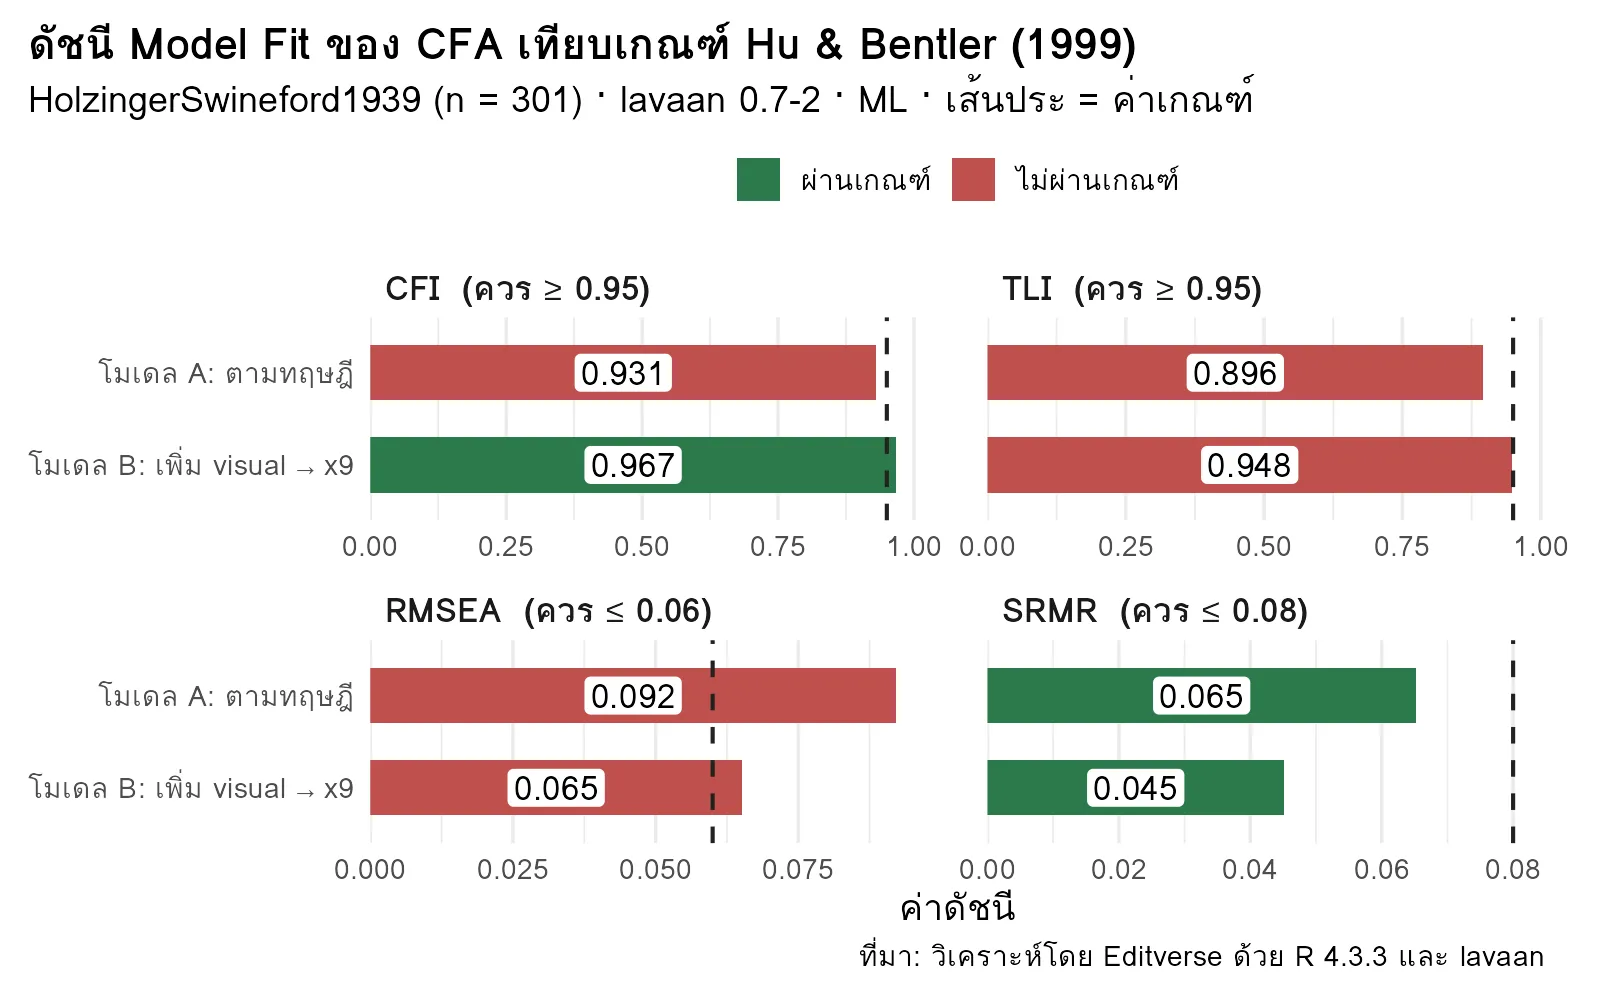
งานที่ถูกอ้างถึงมากที่สุดเรื่องนี้คือ Hu และ Bentler (1999) ซึ่งใช้การจำลองแล้วสรุปว่า เมื่อใช้ตัวประมาณ ML ควรได้ CFI และ TLI ใกล้ 0.95 SRMR ใกล้ 0.08 และ RMSEA ใกล้ 0.06 จึงจะสรุปได้ว่าโมเดลกลมกลืนกับข้อมูลค่อนข้างดี และแนะนำให้ดู SRMR คู่กับดัชนีอีกตัวหนึ่งเสมอ บทความเดียวกันยังเตือนว่า TLI และ RMSEA มีแนวโน้มปฏิเสธโมเดลที่ถูกต้องบ่อยเกินไปเมื่อขนาดตัวอย่างเล็ก [5] สังเกตคำว่า “ใกล้” (close to) ซึ่งต้นฉบับไม่ได้ตั้งใจให้เป็นเส้นตายตายตัว
| ดัชนี | อ่านอย่างไร | เกณฑ์ที่นิยมอ้าง | ข้อควรระวัง |
|---|---|---|---|
| χ² (df, p) | ทดสอบว่าโมเดลทำซ้ำเมทริกซ์ความแปรปรวนร่วมได้พอดีหรือไม่ ค่า p มากหมายถึงไม่พบความต่าง | p > .05 | ไวต่อขนาดตัวอย่าง ตัวอย่างใหญ่มักได้ p < .05 แม้โมเดลคลาดเพียงเล็กน้อย แต่ต้องรายงานเสมอ |
| CFI | เทียบความกลมกลืนของโมเดลกับโมเดลฐานที่ตัวแปรไม่สัมพันธ์กันเลย | ใกล้ 0.95 ขึ้นไป | ค่าสูงขึ้นได้ง่ายเมื่อใช้ตัวประมาณ DWLS กับข้อมูลอันดับ |
| TLI (NNFI) | คล้าย CFI แต่ลงโทษโมเดลที่มีพารามิเตอร์มาก | ใกล้ 0.95 ขึ้นไป | ปฏิเสธโมเดลที่ถูกต้องบ่อยเกินไปเมื่อตัวอย่างเล็ก |
| RMSEA [90% CI] | ความคลาดเคลื่อนต่อองศาอิสระในประชากร ยิ่งต่ำยิ่งดี | ใกล้ 0.06 หรือต่ำกว่า | ต้องรายงานช่วงความเชื่อมั่น 90% และระวังเมื่อ df น้อยหรือตัวอย่างเล็ก |
| SRMR | ค่าเฉลี่ยของเศษเหลือของสหสัมพันธ์ ยิ่งต่ำยิ่งดี | ใกล้ 0.08 หรือต่ำกว่า | Hu และ Bentler แนะนำให้ใช้คู่กับดัชนีอีกตัวหนึ่ง (two-index strategy) |
ทำไมเกณฑ์ 0.95 / 0.06 / 0.08 จึงไม่ใช่กฎเหล็ก
Marsh, Hau และ Wen (2004) เตือนตั้งแต่ปี 2004 ถึงอันตรายของการนำผลของ Hu และ Bentler ไปใช้เป็น “กฎทอง” กับทุกโมเดล [6] งานต่อมาของ McNeish และคณะแสดงว่าค่าดัชนีขึ้นกับคุณภาพการวัดอย่างมาก ค่า RMSEA 0.06 อาจหมายถึงโมเดลที่ไม่ดีเมื่อน้ำหนักองค์ประกอบมาตรฐานราว 0.40 และ RMSEA 0.20 อาจยอมรับได้เมื่อน้ำหนักราว 0.90 [7] McNeish และ Wolf จึงเสนอ dynamic fit index cutoffs ที่จำลองเกณฑ์ให้เข้ากับโมเดลและข้อมูลของงานนั้น ๆ พร้อมเครื่องมือออนไลน์ให้ใช้โดยไม่ต้องเขียนโค้ด [8]
อีกเรื่องที่นักวิจัยไทยพบบ่อยคือข้อมูลแบบมาตราส่วนประมาณค่า Xia และ Yang พบว่าเมื่อวิเคราะห์ข้อมูลอันดับด้วย DWLS หรือ ULS จะได้ RMSEA ต่ำกว่า และ CFI กับ TLI สูงกว่าการใช้ ML ในทุกเงื่อนไขที่ศึกษา การใช้เกณฑ์เดิมกับตัวประมาณเหล่านี้จึงมีแนวโน้มมองไม่เห็นความไม่กลมกลืน [9] ดังนั้นต้องระบุตัวประมาณค่าทุกครั้ง และไม่ควรอ้างว่า “ผ่านเกณฑ์” โดยไม่บอกว่าเกณฑ์นั้นมาจากเงื่อนไขใด
ตัวอย่าง CFA ทีละขั้นด้วย lavaan และข้อมูล HolzingerSwineford1939
เพื่อให้เห็นตัวเลขจริง เราใช้ชุดข้อมูล HolzingerSwineford1939 ซึ่งติดมากับแพ็กเกจ lavaan เป็นคะแนนแบบทดสอบความสามารถทางสมองของนักเรียนเกรด 7 และ 8 จากสองโรงเรียน (Pasteur และ Grant-White) จำนวน 301 คน โดยเวอร์ชันนี้เลือกมา 9 แบบทดสอบจากต้นฉบับ 26 แบบทดสอบ [10] โมเดลที่นิยมเสนอมีสามองค์ประกอบ ได้แก่ visual (x1–x3), textual (x4–x6) และ speed (x7–x9) ตามตัวอย่างในคู่มือทางการของ lavaan [11] ผลด้านล่างรันจริงโดย Editverse ด้วย R 4.3.3 และ lavaan 0.7-2
install.packages("lavaan")            # ครั้งแรกครั้งเดียว
library(lavaan)                        # ทดสอบกับ lavaan 0.7-2, R 4.3.3
data(HolzingerSwineford1939)           # n = 301, ตัวแปร x1–x9

HS.model <- ' visual  =~ x1 + x2 + x3
              textual =~ x4 + x5 + x6
              speed   =~ x7 + x8 + x9 '

fit <- cfa(HS.model, data = HolzingerSwineford1939)
summary(fit, fit.measures = TRUE, standardized = TRUE)
fitMeasures(fit, c("chisq","df","pvalue","cfi","tli",
                   "rmsea","rmsea.ci.lower","rmsea.ci.upper","srmr"))
modindices(fit, sort. = TRUE, maximum.number = 5)

# ข้อมูลไม่แจกแจงปกติ: ใช้ตัวประมาณแบบ robust
fit_mlr <- cfa(HS.model, data = HolzingerSwineford1939, estimator = "MLR")
ขั้นที่ 1: อ่านค่า Model Fit
| ดัชนี | โมเดล A: 3 องค์ประกอบตามทฤษฎี | โมเดล B: เพิ่ม visual → x9 | โมเดล A ด้วย MLR (robust) |
|---|---|---|---|
| χ² (df), p | 85.31 (24), p < .001 | 52.38 (23), p < .001 | 87.13 (24), p < .001 |
| CFI | 0.931 | 0.967 | 0.930 |
| TLI | 0.896 | 0.948 | 0.895 |
| RMSEA [90% CI] | 0.092 [0.071, 0.114] | 0.065 [0.042, 0.089] | 0.092 |
| SRMR | 0.065 | 0.045 | 0.065 |
| AIC | 7517.5 | 7486.6 | – |
โมเดล A ซึ่งเป็นโมเดลตามทฤษฎี ได้ χ²(24) = 85.31, p < .001, CFI = 0.931, TLI = 0.896, RMSEA = 0.092 [90% CI 0.071, 0.114] และ SRMR = 0.065 มีเพียง SRMR ที่ผ่านเกณฑ์ ส่วน CFI, TLI และ RMSEA ยังห่างจากเกณฑ์ของ Hu และ Bentler ชัดเจน แม้ขอบล่างของช่วงความเชื่อมั่นของ RMSEA (0.071) ก็ยังสูงกว่า 0.06 การใช้ตัวประมาณ MLR ซึ่งทนต่อข้อมูลที่ไม่แจกแจงปกติให้ผลแทบไม่ต่างกัน ข้อสรุปจึงไม่ได้มาจากปัญหาการแจกแจง
ขั้นที่ 2: ตรวจคุณภาพการวัด
น้ำหนักองค์ประกอบมาตรฐานทุกตัวมีนัยสำคัญ แต่ x2 (Cubes) ได้เพียง 0.424 เมื่อคำนวณ CR และ AVE จากน้ำหนักมาตรฐาน พบว่าองค์ประกอบ textual ผ่านทุกเกณฑ์ ขณะที่ visual และ speed มี AVE ต่ำกว่า 0.50 และ CR ต่ำกว่า 0.70 เล็กน้อย เกณฑ์ที่นิยมคือ น้ำหนักอย่างน้อย 0.50 และควรถึง 0.70, CR มากกว่า 0.70, AVE มากกว่า 0.50 และใช้ HTMT ไม่เกิน 0.85 สำหรับความตรงเชิงจำแนก [12] ส่วนเกณฑ์ Fornell-Larcker คือ AVE ของแต่ละองค์ประกอบต้องมากกว่ากำลังสองของสหสัมพันธ์กับองค์ประกอบอื่น [13] [14]
| เกณฑ์คุณภาพการวัด | ค่าที่นิยมใช้ | visual | textual | speed |
|---|---|---|---|---|
| น้ำหนักองค์ประกอบมาตรฐาน (λ) | ≥ 0.50 และควรถึง 0.70 | 0.42–0.77 | 0.84–0.86 | 0.57–0.72 |
| Composite reliability (CR) | > 0.70 | 0.63 | 0.89 | 0.69 |
| Average variance extracted (AVE) | > 0.50 | 0.37 | 0.72 | 0.43 |
| Fornell-Larcker: AVE > r² สูงสุดกับองค์ประกอบอื่น | AVE ต้องมากกว่า | 0.37 > 0.22 | 0.72 > 0.21 | 0.43 > 0.22 |
ขั้นที่ 3: ดัชนีปรับโมเดล (modification indices) และความเสี่ยงของการไล่ตามตัวเลข
ดัชนีปรับโมเดลสูงสุดคือให้ x9 โหลดบน visual ด้วย (MI = 36.4) รองลงมาคือให้ความคลาดเคลื่อนของ x7 กับ x8 สัมพันธ์กัน (MI = 34.1) เมื่อเพิ่มเส้นทาง visual → x9 (โมเดล B) χ² ลดลง 32.92 ที่ df ต่างกัน 1 (p < .001), CFI เพิ่มเป็น 0.967 และ SRMR ลดเป็น 0.045 แต่ TLI (0.948) และ RMSEA (0.065) ยังอยู่ใกล้เกณฑ์และไม่ถึงเกณฑ์อย่างเคร่งครัด
บทเรียนสำคัญคือการปรับโมเดลตามดัชนีเป็นการตัดสินใจจากข้อมูลชุดเดียวกับที่ใช้ทดสอบ จึงควรเพิ่มเส้นทางเฉพาะเมื่ออธิบายได้ด้วยทฤษฎี ในกรณีนี้ x9 เป็นแบบทดสอบแยกตัวอักษรเส้นตรงกับเส้นโค้งที่ต้องใช้ทั้งความเร็วและการรับรู้ทางสายตา จึงพอมีเหตุผลรองรับ ต้องรายงานทั้งโมเดลก่อนและหลังปรับ และถ้าเป็นไปได้ควรยืนยันกับข้อมูลชุดใหม่ การเพิ่มสหสัมพันธ์ของความคลาดเคลื่อนทีละคู่จนดัชนีผ่านเกณฑ์โดยไม่มีเหตุผล เป็นสิ่งที่ผู้ทบทวนมองออกและมักขอให้ชี้แจง
ตัวอย่างการเขียนรายงานผล
ผลการวิเคราะห์องค์ประกอบเชิงยืนยันด้วยตัวประมาณ ML (lavaan 0.7-2) พบว่าโมเดลสามองค์ประกอบตามทฤษฎีมีความกลมกลืนกับข้อมูลในระดับที่ยังไม่เพียงพอ χ²(24) = 85.31, p < .001, CFI = 0.931, TLI = 0.896, RMSEA = 0.092 [90% CI 0.071, 0.114], SRMR = 0.065 เมื่อเพิ่มน้ำหนักขององค์ประกอบ visual บนตัวชี้วัด x9 ตามเหตุผลเชิงเนื้อหา ความกลมกลืนดีขึ้นอย่างมีนัยสำคัญ Δχ²(1) = 32.92, p < .001 (CFI = 0.967, TLI = 0.948, RMSEA = 0.065 [0.042, 0.089], SRMR = 0.045) ทั้งนี้โมเดลที่ปรับแล้วควรได้รับการยืนยันในกลุ่มตัวอย่างใหม่
ขนาดตัวอย่างสำหรับ SEM: กฎหัวแม่มือและข้อควรระวัง
ในวิทยานิพนธ์ไทยมักเห็นการอ้าง “อย่างน้อย 200 คน” หรือ “10 คนต่อตัวแปร” Wolf และคณะ (2013) รวบรวมกฎที่พบบ่อยไว้สามแบบ ได้แก่ ขนาดตัวอย่างขั้นต่ำ 100 หรือ 200, 5 หรือ 10 ตัวอย่างต่อพารามิเตอร์ที่ประมาณค่า และ 10 ตัวอย่างต่อตัวแปร แล้วทดสอบด้วยการจำลอง Monte Carlo โดยกำหนดว่าต้องมีอำนาจการทดสอบอย่างน้อย 80% สำหรับทุกพารามิเตอร์ ค่าประมาณไม่ลำเอียง และไม่มีผลลัพธ์ผิดปกติ ผลคือขนาดตัวอย่างที่ต้องการแปรผันตั้งแต่ 30 ถึง 460 ราย ขึ้นกับโครงสร้างโมเดล [15]

ภาพที่ 2 แสดงว่าโมเดลสององค์ประกอบ องค์ประกอบละสามตัวชี้วัด ต้องการ 460 รายเมื่อน้ำหนักองค์ประกอบ 0.50 แต่ต้องการเพียง 120 รายเมื่อน้ำหนัก 0.80 และโมเดลที่มีตัวชี้วัดมากกว่าต้องการตัวอย่างน้อยกว่า Wolf และคณะยังพบว่าข้อมูลสูญหายเพิ่มความต้องการขึ้น เช่น โมเดลสององค์ประกอบที่น้ำหนัก 0.65 ต้องการ 200 รายเมื่อไม่มีข้อมูลสูญหาย แต่เพิ่มเป็น 260 รายเมื่อแต่ละตัวชี้วัดสูญหาย 5–10% [15] กฎ “200 คน” จึงอาจมากเกินจำเป็นในบางโมเดล และน้อยเกินไปในโมเดลที่ตัวชี้วัดอ่อน
ตัวอย่างคำนวณ: โมเดล A ข้างต้นมีพารามิเตอร์อิสระ 21 ตัว (น้ำหนัก 6 ตัวที่ไม่ได้ตรึงไว้ ความแปรปรวนของความคลาดเคลื่อน 9 ตัว ความแปรปรวนขององค์ประกอบ 3 ตัว และสหสัมพันธ์ระหว่างองค์ประกอบ 3 ตัว) กลุ่มตัวอย่าง 301 รายจึงเท่ากับ 301 ÷ 21 ≈ 14.3 รายต่อพารามิเตอร์ และเกินกฎ 10 คนต่อตัวแปรซึ่งให้ 9 × 10 = 90 ราย แต่ visual มีน้ำหนักต่ำสุดเพียง 0.42 ซึ่งตามผลของ Wolf และคณะเป็นเงื่อนไขที่ต้องการตัวอย่างมาก ข้อเสนอที่ป้องกันตัวได้ดีกว่าคือคาดการณ์น้ำหนักองค์ประกอบจากงานเดิม แล้วจำลองขนาดตัวอย่างสำหรับโมเดลของตนเอง (เช่น ฟังก์ชัน simulateData ใน lavaan) และเขียนเหตุผลไว้ในส่วนวิธีวิจัย ส่วนสูตร Yamane หรือตาราง Krejcie & Morgan ใช้ประมาณค่าสัดส่วนของประชากร ไม่ได้ออกแบบมาสำหรับความแม่นยำของพารามิเตอร์ใน SEM
บริบทไทย: ตัวอย่าง CFA จากบทความใน ThaiJO และสิ่งที่ผู้ทบทวนถาม
บทความ SEM และ CFA ของนักวิจัยไทยจำนวนมากเผยแพร่ในวารสารที่ค้นได้จากระบบ ThaiJO [16] ตัวอย่างที่ดีสำหรับศึกษาคือการวิเคราะห์องค์ประกอบเชิงยืนยันแบบสอบถามความเชื่อเกี่ยวกับการกินยาฉบับภาษาไทย ของยศพล เหลืองโสมนภา และคณะ ที่ตีพิมพ์ในวารสารศูนย์การศึกษาแพทยศาสตร์คลินิก โรงพยาบาลพระปกเกล้า ปี 2557 กลุ่มตัวอย่าง 500 รายจากโรงพยาบาลชุมชน 4 แห่ง วิเคราะห์ด้วย LISREL 8.52 และรายงาน χ² = 69.64, df = 83, p = 0.852, χ²/df = 0.84, GFI = 0.98, AGFI = 0.97, CFI = 1, TLI = 1, SRMR = 0.03 และ RMSEA = 0.00 [17]
ตัวอย่างนี้สอนอะไรได้สามข้อ ข้อแรก การรายงานครบทั้ง χ², df, p และดัชนีหลายกลุ่มทำให้ผู้อ่านตรวจสอบได้ ข้อสอง เมื่อ χ² มีค่าน้อยกว่า df ค่า RMSEA จะคำนวณออกมาเป็น 0 และ CFI ถูกจำกัดไว้ที่ 1 ตามสูตร ตัวเลขที่ดูสมบูรณ์แบบจึงเป็นผลทางคณิตศาสตร์ ไม่ได้แปลว่าโมเดลไม่มีข้อจำกัด ข้อสาม งานไทยนิยมรายงาน χ²/df, GFI และ AGFI ซึ่งไม่อยู่ในชุดเกณฑ์ของ Hu และ Bentler หากจะใช้ ควรอ้างแหล่งของเกณฑ์ให้ชัด และรายงาน CFI, TLI, RMSEA พร้อมช่วงความเชื่อมั่น และ SRMR ควบคู่เสมอ
ข้อผิดพลาดที่ผู้ทบทวนและกรรมการสอบมักทักท้วง
- รายงานเฉพาะดัชนีที่ผ่าน แล้วตัดดัชนีที่ไม่ผ่านออก ควรรายงานชุดเดียวกันทุกโมเดลที่เปรียบเทียบ
- ไม่ระบุตัวประมาณค่า (ML, MLR, WLSMV) ทั้งที่ข้อมูลเป็นมาตรประมาณค่าและค่าดัชนีขึ้นกับตัวประมาณ [9]
- ปรับโมเดลตาม MI จนผ่านเกณฑ์ โดยไม่อธิบายเหตุผลทางทฤษฎีและไม่รายงานโมเดลเดิม
- ยกเกณฑ์ CB-SEM ไปตัดสิน PLS-SEM แทนการรายงานคุณภาพการวัด R² และความสามารถในการทำนายตามแนวทางของ PLS-SEM [1]
- ใช้ Fornell-Larcker อย่างเดียว ใน PLS-SEM ทั้งที่มีหลักฐานว่าตรวจจับการขาดความตรงเชิงจำแนกได้ไม่ดี [14]
- อ้างขนาดตัวอย่างด้วยกฎหัวแม่มือ โดยไม่พิจารณาน้ำหนักองค์ประกอบ จำนวนตัวชี้วัด และข้อมูลสูญหาย [15]
หากวารสารเป้าหมายใช้รูปแบบ APA มาตรฐาน JARS-Quant ของสมาคมจิตวิทยาอเมริกันมีโมดูลเฉพาะสำหรับการรายงาน SEM ซึ่งใช้เป็นรายการตรวจสอบก่อนส่งได้ดี [18] และควรอธิบายขั้นตอนทั้งหมดในส่วนวิธีวิจัยตามแนวทางใน การเขียนส่วน Methods ส่วนนักศึกษาที่ยังอยู่ในขั้นเสนอโครงร่าง ควรระบุแผน CFA และ SEM ตั้งแต่บทที่ 3 ตามที่อธิบายไว้ใน การเขียนโครงร่างวิทยานิพนธ์ในไทย
สรุป
- แยกให้ชัดว่างานเป็น CB-SEM (ทดสอบทฤษฎี) หรือ PLS-SEM (เน้นทำนาย) แล้วระบุวิธีและตัวประมาณค่า ไม่ใช่แค่ชื่อโปรแกรม
- ตรวจโมเดลการวัดด้วย CFA ก่อนทดสอบเส้นทางในโมเดลโครงสร้าง
- CB-SEM: รายงาน χ²(df), p, CFI, TLI, RMSEA พร้อม 90% CI และ SRMR ทุกโมเดลที่เปรียบเทียบ
- อ้างเกณฑ์ Hu และ Bentler (1999) อย่างระมัดระวัง และระบุว่าเป็นค่า “ใกล้” ไม่ใช่เส้นตาย โดยเฉพาะกับข้อมูลอันดับหรือตัวประมาณ DWLS
- รายงานน้ำหนักองค์ประกอบมาตรฐาน CR, AVE และ HTMT หรือ Fornell-Larcker
- ปรับโมเดลตาม MI เฉพาะที่มีเหตุผลทางทฤษฎี รายงานทั้งก่อนและหลังปรับ และ Δχ²
- ให้เหตุผลขนาดตัวอย่างจากลักษณะโมเดล (น้ำหนักองค์ประกอบ จำนวนตัวชี้วัด ข้อมูลสูญหาย) หรือการจำลอง ไม่ใช่กฎหัวแม่มืออย่างเดียว
หากคุณมีผล CFA หรือ SEM จาก AMOS, SmartPLS, LISREL หรือ R อยู่แล้วและต้องการให้ผู้เชี่ยวชาญตรวจว่าเลือกวิธีถูก อ่านค่าครบ และเขียนรายงานตรงตามมาตรฐานที่วารสารต้องการ ทีม วิเคราะห์สถิติ ของ Editverse มีบรรณาธิการที่จบปริญญาเอกหรือแพทยศาสตร์ในสาขาของคุณช่วยตรวจสอบและขัดเกลางาน เราแก้ไขและยกระดับงานของคุณ — เราไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
CB-SEM กับ PLS-SEM ต่างกันอย่างไร
CB-SEM เหมาะกับการทดสอบทฤษฎี ส่วน PLS-SEM เน้นการทำนาย ควรระบุวิธีและตัวประมาณค่า ไม่ใช่ระบุเพียงชื่อโปรแกรม
ต้องรายงานค่า Model Fit อะไรบ้าง
สำหรับ CB-SEM ให้รายงาน χ²(df), p, CFI, TLI, RMSEA พร้อม 90% CI และ SRMR ของทุกโมเดลที่เปรียบเทียบ
เกณฑ์ของ Hu และ Bentler (1999) เป็นเส้นตายหรือไม่
ไม่ใช่ เป็นค่าที่ควรใกล้เคียงตามที่ผู้เสนอตั้งใจ โดยเฉพาะกับข้อมูลอันดับหรือตัวประมาณ DWLS จึงควรอ้างอย่างระมัดระวัง
เอกสารอ้างอิง
- Hair, J. F., Risher, J. J., Sarstedt, M., & Ringle, C. M. (2019). When to use and how to report the results of PLS-SEM. European Business Review, 31(1), 2–24. doi:10.1108/EBR-11-2018-0203
- IBM. (n.d.). IBM SPSS Amos. https://www.ibm.com/products/structural-equation-modeling-sem
- SmartPLS GmbH. (n.d.). SmartPLS: Statistical software for PLS-SEM and CB-SEM. https://www.smartpls.com/
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1–36. doi:10.18637/jss.v048.i02
- Hu, L., & Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis: Conventional criteria versus new alternatives. Structural Equation Modeling: A Multidisciplinary Journal, 6(1), 1–55. doi:10.1080/10705519909540118
- Marsh, H. W., Hau, K.-T., & Wen, Z. (2004). In search of golden rules: Comment on hypothesis-testing approaches to setting cutoff values for fit indexes and dangers in overgeneralizing Hu and Bentler’s (1999) findings. Structural Equation Modeling: A Multidisciplinary Journal, 11(3), 320–341. doi:10.1207/s15328007sem1103_2
- McNeish, D., An, J., & Hancock, G. R. (2018). The thorny relation between measurement quality and fit index cutoffs in latent variable models. Journal of Personality Assessment, 100(1), 43–52. doi:10.1080/00223891.2017.1281286 PMID: 28631976
- McNeish, D., & Wolf, M. G. (2023). Dynamic fit index cutoffs for confirmatory factor analysis models. Psychological Methods, 28(1), 61–88. doi:10.1037/met0000425 PMID: 34694832
- Xia, Y., & Yang, Y. (2019). RMSEA, CFI, and TLI in structural equation modeling with ordered categorical data: The story they tell depends on the estimation methods. Behavior Research Methods, 51(1), 409–428. doi:10.3758/s13428-018-1055-2 PMID: 29869222
- Rosseel, Y., et al. (n.d.). HolzingerSwineford1939: Holzinger and Swineford Dataset (9 Variables). lavaan R Documentation. https://search.r-project.org/CRAN/refmans/lavaan/html/HolzingerSwineford1939.html
- lavaan.org. (n.d.). A CFA example. https://lavaan.ugent.be/tutorial/cfa.html
- Cheung, G. W., Cooper-Thomas, H. D., Lau, R. S., & Wang, L. C. (2024). Reporting reliability, convergent and discriminant validity with structural equation modeling: A review and best-practice recommendations. Asia Pacific Journal of Management, 41(2), 745–783. doi:10.1007/s10490-023-09871-y
- Fornell, C., & Larcker, D. F. (1981). Evaluating structural equation models with unobservable variables and measurement error. Journal of Marketing Research, 18(1), 39–50. doi:10.1177/002224378101800104
- Henseler, J., Ringle, C. M., & Sarstedt, M. (2015). A new criterion for assessing discriminant validity in variance-based structural equation modeling. Journal of the Academy of Marketing Science, 43(1), 115–135. doi:10.1007/s11747-014-0403-8
- Wolf, E. J., Harrington, K. M., Clark, S. L., & Miller, M. W. (2013). Sample size requirements for structural equation models: An evaluation of power, bias, and solution propriety. Educational and Psychological Measurement, 73(6), 913–934. doi:10.1177/0013164413495237 PMID: 25705052
- Thai Journals Online (ThaiJO). (n.d.). ค้นหาบทความและวารสารวิชาการไทย. https://www.tci-thaijo.org/
- ยศพล เหลืองโสมนภา, สิริรัตน์ เหลืองโสมนภา, สาคร พร้อมเพราะ, ปาลีรัญญ์ ฐาสิรสวัสดิ์, รุ่งนภา เขียวชะอ่ำ, & วารุณี สุวรวัฒนกุล. (2557). การวิเคราะห์องค์ประกอบเชิงยืนยันแบบสอบถามความเชื่อเกี่ยวกับการกินยาฉบับภาษาไทย. วารสารศูนย์การศึกษาแพทยศาสตร์คลินิก โรงพยาบาลพระปกเกล้า, 31(4), 297–310. https://he02.tci-thaijo.org/index.php/ppkjournal/article/view/67930
- Appelbaum, M., Cooper, H., Kline, R. B., Mayo-Wilson, E., Nezu, A. M., & Rao, S. M. (2018). Journal article reporting standards for quantitative research in psychology: The APA Publications and Communications Board task force report. American Psychologist, 73(1), 3–25. doi:10.1037/amp0000191 PMID: 29345484
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ