ตาราง Krejcie and Morgan: วิธีอ่านและใช้กำหนดกลุ่มตัวอย่าง
ตาราง Krejcie and Morgan คือตารางสำเร็จรูปจากบทความปี 1970 ที่บอกขนาดกลุ่มตัวอย่างขั้นต่ำสำหรับประชากรที่ทราบจำนวนแน่นอน โดยคำนวณจากสูตรไคสแควร์ที่ระดับความเชื่อมั่น 95% ความคลาดเคลื่อน ±5% และสัดส่วน 0.5 — บทความนี้อธิบายที่มาของสูตร วิธีอ่านตารางทีละขั้น ตัวอย่างการคำนวณ และข้อจำกัดที่กรรมการสอบวิทยานิพนธ์มักถาม
ตาราง Krejcie and Morgan คืออะไร และมาจากไหน
ตารางนี้ตีพิมพ์ครั้งแรกในบทความสั้นเพียง 4 หน้าชื่อ “Determining Sample Size for Research Activities” โดย Robert V. Krejcie และ Daryle W. Morgan ในวารสาร Educational and Psychological Measurement ปีที่ 30 ฉบับที่ 3 หน้า 607–610 เมื่อปี ค.ศ. 1970 (Krejcie & Morgan, 1970) จุดประสงค์ของผู้เขียนคือให้นักวิจัยที่ทำการสำรวจกับประชากรขนาดจำกัด เช่น ครูทั้งเขตพื้นที่ นักศึกษาทั้งคณะ หรือบุคลากรทั้งโรงพยาบาล สามารถเปิดตารางแล้วอ่านค่าได้ทันทีโดยไม่ต้องคำนวณเอง ในยุคที่ยังไม่มีคอมพิวเตอร์ส่วนบุคคล ตารางแบบนี้จึงช่วยประหยัดเวลาได้มาก
ตารางประกอบด้วยคู่ตัวเลขสองคอลัมน์ คือ N (ขนาดประชากร) และ S (ขนาดกลุ่มตัวอย่างที่แนะนำ) เริ่มจากประชากร 10 คนไปจนถึง 1,000,000 คน ปัจจุบันบทความนี้ถูกอ้างอิงในฐานข้อมูล Crossref มากกว่า 9,500 ครั้ง (ตรวจสอบผ่าน Crossref API เมื่อตุลาคม 2026) และยังปรากฏในบทที่ 3 ของงานวิจัยเชิงสำรวจทั้งในไทยและต่างประเทศ ดังตัวอย่างที่ยกไว้ด้านล่าง
สิ่งที่ต้องเข้าใจตั้งแต่ต้นคือ ตารางนี้ไม่ใช่ “กฎ” ที่ใช้ได้กับทุกงานวิจัย แต่เป็นผลคำนวณของสูตรหนึ่งสูตรภายใต้สมมติฐานชุดหนึ่ง หากงานวิจัยของคุณไม่ตรงกับสมมติฐานนั้น ตัวเลขในตารางก็ไม่ใช่คำตอบที่ถูกต้อง
สูตรเบื้องหลังตาราง: ไคสแควร์ 3.841, P = 0.5 และ d = 0.05
ค่าทุกค่าในตารางได้มาจากสูตรเดียวกัน ซึ่งผู้เขียนแสดงไว้ในบทความต้นฉบับ ดังนี้
s = χ² N P(1 − P) ÷ [ d² (N − 1) + χ² P(1 − P) ]
- s = ขนาดกลุ่มตัวอย่างที่ต้องการ
- N = ขนาดประชากร (ต้องทราบจำนวนที่แน่นอน)
- χ² = ค่าไคสแควร์ที่องศาอิสระ 1 ระดับความเชื่อมั่น 95% เท่ากับ 3.841 ซึ่งก็คือ 1.96² นั่นเอง
- P = สัดส่วนของลักษณะที่สนใจในประชากร ตารางกำหนดไว้ที่ 0.50 เพราะทำให้ค่า P(1 − P) สูงที่สุด (0.25) จึงได้ขนาดตัวอย่างที่ “ปลอดภัยที่สุด” เมื่อไม่ทราบสัดส่วนจริง
- d = ระดับความคลาดเคลื่อนที่ยอมรับได้ ตารางใช้ 0.05 หรือ ±5 จุดร้อยละ
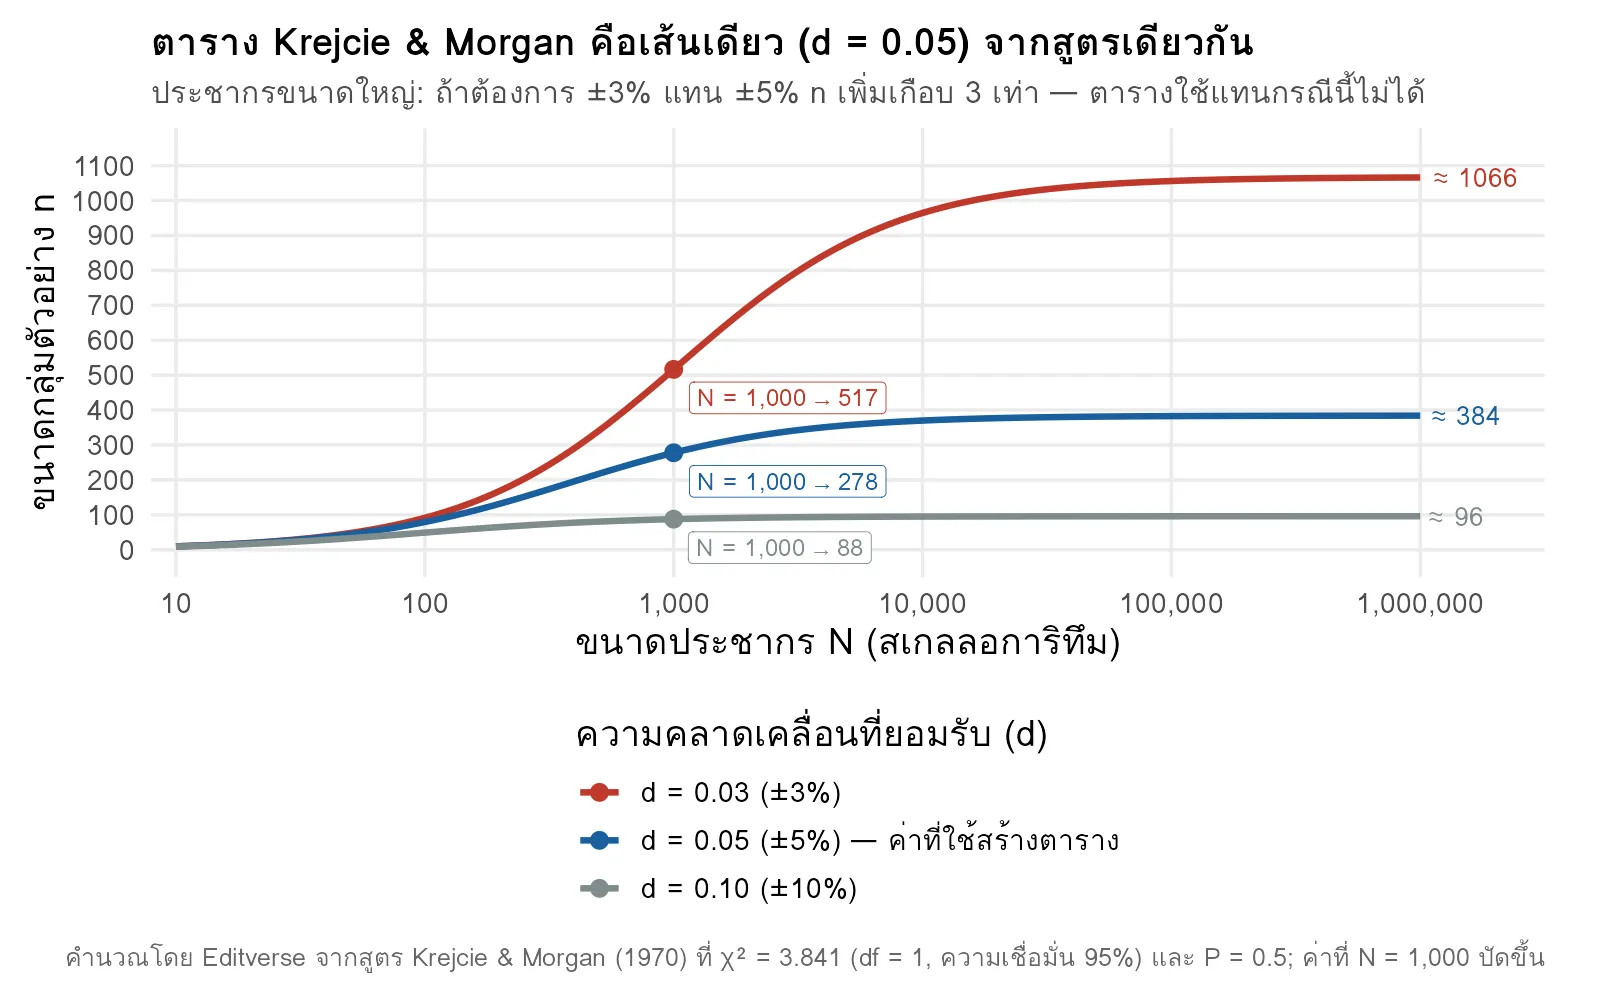
เมื่อจัดรูปสูตรใหม่จะเห็นว่าเป็นสูตรเดียวกับการประมาณค่าสัดส่วนแบบสุ่มอย่างง่าย แล้วปรับแก้สำหรับประชากรขนาดจำกัด (finite population correction) กล่าวคือ ถ้าประชากรใหญ่มากจนเกือบไม่จำกัด ค่า s จะเข้าใกล้ 3.841 × 0.25 ÷ 0.0025 ≈ 384.1 ซึ่งเป็นเหตุผลที่ตัวเลขท้ายตารางหยุดอยู่ราว 384 คน ไม่ว่าประชากรจะเป็นแสนหรือล้านคน ในทางกลับกัน ถ้าประชากรเล็ก เช่น 100 คน สูตรให้ประมาณ 80 คน หรือเกือบทั้งหมดของประชากร
ประเด็นสำคัญคือ ตารางทั้งตารางเป็นเพียง “เส้นเดียว” ของสูตรนี้ ที่ d = 0.05 หากคุณต้องการความแม่นยำสูงขึ้น (เช่น ±3%) หรือยอมรับความคลาดเคลื่อนมากขึ้น (เช่น ±10%) ต้องคำนวณจากสูตรเอง ไม่สามารถใช้ตารางได้ ภาพที่ 1 แสดงให้เห็นว่าค่า d เปลี่ยนขนาดตัวอย่างได้มากเพียงใด
วิธีอ่านตาราง Krejcie & Morgan ทีละขั้น
การอ่านตารางดูเหมือนง่าย แต่ข้อผิดพลาดที่พบบ่อยในบทที่ 3 ของวิทยานิพนธ์มักเกิดจากขั้นตอนเล็ก ๆ เหล่านี้ ให้ทำตามลำดับดังนี้
- นิยามประชากรให้ชัด ว่าใคร อยู่ที่ไหน ช่วงเวลาใด และนับได้กี่คน พร้อมระบุแหล่งที่มาของตัวเลข N
- ตรวจว่าวัตถุประสงค์เข้ากับตาราง คือเป็นการสำรวจเพื่อประมาณค่าสัดส่วนหรือค่าเฉลี่ยเชิงพรรณนา และจะสุ่มตัวอย่างแบบใช้ความน่าจะเป็น
- หาแถว N ในตาราง หาก N ตรงกับแถวใดให้อ่านค่า S ในแถวนั้น
- ถ้า N อยู่ระหว่างสองแถว ให้เลือกแถวที่ N มากกว่า (ค่า S สูงกว่า) เพื่อให้ได้ขนาดตัวอย่างไม่ต่ำกว่าที่สูตรกำหนด หรือคำนวณจากสูตรโดยตรงแล้วปัดขึ้นเป็นจำนวนเต็ม
- เพิ่มจำนวนเผื่อการไม่ตอบกลับ เพราะค่า S คือจำนวนแบบสอบถามที่ต้อง “ได้คืนและใช้ได้” ไม่ใช่จำนวนที่แจก
- รายงานพารามิเตอร์ครบ ได้แก่ N, ระดับความเชื่อมั่น 95%, d = 0.05, P = 0.5 และวิธีปัดเศษ
ตารางด้านล่างแสดงค่าที่คำนวณจากสูตรสำหรับประชากรบางขนาด เพื่อให้เห็นรูปแบบของตัวเลข (ตารางต้นฉบับปัดเศษเป็นจำนวนเต็ม ค่าบางแถวจึงอาจต่างจากที่คำนวณได้เล็กน้อย)
| ขนาดประชากร (N) | ขนาดตัวอย่างจากสูตร (s) | สัดส่วน s/N |
|---|---|---|
| 100 | 80 | 80% |
| 500 | 217 | 43% |
| 1,000 | 278 | 28% |
| 5,000 | 357 | 7% |
| 10,000 | 370 | 3.7% |
| 1,000,000 | 384 | 0.04% |
สังเกตว่าเมื่อประชากรเพิ่มจาก 1,000 เป็น 1,000,000 คน (พันเท่า) ขนาดตัวอย่างเพิ่มจาก 278 เป็นเพียง 384 คน ข้อเท็จจริงนี้ช่วยตอบคำถามที่นักศึกษามักกังวลว่า “ประชากรใหญ่ขนาดนี้ ต้องเก็บหลายพันคนหรือไม่” คำตอบคือไม่จำเป็น หากวัตถุประสงค์และวิธีสุ่มตรงกับสมมติฐานของตาราง

ตัวอย่างการคำนวณ: จากประชากร 1,250 คนสู่จำนวนแบบสอบถามที่ต้องแจก
สมมติว่านักศึกษาปริญญาโทต้องการสำรวจความพึงพอใจต่อระบบการเรียนออนไลน์ของนักศึกษาชั้นปีที่ 4 ในสามคณะ (ตัวเลขสมมติเพื่อการสาธิต) คณะ ก มี 500 คน คณะ ข มี 450 คน และคณะ ค มี 300 คน รวม N = 1,250 คน
ขั้นที่ 1 หาขนาดตัวอย่างรวม
วิธีอ่านตาราง: ไม่มีแถว N = 1,250 ในตาราง ค่าอยู่ระหว่างแถว 1,200 (S = 291) และ 1,300 (S = 297) จึงเลือกแถวที่มากกว่า ได้ 297 คน
วิธีคำนวณจากสูตร: s = 3.841 × 1,250 × 0.25 ÷ [0.0025 × 1,249 + 3.841 × 0.25] = 1,200.46 ÷ 4.083 ≈ 294.02 ปัดขึ้นเป็น 295 คน
ทั้งสองวิธีถูกต้อง ความต่างเพียง 2 คนมาจากการเลือกแถวที่สูงกว่า ในการรายงานให้ระบุชัดเจนว่าใช้วิธีใด ในตัวอย่างนี้เราเลือกใช้ 297 คนตามตาราง
ขั้นที่ 2 แบ่งตามสัดส่วน (Proportional stratified sampling)
- คณะ ก: 297 × 500/1,250 = 118.8 → 119 คน
- คณะ ข: 297 × 450/1,250 = 106.9 → 107 คน
- คณะ ค: 297 × 300/1,250 = 71.3 → 71 คน
รวมได้ 297 คนพอดี จากนั้นสุ่มอย่างง่ายภายในแต่ละคณะจากรายชื่อนักศึกษาที่ได้รับจากงานทะเบียน
ขั้นที่ 3 เผื่ออัตราการตอบกลับ
หากคาดว่าอัตราการตอบกลับจะอยู่ราว 65% จำนวนที่ต้องแจกคือ 297 ÷ 0.65 ≈ 456.9 → 457 ฉบับ (แบ่งตามสัดส่วนเดิมได้ประมาณ 183, 165 และ 110 ฉบับ เมื่อปัดขึ้นทุกชั้น รวม 458 ฉบับ) ขั้นตอนนี้มักถูกมองข้าม ทั้งที่ทำให้ขนาดตัวอย่างจริงต่ำกว่าเกณฑ์ได้ง่ายที่สุด ดังตัวอย่างจริงในหัวข้อถัดไป
ตัวอย่างจริงจากงานวิจัยที่ตีพิมพ์
ตัวอย่างที่ 1 — การเลือกแถวที่สูงกว่า: Kamali และคณะ (2021) ศึกษาพฤติกรรมการค้นคืนภาพของนักศึกษาแพทย์ชั้นปีที่ 4–5 จำนวน 816 คน และระบุในบทคัดย่อว่าใช้ตาราง Morgan and Krejcie ได้กลุ่มตัวอย่าง 265 คน คัดเลือกด้วยการสุ่ม เมื่อตรวจกับสูตร ค่าที่ N = 816 คือ 261.4 (ปัดขึ้นเป็น 262) ส่วนตารางมีแถว 800 (S = 260) และ 850 (S = 265) ค่า 265 จึงสอดคล้องกับหลักการเลือกแถวที่สูงกว่า ซึ่งเป็นแนวปฏิบัติที่ตรวจสอบย้อนได้
ตัวอย่างที่ 2 — ขนาดตัวอย่างที่วิเคราะห์จริงต่ำกว่าที่ตารางกำหนด: Rezaei และคณะ (2020) สำรวจความเครียดของนักศึกษาผดุงครรภ์ในอิหร่าน ประชากร N = 150 คน กำหนดกลุ่มตัวอย่าง 108 คนด้วยตาราง Krejcie and Morgan แต่ข้อมูลที่นำมาวิเคราะห์จริงมีเพียง 70 คน (ผู้วิจัยรายงานเป็นอัตราตอบกลับ 64.8%) เนื่องจากมีผู้ที่ไม่ผ่านเกณฑ์คัดเข้า-คัดออกหรือกรอกแบบสอบถามไม่สมบูรณ์ แปลว่าขนาดตัวอย่างที่ใช้วิเคราะห์จริงต่ำกว่าที่ตารางกำหนดไปประมาณหนึ่งในสาม หากผู้วิจัยเผื่อการสูญเสียตัวอย่างจากการตอบไม่ครบและการคัดออกตั้งแต่ต้น ปัญหานี้จะลดลงได้ และเมื่อเกิดขึ้นแล้วควรอภิปรายในส่วนข้อจำกัดอย่างตรงไปตรงมา
ทั้งสองตัวอย่างแสดงว่ากรรมการหรือผู้ทบทวนสามารถตรวจตัวเลขของคุณย้อนกลับได้ภายในไม่กี่นาที การรายงาน N และวิธีอ่านตารางให้ชัดเจนจึงเป็นการป้องกันคำถามที่ดีที่สุด
Krejcie and Morgan เทียบกับ Yamane และข้อจำกัดที่ต้องรู้
นักวิจัยไทยมักลังเลระหว่างตารางนี้กับสูตร Taro Yamane ซึ่งมาจากหนังสือ Statistics: An Introductory Analysis (Yamane, 1967) โดยสรุปสั้น ๆ คือ ทั้งสองวิธีตั้งอยู่บนแนวคิดการประมาณค่าสัดส่วนเหมือนกัน แต่ Yamane ใช้สูตร n = N ÷ (1 + Ne²) ซึ่งให้ค่าสูงกว่าเล็กน้อย เช่น ที่ N = 1,000 Yamane ได้ 286 คน ส่วน Krejcie & Morgan ได้ 278 คน และเมื่อประชากรใหญ่มาก Yamane เข้าใกล้ 400 คน ขณะที่ Krejcie & Morgan เข้าใกล้ 384 คน (ภาพที่ 2) รายละเอียดการคำนวณแบบ Yamane และการเลือกระหว่างวิธีต่าง ๆ เป็นหัวข้อของบทความแยกต่างหาก
ข้อจำกัดที่สำคัญกว่าการเลือกสูตร คือ “ตารางนี้ตอบคำถามอะไรได้บ้าง”
- ใช้สำหรับการประมาณค่าเชิงพรรณนาเท่านั้น ไม่ได้ออกแบบมาสำหรับการทดสอบสมมติฐาน เช่น เปรียบเทียบสองกลุ่ม ANOVA หรือการถดถอย งานลักษณะนั้นควรใช้การวิเคราะห์อำนาจการทดสอบ (power analysis) ที่ต้องระบุขนาดอิทธิพล (effect size) ตามที่ Charan และ Biswas (2013) อธิบายว่าแต่ละรูปแบบการวิจัยต้องใช้วิธีคำนวณต่างกัน
- สมมติการสุ่มอย่างง่าย หากใช้การสุ่มแบบกลุ่ม (cluster sampling) ต้องคูณด้วย design effect และหากใช้การเลือกแบบสะดวก ตัวเลขจากตารางไม่ได้ทำให้ผลเป็นตัวแทนประชากร
- ต้องทราบ N ที่แน่นอน ถ้าไม่ทราบจำนวนประชากร ควรใช้สูตรสำหรับประชากรไม่จำกัด หรือเลือกวิธีอื่นที่เหมาะสม
- การวิเคราะห์กลุ่มย่อย ถ้าวางแผนเปรียบเทียบผลรายคณะหรือรายเพศ แต่ละกลุ่มย่อยต้องมีขนาดเพียงพอ ซึ่งขนาดรวม 297 คนอาจไม่พอ
- อย่าใช้กฎสำเร็จรูปแบบไม่ดูบริบท Memon และคณะ (2020) ทบทวนกฎหัวแม่มือ (rules of thumb) ด้านขนาดตัวอย่างสำหรับงานสำรวจ พร้อมแนวทางวิเคราะห์อำนาจการทดสอบด้วย G*Power และเตือนว่าไม่ควรทำตามกฎเหล่านี้อย่างไม่ไตร่ตรอง เพราะแต่ละกฎใช้ได้ภายใต้เงื่อนไขที่กำหนดไว้เท่านั้น — งานที่ใช้ SEM หรือ PLS จึงต้องพิจารณาเกณฑ์ของแบบจำลองนั้นเพิ่มเติม
บริบทไทย: การใช้ตารางในวิทยานิพนธ์และการรายงานในบทที่ 3
ในวิทยานิพนธ์ไทย การกำหนดขนาดกลุ่มตัวอย่างมักอยู่ในบทที่ 3 หัวข้อ “ประชากรและกลุ่มตัวอย่าง” และเป็นจุดที่กรรมการสอบโครงร่างถามบ่อย จุดที่ควรเตรียมให้พร้อมมีดังนี้
แหล่งที่มาของ N ต้องตรวจสอบได้ ตัวเลขประชากรควรมาจากแหล่งทางการ เช่น งานทะเบียนของสถาบัน หน่วยงานต้นสังกัด หรือระบบเผยแพร่สารสนเทศอุดมศึกษาของสำนักงานปลัดกระทรวงการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม (สป.อว.) ซึ่งเผยแพร่สถิตินักศึกษา บุคลากร และผู้สำเร็จการศึกษาจากข้อมูลรายบุคคลของสถาบันอุดมศึกษา ควรระบุปีการศึกษาและวันที่ดึงข้อมูลกำกับไว้ด้วย
คณะกรรมการจริยธรรมการวิจัยในมนุษย์ มักให้ระบุจำนวนอาสาสมัครและเหตุผลของจำนวนนั้นในแบบเสนอโครงการ การอ้างตารางโดยไม่บอกพารามิเตอร์ (ความเชื่อมั่น ความคลาดเคลื่อน สัดส่วน) อาจทำให้ถูกขอแก้ไข
การตีพิมพ์ในวารสาร ทั้งวารสารในฐาน TCI และวารสารนานาชาติ แนวทาง STROBE สำหรับการศึกษาเชิงสังเกต ข้อ 10 กำหนดให้ “อธิบายว่าได้ขนาดการศึกษามาอย่างไร” (von Elm et al., 2007; STROBE Initiative) การเขียนเพียงว่า “ใช้ตาราง Krejcie & Morgan” จึงไม่พอ ควรเขียนให้ครบ เช่น
“ประชากร ได้แก่ นักศึกษาชั้นปีที่ 4 จำนวน 1,250 คน (ข้อมูลจากงานทะเบียน ปีการศึกษา 2568) กำหนดขนาดกลุ่มตัวอย่างด้วยตารางของ Krejcie และ Morgan (1970) ที่ระดับความเชื่อมั่น 95% ความคลาดเคลื่อน ±5% และสัดส่วน 0.5 ได้ 297 คน สุ่มแบบแบ่งชั้นตามสัดส่วนคณะ และแจกแบบสอบถาม 458 ฉบับเพื่อเผื่ออัตราตอบกลับ 65%”
ประโยคเดียวนี้ตอบคำถามที่กรรมการมักถามได้เกือบทั้งหมด ทั้งที่มาของ N พารามิเตอร์ วิธีสุ่ม และการเผื่ออัตราตอบกลับ
สรุป
ก่อนส่งบทที่ 3 หรือต้นฉบับบทความ ให้ตรวจรายการต่อไปนี้
- วัตถุประสงค์เป็นการประมาณค่าเชิงพรรณนา ไม่ใช่การทดสอบสมมติฐานหรือแบบจำลองที่ต้องใช้ power analysis
- ระบุ N พร้อมแหล่งที่มาและปีของข้อมูล
- อ้างอิงต้นฉบับ Krejcie & Morgan (1970) ด้วย DOI ที่ถูกต้อง
- รายงานพารามิเตอร์ครบ: ความเชื่อมั่น 95%, d = 0.05, P = 0.5
- ถ้า N อยู่ระหว่างสองแถว เลือกแถวที่สูงกว่า หรือคำนวณจากสูตรและปัดขึ้น
- ใช้การสุ่มแบบใช้ความน่าจะเป็น และแบ่งตามสัดส่วนชั้นอย่างถูกต้อง
- เผื่ออัตราการไม่ตอบกลับ และรายงานอัตราตอบกลับจริงในบทที่ 4
- หากมีการวิเคราะห์กลุ่มย่อย ตรวจว่าแต่ละกลุ่มมีขนาดเพียงพอ
ตาราง Krejcie and Morgan เป็นเครื่องมือที่ดีเมื่อใช้ตรงกับสมมติฐานของมัน แต่จะกลายเป็นจุดอ่อนทันทีเมื่อถูกใช้กับงานที่ต้องการการคำนวณแบบอื่น หากต้องการให้ผู้เชี่ยวชาญที่มีวุฒิปริญญาเอกในสาขาที่เกี่ยวข้องช่วยตรวจเหตุผลของขนาดตัวอย่าง ความสอดคล้องระหว่างวัตถุประสงค์กับสถิติที่ใช้ และการรายงานผล ดูรายละเอียดบริการวิเคราะห์สถิติของ Editverse — เราช่วยตรวจและยกระดับงานของคุณ ไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
ตาราง Krejcie and Morgan คำนวณจากอะไร
คำนวณจากสูตรไคสแควร์ที่องศาอิสระ 1 ระดับความเชื่อมั่น 95% (χ² = 3.841) ความคลาดเคลื่อน d = 0.05 และสัดส่วน P = 0.5 ตามบทความต้นฉบับปี 1970
ถ้าขนาดประชากรอยู่ระหว่างสองแถวของตาราง ควรทำอย่างไร
เลือกแถวที่ N สูงกว่า หรือคำนวณจากสูตรโดยตรงแล้วปัดเศษขึ้นเสมอ และรายงานพารามิเตอร์ที่ใช้ให้ครบ
ใช้ตาราง Krejcie and Morgan กับงานวิจัยเชิงเปรียบเทียบได้หรือไม่
ไม่เหมาะ ตารางนี้ออกแบบมาสำหรับการประมาณค่าเชิงพรรณนา หากวัตถุประสงค์คือการทดสอบสมมติฐานหรือแบบจำลอง ควรใช้ power analysis
เอกสารอ้างอิง
- Krejcie, R. V., & Morgan, D. W. (1970). Determining sample size for research activities. Educational and Psychological Measurement, 30(3), 607–610. doi:10.1177/001316447003000308
- Yamane, T. (1967). Statistics: An introductory analysis (2nd ed.). Harper & Row.
- Kamali, M., Ashrafi-Rizi, H., & Afshar, M. (2021). Image retrieval behavior of medical students. Journal of Education and Health Promotion, 10, 215. doi:10.4103/jehp.jehp_1042_20 PMID: 34395652
- Rezaei, B., Falahati, J., & Beheshtizadeh, R. (2020). Stress, stressors and related factors in clinical learning of midwifery students in Iran: A cross sectional study. BMC Medical Education, 20(1), 78. doi:10.1186/s12909-020-1970-7 PMID: 32183791
- Charan, J., & Biswas, T. (2013). How to calculate sample size for different study designs in medical research? Indian Journal of Psychological Medicine, 35(2), 121–126. doi:10.4103/0253-7176.116232 PMID: 24049221
- Memon, M. A., Ting, H., Cheah, J.-H., Thurasamy, R., Chuah, F., & Cham, T. H. (2020). Sample size for survey research: Review and recommendations. Journal of Applied Structural Equation Modeling, 4(2), i–xx. doi:10.47263/JASEM.4(2)01
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453–1457. doi:10.1016/S0140-6736(07)61602-X PMID: 18064739
- STROBE Initiative. (n.d.). STROBE checklists (cross-sectional studies, item 10: Study size). https://www.strobe-statement.org/checklists/
- สำนักงานปลัดกระทรวงการอุดมศึกษา วิทยาศาสตร์ วิจัยและนวัตกรรม. (ข้อมูลปีการศึกษา 2567). ระบบเผยแพร่สารสนเทศอุดมศึกษา: ข้อมูลนักศึกษา. https://info.mhesi.go.th/homestat_std.php
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ