odds ratio กับ relative risk และ hazard ratio ต่างกันอย่างไร
odds ratio (OR), relative risk (RR) และ hazard ratio (HR) เป็นอัตราส่วนสามแบบที่ตอบคำถามต่างกัน คือ OR เปรียบเทียบ odds, RR เปรียบเทียบความเสี่ยง และ HR เปรียบเทียบอัตราการเกิดเหตุการณ์ตามเวลา โดย OR จะเกินกว่า RR เมื่อเหตุการณ์พบบ่อย
odds ratio, RR และ HR: นิยามและเลือกใช้ตามรูปแบบการศึกษา
RR คืออัตราส่วนของความเสี่ยง (สัดส่วนที่เกิดเหตุการณ์) ระหว่างสองกลุ่ม OR คืออัตราส่วนของ odds ซึ่ง odds = p/(1−p) และ HR คืออัตราส่วนของ hazard (อัตราการเกิดเหตุการณ์ ณ ขณะใดขณะหนึ่ง) ระหว่างสองกลุ่ม Hernán (2010) ระบุว่า สำหรับตัวแปรที่ไม่เปลี่ยนตามเวลา HR คือ hazard ของกลุ่มสัมผัสหารด้วย hazard ของกลุ่มไม่สัมผัส ตีความคร่าว ๆ ได้เป็นอัตราส่วนอัตราอุบัติการณ์ และมักประมาณด้วยโมเดล Cox proportional hazards
| ตัวชี้วัด | คำถามที่ตอบ | ใช้เมื่อ | ประมาณค่าด้วย | ค่าไม่มีผล |
|---|---|---|---|---|
| RR | ความเสี่ยงในกลุ่มหนึ่งเป็นกี่เท่าของอีกกลุ่ม | cohort และ RCT ที่ผลลัพธ์เป็นเกิด/ไม่เกิด | คำนวณตรงจากตาราง 2×2 | 1 |
| OR | odds ของเหตุการณ์ในกลุ่มหนึ่งเป็นกี่เท่าของอีกกลุ่ม | case-control (คำนวณ RR ตรงไม่ได้) และการปรับตัวแปรกวนด้วย logistic regression | ตาราง 2×2 หรือ logistic regression | 1 |
| HR | อัตราการเกิดเหตุการณ์ ณ เวลาใดเวลาหนึ่งเป็นกี่เท่า | ข้อมูลเวลาถึงเหตุการณ์ (survival) ที่มีการตัดข้อมูล (censoring) | Cox proportional hazards | 1 |
Viera (2008) สรุปไว้ว่า ใน cohort study ค่า RR คำนวณได้โดยตรง ส่วนใน case-control study และใน cohort ที่เหตุการณ์เกิดน้อยกว่า 10% ของกลุ่มไม่สัมผัส OR ให้ค่าประมาณ RR ที่สมเหตุสมผล แต่เมื่อเหตุการณ์พบบ่อย (ตั้งแต่ 10% ขึ้นไปในกลุ่มไม่สัมผัส) OR จะ “ขยาย” RR เกินจริง Altman, Deeks และ Sackett (1998) จึงเสนอในชื่อเรื่องของจดหมายถึงบรรณาธิการ BMJ ว่าควรเลี่ยง OR เมื่อเหตุการณ์พบบ่อย และ Cochrane Handbook ข้อ 6.4.1 ระบุว่า ผลต่างระหว่าง odds กับความเสี่ยงมากเมื่อเหตุการณ์พบบ่อย ซึ่งเป็นกรณีที่พบทั่วไปในการทดลองทางคลินิก
คำนวณจากตาราง 2×2 ทีละขั้น: ตัวอย่างจริงจากข้อมูล Titanic
ลำดับการคำนวณคือ (1) หาความเสี่ยงของแต่ละกลุ่ม (2) หา RR จากอัตราส่วนความเสี่ยง (3) หา OR จากผลคูณไขว้ (4) คำนวณช่วงเชื่อมั่นบนสเกล log แล้ว exp กลับ ตัวอย่างใช้ข้อมูลเดียวที่ทุกคนตรวจซ้ำได้คือชุดข้อมูล Titanic ที่มากับ R ซึ่งเอกสารของ R ระบุที่มาจาก Dawson (1995) และรายงานของ British Board of Trade ตารางรวมผู้โดยสารและลูกเรือ 2,201 คน ผลลัพธ์คือรอดชีวิตหรือไม่ และเปรียบเทียบเพศหญิงกับชาย ข้อมูลนี้ใช้สาธิตการคำนวณ ไม่ได้ใช้อนุมานเชิงสาเหตุ
| เพศ | รอดชีวิต | ไม่รอด | รวม | ความเสี่ยง (สัดส่วนรอด) | odds |
|---|---|---|---|---|---|
| หญิง | 344 | 126 | 470 | 0.732 | 2.730 |
| ชาย | 367 | 1,364 | 1,731 | 0.212 | 0.269 |
# ตาราง 2x2 จริง: datasets::Titanic รวมทุกชั้นโดยสารและอายุ (n = 2,201)
tt  <- margin.table(Titanic, c(2, 4))                       # เพศ x ผลการรอดชีวิต
n11 <- tt["Female", "Yes"]; n10 <- tt["Female", "No"]       # 344, 126
n01 <- tt["Male",   "Yes"]; n00 <- tt["Male",   "No"]       # 367, 1364

p1 <- n11 / (n11 + n10)                                     # ความเสี่ยง (สัดส่วนรอด) หญิง = 0.7319
p0 <- n01 / (n01 + n00)                                     # ความเสี่ยง (สัดส่วนรอด) ชาย  = 0.2120
RR <- p1 / p0                                               # 3.452
OR <- (n11 * n00) / (n10 * n01)                             # 10.147  (= odds หญิง 2.730 / odds ชาย 0.269)
RD <- p1 - p0                                               # 0.520  (52.0 จุดเปอร์เซ็นต์)

exp(log(RR) + c(-1, 1) * 1.96 * sqrt(1/n11 - 1/(n11+n10) + 1/n01 - 1/(n01+n00)))   # 95% CI ของ RR: 3.105  3.838
exp(log(OR) + c(-1, 1) * 1.96 * sqrt(1/n11 + 1/n10 + 1/n01 + 1/n00))               # 95% CI ของ OR: 8.027  12.827
OR / (1 - p0 + p0 * OR)                                     # แปลง OR กลับเป็น RR โดยใช้ p0 = 3.452
RR = 0.7319 / 0.2120 = 3.45 (95% CI 3.10–3.84) แปลว่า สัดส่วนรอดชีวิตของหญิงสูงเป็น 3.45 เท่าของชาย ส่วน OR = 2.730 / 0.269 = 10.15 (95% CI 8.03–12.83) แปลว่า odds ของการรอดชีวิตของหญิงเป็น 10.15 เท่าของชาย ทั้งสองตัวชี้ไปทางเดียวกัน แต่ขนาดต่างกันเกือบสามเท่า เพราะผลลัพธ์พบบ่อย (ความเสี่ยงฐานของชายคือ 21.2%) ผลต่างสัมบูรณ์ (risk difference) คือ 52.0 จุดเปอร์เซ็นต์ ซึ่งสื่อความหมายได้ตรงที่สุดและควรรายงานควบคู่กัน
ข้อผิดพลาดที่พบบ่อยที่สุดคืออ่าน OR 10.15 ว่า “หญิงมีโอกาสรอดมากกว่าชาย 10 เท่า” ซึ่งผิด คำว่าโอกาสหรือความเสี่ยงต้องใช้กับ RR (3.45 เท่า) ส่วน OR ต้องอ่านว่าเป็นอัตราส่วนของ odds
ทำไม OR เกิน RR เมื่อเหตุการณ์พบบ่อย และข้อสมมติโรคหายาก
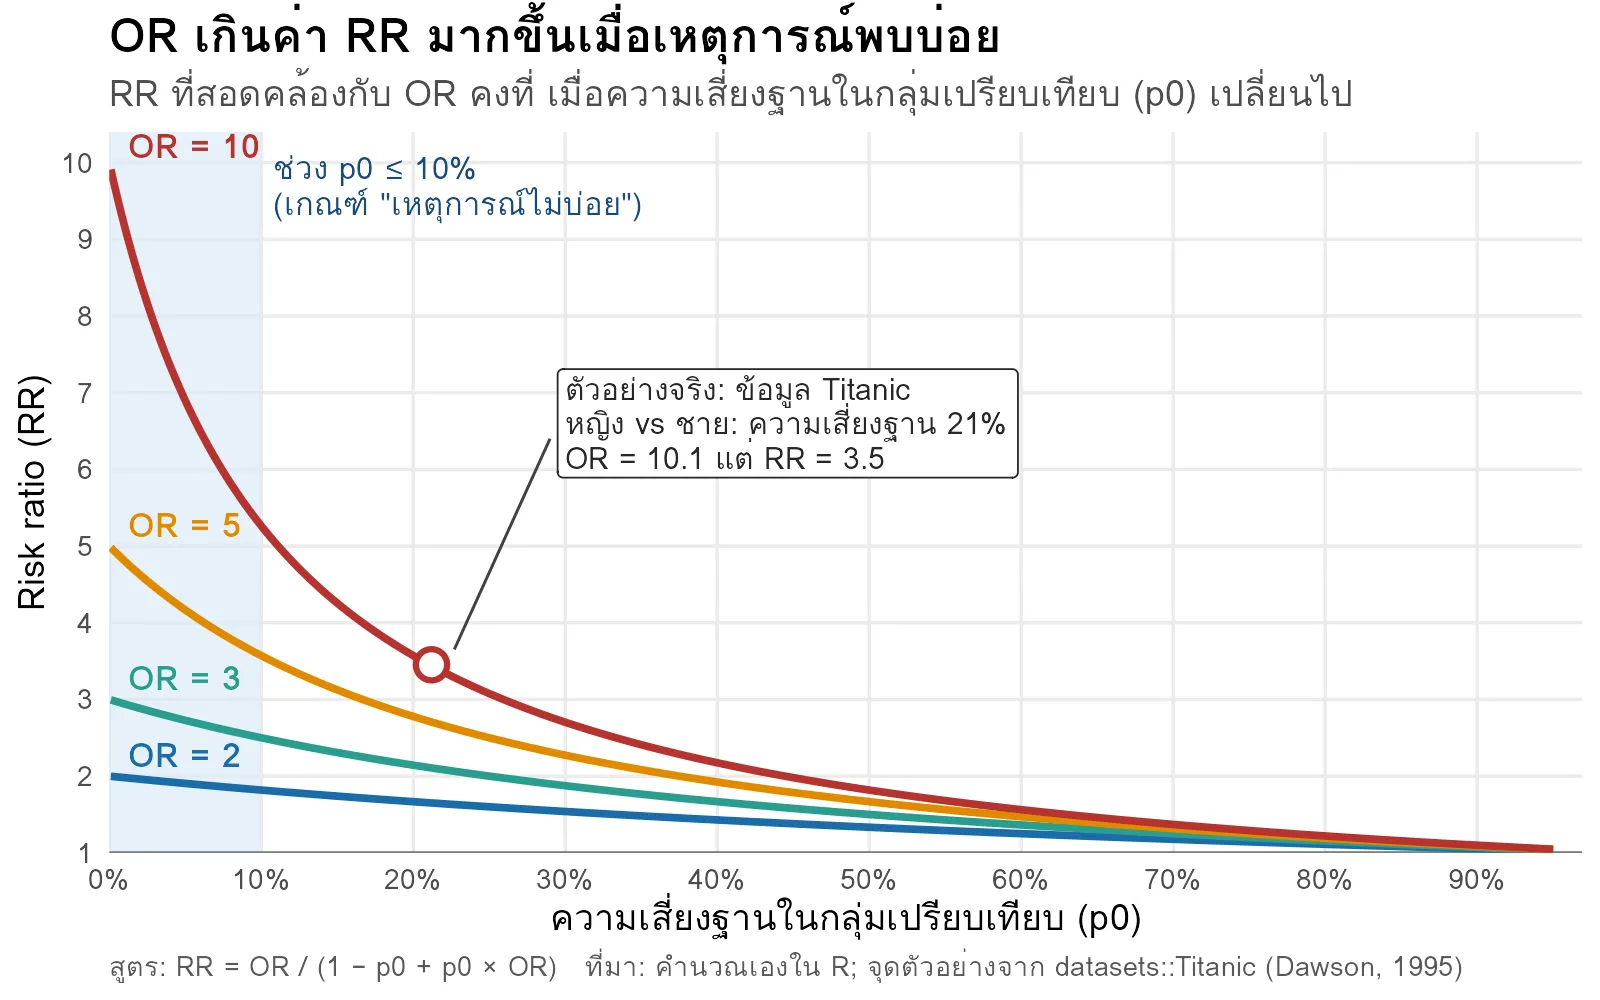
จากนิยาม OR = [RR × p0 / (1 − RR × p0)] ÷ [p0 / (1 − p0)] เมื่อแก้สมการหา RR จะได้ RR = OR / (1 − p0 + p0 × OR) เมื่อ p0 คือความเสี่ยงในกลุ่มเปรียบเทียบ ถ้า p0 ใกล้ 0 ตัวส่วนใกล้ 1 และ RR ≈ OR นี่คือที่มาของ “ข้อสมมติโรคหายาก” (rare disease assumption) ถ้า p0 ใหญ่ ตัวส่วนมากกว่า 1 ทำให้ RR เล็กกว่า OR Zhang และ Yu (1998) ใช้แนวคิดนี้แก้ค่า OR ที่ได้จาก logistic regression ให้ใกล้ RR และระบุว่าเมื่อเหตุการณ์พบบ่อยในประชากรศึกษา (มากกว่า 10%) OR จะเกิน RR มากขึ้นเรื่อย ๆ เมื่อ OR มากกว่า 1 และต่ำกว่า RR เมื่อ OR น้อยกว่า 1
ตัวอย่างสมมติ: RR เท่ากัน แต่ OR ต่างกัน
ตัวเลขต่อไปนี้เป็นข้อมูลสมมติเพื่อแสดงหลักการ (คำนวณใน R) ทั้งสองกรณีมี RR = 2.00 พอดี
| กรณี (สมมติ) | ความเสี่ยงกลุ่มสัมผัส | ความเสี่ยงกลุ่มไม่สัมผัส (p0) | RR | OR | ผลต่างสัมบูรณ์ |
|---|---|---|---|---|---|
| เหตุการณ์ไม่บ่อย | 30/1,000 = 3.0% | 15/1,000 = 1.5% | 2.00 | 2.03 | 1.5 จุด |
| เหตุการณ์บ่อย | 60/100 = 60% | 30/100 = 30% | 2.00 | 3.50 | 30 จุด |
กรณีเหตุการณ์ไม่บ่อย OR = 2.03 ใกล้ RR มาก แต่กรณีเหตุการณ์บ่อย OR = 3.50 ซึ่งถ้าตีความเป็น RR จะเกินจริง 75% ตรวจย้อนกลับด้วยสูตรได้ว่า 3.50 / (1 − 0.30 + 0.30 × 3.50) = 3.50 / 1.75 = 2.00 ภาพที่ 1 แสดงความสัมพันธ์ทั้งหมดเป็นกราฟ เส้นแต่ละเส้นคือ OR คงที่ และจะเห็นว่า RR ลดลงเข้าหา 1 เมื่อ p0 สูงขึ้น เช่นที่ OR = 10.1 และ p0 = 21.2% จะได้ RR = 3.45 ตรงกับตัวอย่าง Titanic
กฎปฏิบัติคือ 1) ดู p0 หรือสัดส่วนเหตุการณ์ในกลุ่มเปรียบเทียบก่อนตีความ OR 2) ถ้า p0 น้อยกว่า 10% และ OR ไม่สูงมาก ให้อ่านใกล้เคียง RR ได้ 3) ถ้า p0 ตั้งแต่ 10% ขึ้นไป ให้แปลง OR เป็น RR ด้วยสูตรข้างต้น หรือรายงานความเสี่ยงสัมบูรณ์ของแต่ละกลุ่ม Cochrane Handbook ข้อ 6.4.1.2 แนะนำให้แปลง OR เป็น RR ก่อนตีความเพราะ OR ตีความยากกว่า และข้อ 6.4.1.3 เตือนว่าการอ่าน OR เป็น RR จะประเมินผลเกินจริง โดยเฉพาะเมื่อเหตุการณ์พบบ่อย
ตีความช่วงเชื่อมั่น และสิ่งที่ต้องรายงานคู่กัน
ช่วงเชื่อมั่น 95% ของ OR, RR และ HR คำนวณบนสเกล log แล้ว exp กลับ จึงไม่สมมาตรรอบค่าประมาณ ตีความด้วยกฎสามข้อ (1) ถ้าช่วงไม่รวม 1 ผลต่างจาก “ไม่มีผล” ที่ระดับ 0.05 (2) ถ้าช่วงรวม 1 ไม่ได้แปลว่าไม่มีผล แต่ข้อมูลไม่พอตัดสิน และ (3) ความกว้างของช่วงบอกความแม่นยำ ซึ่งสำคัญกว่า p-value ดูเพิ่มที่ p-value และ Effect Size
แนวทาง STROBE ข้อ 16 สำหรับงานสังเกต ระบุให้รายงานทั้งค่าประมาณที่ยังไม่ปรับและที่ปรับตัวแปรกวนแล้วพร้อมความแม่นยำ (เช่น CI 95%) โดยบอกว่าปรับตัวแปรใดเพราะเหตุใด และถ้าเกี่ยวข้อง ให้พิจารณาแปลงความเสี่ยงสัมพัทธ์เป็นความเสี่ยงสัมบูรณ์ในช่วงเวลาที่มีความหมาย (von Elm et al., 2007; รายการตรวจที่เผยแพร่ที่ strobe-statement.org) สำหรับรายละเอียดการใช้ STROBE ดู STROBE Checklist สำหรับงาน Retrospective และ Observational และการเลือกแนวทางรายงานให้ตรงงานได้ที่ เลือก reporting guideline
สรุปเป็นตารางตัดสินใจ
| สถานการณ์ | รายงานเป็นหลัก | เสริมด้วย |
|---|---|---|
| case-control | OR พร้อม CI (ปรับตัวแปรกวนด้วย logistic regression ถ้าจำเป็น) | ระบุว่าโรคพบน้อยพอจะประมาณเป็น RR หรือไม่ |
| cohort หรือ RCT ผลลัพธ์เกิด/ไม่เกิด ระยะติดตามคงที่ | RR พร้อม CI | ความเสี่ยงของแต่ละกลุ่มและผลต่างสัมบูรณ์ |
| ใช้ logistic regression และเหตุการณ์พบบ่อย (≥ 10%) | adjusted OR พร้อม CI | แปลงเป็น RR ด้วยสูตร หรือรายงานความเสี่ยงที่ทำนายได้ของแต่ละกลุ่ม |
| เวลาถึงเหตุการณ์ มีการตัดข้อมูล | HR พร้อม CI และการตรวจสมมติฐาน | กราฟ Kaplan-Meier และความเสี่ยงสะสมที่เวลากำหนด |
งานที่ใช้โมเดลทำนายและรายงาน AUC แยกจากเรื่องนี้ ดูแนวทางใน sensitivity, specificity, ROC และ AUC ส่วนความต่างระหว่าง linear กับ logistic regression ดูที่ Linear กับ Logistic Regression ต่างกันอย่างไร และการทดสอบความสัมพันธ์ของตาราง 2×2 ด้วยไคสแควร์ดูที่ Chi square test ใช้เมื่อไร
hazard ratio: เวลา สมมติฐาน proportional hazards และข้อควรระวัง
HR ใช้เมื่อผลลัพธ์คือเวลาถึงเหตุการณ์ และมีผู้เข้าร่วมบางคนที่ถูกตัดข้อมูลก่อนเกิดเหตุการณ์ ตัวอย่างจริงด้านล่างใช้ข้อมูล lung ในแพ็กเกจ survival ของ R (ผู้ป่วยมะเร็งปอดระยะลุกลามของ North Central Cancer Treatment Group; เอกสารแพ็กเกจอ้าง Loprinzi et al., 1994) เปรียบเทียบเพศหญิงกับชาย เพื่อสาธิตวิธีคำนวณเท่านั้น
library(survival)   # เวอร์ชัน 3.8-6 ; ข้อมูล lung (NCCTG) ที่มา: Loprinzi et al. (1994)
d <- lung
d$sex <- factor(d$sex, levels = 1:2, labels = c("male", "female"))
fit <- coxph(Surv(time, status == 2) ~ sex, data = d)      # status: 1 = censored, 2 = dead
summary(fit)   # n = 228, events = 165 ; HR (female vs male) = 0.588 ; 95% CI 0.424-0.816 ; p = 0.0015
cox.zph(fit)   # ทดสอบสมมติฐาน proportional hazards: chisq = 2.86, df = 1, p = 0.091
summary(survfit(Surv(time, status == 2) ~ sex, data = d))$table[, c("records", "events", "median")]
#               records events median
# sex=male          138    112    270   (วัน)
# sex=female         90     53    426   (วัน)
ผลคือ HR ของเพศหญิงเทียบกับชาย = 0.588 (95% CI 0.424–0.816, p = 0.0015) จากผู้ป่วย 228 คน เสียชีวิต 165 คน แปลว่า ณ เวลาใดก็ตาม อัตราการเสียชีวิตของหญิงต่ำกว่าชายประมาณ 41% (1 − 0.588) ภายใต้สมมติฐานว่าอัตราส่วนนี้คงที่ตลอดช่วงเวลา มัธยฐานการรอดชีวิตจากกราฟ Kaplan-Meier คือ 426 วันในหญิงและ 270 วันในชาย การทดสอบ proportional hazards ด้วย cox.zph (ตามวิธีของ Grambsch และ Therneau, 1994) ได้ p = 0.091 ซึ่งไม่ปฏิเสธสมมติฐาน แต่ p ที่มากกว่า 0.05 ไม่ได้พิสูจน์ว่าสมมติฐานเป็นจริง ควรดูกราฟ Schoenfeld residuals ประกอบ
ข้อควรระวังของ HR ตาม Hernán (2010)
Hernán (2010) ชี้ว่า การให้ HR ความหมายเชิงสาเหตุเป็นเรื่องเสี่ยง ด้วยสองเหตุผล คือ HR อาจเปลี่ยนตามเวลา และ HR มีอคติจากการคัดเลือกในตัว ตัวอย่างในบทความมาจากการทดลอง Women’s Health Initiative ที่ติดตามผู้หญิงกว่า 16,000 คนเฉลี่ย 5.2 ปี HR รวมของโรคหลอดเลือดหัวใจในกลุ่มได้ฮอร์โมนรวมคือ 1.24 แต่ HR รายปีคือ 1.81, 1.34, 1.27, 1.25, 1.45 และ 0.70 สำหรับปีที่ 1, 2, 3, 4, 5 และ 6 ขึ้นไป ตามลำดับ ค่า HR เฉลี่ยจึงขึ้นกับความยาวของการติดตาม และ HR ปีหลังที่ต่ำกว่า 1 อาจเกิดจากการที่ผู้ไวต่อโรคถูกคัดออกจากกลุ่มได้ยาไปก่อน (depletion of susceptibles) ข้อเสนอของ Hernán คือรายงานกราฟการรอดชีวิตหรือความเสี่ยงสะสมที่ปรับแล้ว แทนหรือควบคู่กับ HR
กฎปฏิบัติสำหรับ HR คือ รายงานจำนวนเหตุการณ์ ตรวจสมมติฐาน proportional hazards ทั้งด้วยการทดสอบและกราฟ แสดงกราฟ Kaplan-Meier และระบุระยะติดตาม หากสมมติฐานไม่เป็นจริง ให้รายงาน HR แยกช่วงเวลา หรือใช้ความเสี่ยงสะสมที่เวลากำหนด
บริบทไทย: วิทยานิพนธ์และบทความที่ใช้ logistic regression
ถ้างานวิจัยของคุณรายงาน adjusted OR จาก logistic regression ให้ตรวจสามข้อก่อนส่งกรรมการหรือวารสาร ข้อแรก ความเสี่ยงฐานของผลลัพธ์ในกลุ่มอ้างอิงคือเท่าใด ถ้าตั้งแต่ 10% ขึ้นไป ให้เติมการแปลงเป็น RR หรือรายงานความเสี่ยงสัมบูรณ์ ข้อสอง เขียนคำอ่านให้ถูก ใช้คำว่า “odds” ไม่ใช่ “โอกาส” หรือ “ความเสี่ยง” ข้อสาม ใช้แนวทางรายงานที่ตรงรูปแบบ เช่น STROBE สำหรับงานสังเกต ซึ่งข้อ 16 ครอบคลุมการรายงานค่าที่ปรับและไม่ปรับ ผู้ที่ต้องการตรวจผลวิเคราะห์ทางสถิติก่อนส่ง ดู ตรวจสถิติก่อนส่งวารสาร: 12 จุดที่ Reviewer ตรวจเจอบ่อย ข้อกำหนดการรายงานเฉพาะของแต่ละสถาบันและวารสารต่างกัน ควรตรวจจากประกาศของบัณฑิตวิทยาลัยหรือคำแนะนำผู้เขียนของวารสารที่จะส่ง
สรุป
รายการตรวจก่อนรายงาน OR, RR หรือ HR
- เลือกตัวชี้วัดตามรูปแบบการศึกษา: case-control ใช้ OR, cohort/RCT ใช้ RR, เวลาถึงเหตุการณ์ใช้ HR
- ระบุความเสี่ยงฐานหรือสัดส่วนเหตุการณ์ในกลุ่มเปรียบเทียบเสมอ
- ถ้า p0 ตั้งแต่ 10% ขึ้นไป ห้ามอ่าน OR เป็น RR ให้แปลงด้วย RR = OR / (1 − p0 + p0 × OR) หรือรายงานความเสี่ยงสัมบูรณ์
- รายงาน CI 95% ทุกค่า และเขียนคำอ่านให้ตรงชนิด (odds, ความเสี่ยง, อัตรา)
- รายงานผลต่างสัมบูรณ์ควบคู่กับอัตราส่วน
- สำหรับ HR: รายงานจำนวนเหตุการณ์ ตรวจ proportional hazards และแสดงกราฟ Kaplan-Meier
หากต้องการให้ผู้เชี่ยวชาญตรวจแผนวิเคราะห์และการรายงาน OR, RR และ HR ดูบริการ วิเคราะห์สถิติ ของเรา หากต้องการสอบถามส่วนลดสำหรับนักศึกษาหรือนักวิจัยที่ไม่มีทุน หรือต้องการความชัดเจนเพิ่มเติม ติดต่อผ่าน แบบฟอร์มติดต่อ หรืออีเมล [email protected] บริการของเราดำเนินการตามแนวทาง ICMJE, COPE และ GPP3
เอกสารอ้างอิง
- Altman, D. G., Deeks, J. J., & Sackett, D. L. (1998). Odds ratios should be avoided when events are common. BMJ, 317(7168), 1318. doi:10.1136/bmj.317.7168.1318 PMID: 9804732
- Dawson, R. J. M. (1995). The “unusual episode” data revisited. Journal of Statistics Education, 3(3). doi:10.1080/10691898.1995.11910499 (แหล่งที่มาของชุดข้อมูล Titanic ในแพ็กเกจ datasets ของ R ตามเอกสารของ R)
- Grambsch, P. M., & Therneau, T. M. (1994). Proportional hazards tests and diagnostics based on weighted residuals. Biometrika, 81(3), 515–526. doi:10.1093/biomet/81.3.515
- Hernán, M. A. (2010). The hazards of hazard ratios. Epidemiology, 21(1), 13–15. doi:10.1097/EDE.0b013e3181c1ea43 PMID: 20010207
- Higgins, J. P. T., Thomas, J., Chandler, J., Cumpston, M., Li, T., Page, M. J., et al. (Eds.). (2024). Cochrane Handbook for Systematic Reviews of Interventions (version 6.5), chapter 6: Choosing effect measures and computing estimates of effect (Higgins, J. P. T., Li, T., & Deeks, J. J., Eds.; last updated August 2023). Cochrane. https://www.cochrane.org/authors/handbooks-and-manuals/handbook/current/chapter-06
- Loprinzi, C. L., Laurie, J. A., Wieand, H. S., Krook, J. E., Novotny, P. J., Kugler, J. W., et al. (1994). Prospective evaluation of prognostic variables from patient-completed questionnaires. North Central Cancer Treatment Group. Journal of Clinical Oncology, 12(3), 601–607. doi:10.1200/JCO.1994.12.3.601 PMID: 8120560
- STROBE Statement. (n.d.). STROBE checklist for cohort, case-control and cross-sectional studies (combined), item 16. https://www.strobe-statement.org/checklists/
- Viera, A. J. (2008). Odds ratios and risk ratios: what’s the difference and why does it matter? Southern Medical Journal, 101(7), 730–734. doi:10.1097/SMJ.0b013e31817a7ee4 PMID: 18580722
- von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., & Vandenbroucke, J. P. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. BMJ, 335(7624), 806–808. doi:10.1136/bmj.39335.541782.AD PMID: 17947786
- Zhang, J., & Yu, K. F. (1998). What’s the relative risk? A method of correcting the odds ratio in cohort studies of common outcomes. JAMA, 280(19), 1690–1691. doi:10.1001/jama.280.19.1690 PMID: 9832001
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ