Heterogeneity I2 คืออะไร: อ่านค่า Q, tau² และ PI
heterogeneity I2 คือค่าสถิติที่บอกว่าความแปรผันของผลระหว่างการศึกษาใน meta-analysis เกิดจากความแตกต่างจริงของการศึกษามากน้อยเพียงใด เมื่อเทียบกับความคลาดเคลื่อนจากการสุ่ม แต่ต้องอ่านร่วมกับ Q, tau² และ prediction interval จึงจะสรุปผลได้ถูกต้อง
heterogeneity I2 คืออะไร และต่างจาก Q กับ tau² อย่างไร
Cochrane Handbook เรียกความแปรผันทุกชนิดระหว่างการศึกษาใน Systematic Review ว่า heterogeneity และแยกเป็นสามแบบ คือ clinical diversity (ความต่างของผู้เข้าร่วม การรักษา และผลลัพธ์) methodological diversity (ความต่างของการออกแบบ เครื่องมือวัด และความเสี่ยงของอคติ) และ statistical heterogeneity (ความต่างของขนาดผลที่การศึกษาแต่ละฉบับประเมินได้) (Deeks et al., 2024) บทความนี้เน้นแบบที่สามซึ่งวัดด้วยสถิติ และชี้ว่าแต่ละค่าตอบคำถามต่างกัน
Higgins และ Thompson (2002) เสนอค่า I² เป็นมาตรวัดผลกระทบของ heterogeneity ที่ไม่ขึ้นกับหน่วยของขนาดผล และ Higgins และคณะ (2003) อธิบายว่า I² คือเปอร์เซ็นต์ของความแปรผันทั้งหมดระหว่างการศึกษาที่เกิดจาก heterogeneity ไม่ใช่ความบังเอิญ โดยคำนวณจาก I² = 100% × (Q − df) / Q ซึ่ง Q คือสถิติ heterogeneity ของ Cochran และ df คือองศาอิสระ (จำนวนการศึกษา − 1) ค่าติดลบให้ปัดเป็นศูนย์ จึงมีค่าอยู่ระหว่าง 0% ถึง 100%
| สถิติ | ตอบคำถามอะไร | หน่วยหรือมาตรา | ข้อควรระวัง |
|---|---|---|---|
| Q (Cochran) | มีหลักฐานว่าผลต่างกันเกินความคลาดเคลื่อนจากการสุ่มหรือไม่ | ค่า p-value เทียบกับ χ² ที่ df = k − 1 | กำลังต่ำเมื่อมีการศึกษาเล็กหรือน้อย และไวเกินเมื่อมีการศึกษามาก ค่า p ไม่มีนัยสำคัญไม่ได้แปลว่าไม่มี heterogeneity |
| I² | สัดส่วนของความแปรผันทั้งหมดที่ไม่ได้มาจากความคลาดเคลื่อนจากการสุ่ม | เปอร์เซ็นต์ 0-100% | เป็นสัดส่วน ไม่ใช่ขนาดของความต่าง และไม่ควรใช้เกณฑ์ตายตัว |
| τ² (tau-squared) | ความแปรปรวนของผลจริงระหว่างการศึกษา | หน่วยเดียวกับขนาดผลยกกำลังสอง เช่น log RR² | ตีความต้องรู้หน่วยของขนาดผล |
| τ (tau) | ส่วนเบี่ยงเบนมาตรฐานของผลจริงระหว่างการศึกษา | หน่วยเดียวกับขนาดผล | ใช้สร้าง prediction interval |
| Prediction interval | ช่วงที่คาดว่าผลจริงของการศึกษาใหม่ในบริบทคล้ายกันจะอยู่ | หน่วยเดียวกับขนาดผล | ใช้ได้ดีเมื่อมีการศึกษาพอสมควร |
Cochrane Handbook อธิบายว่า τ² คือความแปรปรวนระหว่างการศึกษา และรากที่สองของมัน (τ) คือค่าประมาณส่วนเบี่ยงเบนมาตรฐานของผลจริงระหว่างการศึกษา (Deeks et al., 2024) ส่วน Q-test มีกำลังต่ำเมื่อการศึกษามีขนาดเล็ก ซึ่งพบบ่อยใน meta-analysis และมีกำลังสูงเมื่อมีการศึกษามากจนตรวจพบ heterogeneity เล็กน้อยที่อาจไม่สำคัญทางคลินิก Handbook จึงเตือนว่าไม่ควรสรุปว่าไม่มี heterogeneity จากผลที่ไม่มีนัยสำคัญ และระบุว่าบางครั้งใช้ระดับ p = 0.10 แทน 0.05 เพื่อตัดสินนัยสำคัญของ Q-test (Deeks et al., 2024)
เกณฑ์การอ่านค่า I² ที่เห็นในตำรา
Higgins และคณะ (2003) เสนอแบบชั่วคราวให้เรียกค่า I² ที่ 25%, 50% และ 75% ว่าต่ำ ปานกลาง และสูง ตามลำดับ และเตือนว่าการแบ่งแบบนี้ไม่เหมาะกับทุกสถานการณ์ ส่วน Cochrane Handbook ให้แนวทางคร่าว ๆ ว่า 0-40% อาจไม่สำคัญ 30-60% อาจเป็นระดับปานกลาง 50-90% อาจเป็นระดับมาก และ 75-100% เป็นระดับมากที่สุด พร้อมระบุว่าเกณฑ์เหล่านี้อาจทำให้เข้าใจผิดได้ เพราะความสำคัญของ I² ขึ้นกับขนาดและทิศทางของผล และความหนักแน่นของหลักฐานว่ามี heterogeneity (Deeks et al., 2024) ดังนั้นอย่าเขียนในวิทยานิพนธ์ว่า “I² เกิน 50% จึงไม่ควรรวมผล” เพราะนั่นเป็นการใช้เกณฑ์เกินกว่าที่ผู้เสนอตั้งใจ
ตัวอย่างจริง: ข้อมูลวัคซีน BCG 13 การศึกษา วิเคราะห์ด้วย R
เพื่อให้เห็นตัวเลขจริง เราใช้ชุดข้อมูล dat.bcg ในแพ็กเกจ metafor ของ R ซึ่งมาจาก meta-analysis ของ Colditz และคณะ (1994) ที่ตีพิมพ์ใน JAMA เรื่องประสิทธิผลของวัคซีน BCG ในการป้องกันวัณโรค ข้อมูลประกอบด้วย 13 การศึกษา ผู้เข้าร่วมรวม 357,347 คน และผู้ป่วยวัณโรครวม 2,575 ราย (ผลรวมที่เราคำนวณจากตาราง 2×2 ของชุดข้อมูล) ขนาดผลคือ risk ratio (RR) โดยค่าต่ำกว่า 1 หมายถึงวัคซีนลดความเสี่ยง ข้อมูลนี้ใช้เพื่อสาธิตวิธีอ่านผล heterogeneity ไม่ใช่เพื่อสรุปประสิทธิผลวัคซีนสำหรับการใช้ทางคลินิก คำสั่งที่ใช้เป็นดังนี้
library(metafor)   # version 5.0-1
dat <- escalc(measure = "RR", ai = tpos, bi = tneg,
              ci = cpos, di = cneg, data = dat.bcg)
fit <- rma(yi, vi, data = dat, method = "REML", test = "knha")
summary(fit)                 # Q, I2, H2, tau2
confint(fit)                 # CI ของ tau2 และ I2
predict(fit, transf = exp)   # RR รวม + prediction interval
rma(yi, vi, mods = ~ ablat, data = dat, method = "REML") # meta-regression| ค่า | ผลจากชุดข้อมูล BCG | การอ่านผล |
|---|---|---|
| Q | 152.2 (df = 12, p < 0.0001) | มีหลักฐานชัดว่าผลต่างกันเกินความบังเอิญ |
| I² | 92.2% (95% CI 81.9-97.7%) | ความแปรผันส่วนใหญ่มาจากความต่างระหว่างการศึกษา |
| H² | 12.9 | ความแปรผันรวมเป็น 12.9 เท่าของความแปรผันจากการสุ่มอย่างเดียว |
| τ² | 0.313 (95% CI 0.120-1.112) | ความแปรปรวนบนสเกล log RR |
| τ | 0.560 | SD ของ log RR จริงระหว่างการศึกษา |
| RR รวม (REML + HKSJ) | 0.49 (95% CI 0.33-0.73) | ค่าเฉลี่ยของการกระจายของผลจริง |
| Prediction interval (95%) | 0.14-1.76 | ช่วงของ RR ที่คาดสำหรับการศึกษาใหม่ |
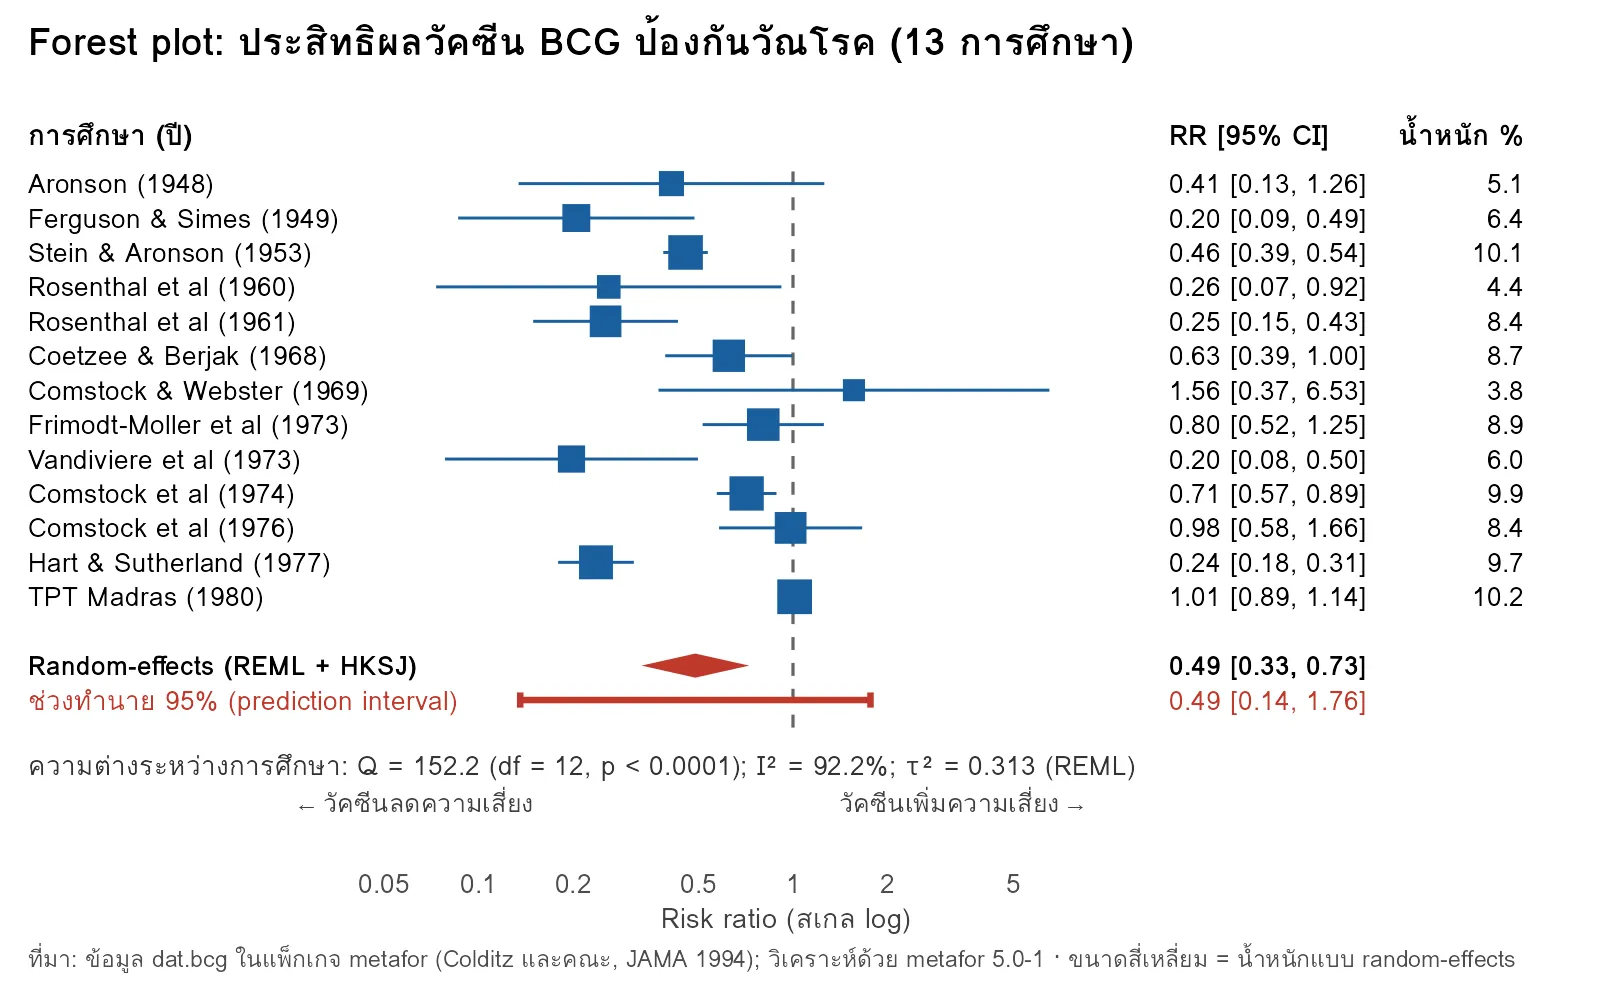
ลองคำนวณ I² ด้วยมือจากสูตรของ Higgins และคณะ (2003) เพื่อดูว่าตัวเลขมาจากไหน ได้ I² = 100% × (152.2 − 12) / 152.2 = 92.1% ใกล้เคียงกับ 92.2% ที่ได้จากโมเดล REML เพราะวิธีประมาณ τ² ต่างกันเล็กน้อย (วิธี DerSimonian-Laird ให้ I² 92.1% และ τ² 0.309) ส่วน τ = 0.560 บนสเกล log หมายความว่า ผลจริงของแต่ละการศึกษากระจายรอบ RR เฉลี่ยโดยมีส่วนเบี่ยงเบนมาตรฐานคูณ-หารประมาณ exp(0.560) = 1.75 เท่า นี่คือความหมายที่ I² เพียงอย่างเดียวบอกไม่ได้
สังเกตช่วงความเชื่อมั่นของ I² ที่กว้างถึง 81.9-97.7% แม้ I² จะสูง แต่การประมาณก็ยังไม่แม่นยำ เมื่อมีการศึกษาเพียง 13 ฉบับ จึงควรรายงานช่วงความเชื่อมั่นของ I² และ τ² ควบคู่กับค่าประมาณจุดเสมอ และการตัดการศึกษาทีละฉบับ (leave-one-out) ในชุดข้อมูลนี้ให้ I² อยู่ในช่วง 87.0-93.2% และ RR รวมอยู่ในช่วง 0.45-0.53 แสดงว่าข้อสรุปไม่ได้ขึ้นกับการศึกษาใดฉบับเดียว
Fixed-effect หรือ random-effects: เลือกอย่างไร
Cochrane Handbook ระบุว่าการเลือกระหว่างโมเดล fixed-effect กับ random-effects “ไม่ควรตัดสินจากผลการทดสอบ heterogeneity” และอธิบายว่าผลสรุปของ random-effects คือค่าเฉลี่ยของการกระจายของผลการแทรกแซง ไม่ได้บอกความกว้างของการกระจาย (Deeks et al., 2024) Borenstein และคณะ (2010) อธิบายว่าสองโมเดลตั้งอยู่บนสมมติฐานต่างกัน คือ fixed-effect สมมติว่าทุกการศึกษาประมาณผลจริงค่าเดียวกัน ส่วน random-effects สมมติว่าผลจริงต่างกันระหว่างการศึกษา สูตรที่คล้ายกันทำให้คนเข้าใจว่าใช้แทนกันได้ แต่ที่จริงตอบคำถามต่างกัน
ข้อมูล BCG ทำให้เห็นความต่างชัดเจน โมเดล fixed-effect ให้ RR 0.65 (95% CI 0.60-0.70) ขณะที่ random-effects ให้ RR 0.49 (95% CI 0.33-0.73 เมื่อใช้ HKSJ) สาเหตุคือน้ำหนัก ใน fixed-effect การศึกษา TPT Madras (1980) ซึ่งมีผู้เข้าร่วม 176,782 คน มีน้ำหนัก 41.4% การศึกษา Stein และ Aronson (1953) มี 23.8% และ Comstock และคณะ (1974) มี 13.2% รวมสามฉบับถือน้ำหนักถึง 78.4% ของทั้งหมด ในขณะที่ random-effects น้ำหนักของแต่ละการศึกษาอยู่ในช่วง 3.8-10.2% เท่านั้น เพราะ τ² ถูกเพิ่มเข้าในความแปรปรวนของทุกการศึกษา Handbook อธิบายว่า fixed-effect meta-analysis มองข้าม heterogeneity และการใช้ random-effects ไม่ใช่สิ่งทดแทนการสืบหาสาเหตุของ heterogeneity อย่างละเอียด (Deeks et al., 2024)
มีอีกสองการตัดสินใจที่ต้องระบุในส่วนวิธีการ ได้แก่ตัวประมาณ τ² และวิธีสร้างช่วงความเชื่อมั่น Handbook ระบุว่าการจำลองหลายงานแนะนำวิธีของ Paule และ Mandel การจำลองที่ใหม่กว่าแนะนำ REML ไม่มีวิธีใดดีที่สุดในทุกกรณี และวิธี DerSimonian-Laird แม้คำนวณง่ายแต่วิธีอื่นทำงานได้ดีกว่า (Deeks et al., 2024) ในข้อมูล BCG ค่า τ² ที่ได้ใกล้กันมาก คือ REML 0.313, DerSimonian-Laird 0.309 และ Paule-Mandel 0.318 ส่วนช่วงความเชื่อมั่นแบบ Wald อาจแคบเกินไปเมื่อมีการศึกษาน้อย Handbook จึงชี้ว่าการปรับของ Hartung-Knapp-Sidik-Jonkman (HKSJ) เป็นทางเลือก (Deeks et al., 2024) ในตัวอย่างนี้ Wald ให้ 0.34-0.70 และ HKSJ ให้ 0.33-0.73 ซึ่งกว้างกว่าเล็กน้อย
| สถานการณ์ | แนวทาง | สิ่งที่ต้องรายงาน |
|---|---|---|
| ต้องการตอบ “ผลเฉลี่ยของชุดการศึกษาที่แตกต่างกัน” | Random-effects | ระบุตัวประมาณ τ² และวิธีสร้างช่วงความเชื่อมั่น |
| ตั้งสมมติฐานได้ว่าการศึกษาทั้งหมดประมาณผลจริงค่าเดียว (ต้องมีเหตุผลทางคลินิก) | Fixed-effect | อธิบายเหตุผลทางคลินิก ไม่ใช้ค่า p ของ Q เป็นเหตุผล |
| มีการศึกษาน้อย (เช่น 3-5 ฉบับ) | Random-effects พร้อม HKSJ และเปรียบเทียบหลายวิธี | Handbook แนะนำทำ sensitivity analysis เมื่อมีสองถึงสามการศึกษา |
| ผลสรุปรวมไม่ตรงกับการศึกษาใหญ่ที่สุด | ตรวจน้ำหนักของแต่ละโมเดล | แสดงน้ำหนักในตารางหรือ forest plot |
Prediction interval: ช่วงที่บอกว่าการศึกษาใหม่อาจได้ผลอย่างไร
ช่วงความเชื่อมั่นของ random-effects บอกความไม่แน่นอนของค่าเฉลี่ย ส่วน prediction interval บอกช่วงของผลจริงที่คาดว่าจะพบในการศึกษาใหม่ IntHout และคณะ (2016) อธิบายว่าช่วงนี้แสดงขอบเขตที่คาดของผลจริงในการศึกษาที่คล้ายกัน และตีความง่ายกว่า τ² หรือ I² Cochrane Handbook ใช้สูตร M ± t(k−1) × √(τ² + SE(M)²) โดย M คือผลรวมเฉลี่ย k คือจำนวนการศึกษา และ SE(M) คือความคลาดเคลื่อนมาตรฐานของ M (Deeks et al., 2024) ในข้อมูล BCG แทนค่าได้ดังนี้
| ขั้นตอน | ค่า |
|---|---|
| M (log RR) | −0.7145 (RR = 0.49) |
| SE(M) แบบ HKSJ | 0.1808 |
| τ² | 0.3132 |
| √(τ² + SE²) | √(0.3132 + 0.0327) = 0.5881 |
| t(0.975, df = 12) | 2.179 |
| ครึ่งความกว้าง | 2.179 × 0.5881 = 1.2815 |
| Prediction interval (log RR) | −0.7145 ± 1.2815 = −1.996 ถึง 0.567 |
| Prediction interval (RR) | exp(−1.996) ถึง exp(0.567) = 0.14 ถึง 1.76 |
การอ่านผลคือ ช่วงความเชื่อมั่น 0.33-0.73 บอกว่าค่าเฉลี่ยของ RR ต่ำกว่า 1 อย่างมีนัยสำคัญ แต่ช่วงทำนาย 0.14-1.76 คร่อม 1 หมายความว่า ในการศึกษาใหม่ซึ่งมีบริบทต่างออกไป ผลจริงอาจเป็นการป้องกันที่แรงมากหรือไม่มีผลหรือแม้แต่เพิ่มความเสี่ยงก็เป็นไปได้ ซึ่งสอดคล้องกับ I² ที่ 92% ค่าเฉลี่ยจึงไม่ควรถูกอ้างเป็นผลที่ใช้ได้ทุกบริบท
IntHout และคณะ (2016) ตรวจ meta-analysis ที่มีนัยสำคัญทางสถิติแบบ random-effects (p < 0.05) จำนวน 479 รายการในฐานข้อมูล Cochrane ช่วงปี 2009-2013 ที่มี heterogeneity (I² > 0) พบว่าใน 72.4% ช่วงทำนาย 95% ชี้ว่าผลของการแทรกแซงอาจเป็นศูนย์หรือสวนทิศทาง และใน 20.3% ผลอาจตรงข้ามกับค่าประมาณจุดโดยสิ้นเชิง ผู้เขียนจึงเสนอให้รายงาน prediction interval เป็นประจำ ข้อควรระวังจาก Handbook คือแนะนำให้ใช้เมื่อมีจำนวนการศึกษาพอสมควร (เช่น ตั้งแต่ห้าฉบับ) และไม่มีความไม่สมมาตรของ funnel plot และอาจมีปัญหามากเมื่อมีการศึกษาน้อย (Deeks et al., 2024) แนวคิดว่าโมเดล random-effects ใช้ได้ทั้งการประมาณค่า การทำนาย และการทดสอบสมมติฐานนั้น Higgins และคณะ (2009) อภิปรายไว้อย่างละเอียด
เมื่อไรควรทำ subgroup analysis และ meta-regression
เมื่อ heterogeneity สูง คำตอบไม่ใช่การตัดการศึกษาที่ผลต่างทิ้ง Handbook ระบุว่าโดยทั่วไปไม่ควรตัดการศึกษาออกจาก meta-analysis โดยอาศัยผลของการศึกษานั้น และการสืบหาสาเหตุที่เชื่อถือได้ต้องมาจากการวิเคราะห์ที่กำหนดไว้ล่วงหน้าจริง (Deeks et al., 2024) หลักการที่ Handbook ให้ไว้สำหรับ subgroup analysis และ meta-regression สรุปได้ดังนี้
- กำหนดกลุ่มย่อยและตัวแปรอธิบายไว้ในโปรโตคอลล่วงหน้า และเลือกเพียงไม่กี่ตัวแปร เพราะโอกาสผลบวกลวงเพิ่มตามจำนวนตัวแปรที่ตรวจ
- subgroup analysis เป็นการวิเคราะห์เชิงสังเกตโดยธรรมชาติ ไม่ได้มาจากการเปรียบเทียบแบบสุ่ม
- ใช้การทดสอบความต่างระหว่างกลุ่มย่อยอย่างเป็นทางการ ไม่เปรียบเทียบค่า p ภายในแต่ละกลุ่ม
- โดยทั่วไปไม่ควรทำ meta-regression เมื่อมีการศึกษาน้อยกว่า 10 ฉบับ และควรมี 10 ฉบับต่อหนึ่งตัวแปรที่ใส่ในโมเดล
ข้อมูลที่ใช้ตรวจที่นี่เป็นการสาธิตแบบ post hoc เท่านั้น เราลองสองตัวแปร ตัวแรกคือวิธีสุ่ม (random 7 การศึกษา เทียบกับ alternate หรือ systematic อีก 6 การศึกษา) กลุ่มสุ่มมี RR 0.38 (95% CI 0.22-0.65, I² 89.9%) กลุ่มอื่นมี RR 0.62 (95% CI 0.40-0.95, I² 87.9%) แต่การทดสอบความต่างระหว่างกลุ่มไม่มีนัยสำคัญ (p = 0.18) และอธิบายความแปรปรวนได้ 0% ซึ่งแปลว่าตัวแปรนี้ไม่ช่วยลด heterogeneity ตัวแปรที่สองคือละติจูดสัมบูรณ์ของสถานที่ศึกษา (absolute latitude) ซึ่งเป็นตัวแปรระดับการศึกษา
| ผล | ค่า | การอ่านผล |
|---|---|---|
| ความชันของละติจูด | −0.0291 ต่อองศา (95% CI −0.0432 ถึง −0.0150) | RR ลดลงเมื่อละติจูดสูงขึ้น |
| RR ที่เปลี่ยนต่อ 10 องศา | 0.75 (95% CI 0.65-0.86) | exp(10 × −0.0291) |
| การทดสอบตัวแปร | p < 0.0001 (Wald) และ p = 0.0046 (HKSJ) | ทั้งสองวิธีมีนัยสำคัญ |
| R² | 75.6% | อธิบายความแปรปรวนระหว่างการศึกษาได้ประมาณสามในสี่ |
| Heterogeneity ที่เหลือ | I² 68.4%, QE = 30.7 (df = 11, p = 0.0012) | ยังมี heterogeneity เหลือ |
| RR ที่ละติจูด 13° / 33° / 50° | 0.88 (0.63-1.23) / 0.49 (0.40-0.61) / 0.30 (0.21-0.42) | ค่าทำนายจากโมเดล |
ตัวอย่างนี้สอนสามเรื่อง เรื่องแรก meta-regression ที่ใช้ละติจูดลด I² จาก 92% เหลือ 68% และอธิบายความแปรปรวนได้ 75.6% แต่ยังมี heterogeneity เหลือ เรื่องที่สอง ตัวแปรระดับการศึกษาสะท้อนความสัมพันธ์ระหว่างการศึกษา ไม่ได้พิสูจน์สาเหตุในระดับผู้เข้าร่วมแต่ละคน เรื่องที่สาม ข้อมูลที่ใช้ตัวแปรนี้ใน meta-analysis จริงต้องกำหนดไว้ล่วงหน้าในโปรโตคอล PROSPERO มีช่องให้ระบุการวิเคราะห์กลุ่มย่อยและวิธีที่จะใช้ เช่น subgroup meta-analysis หรือ meta-regression ล่วงหน้า (Centre for Reviews and Dissemination, n.d.)
เขียนรายงานในวิทยานิพนธ์และบทความ: ประโยคตัวอย่างและบริบทไทย
PRISMA 2020 ข้อ 13d กำหนดให้อธิบายโมเดล วิธีระบุว่ามี statistical heterogeneity และขอบเขตของมัน และโปรแกรมที่ใช้ ข้อ 13e กำหนดให้อธิบายวิธีสำรวจสาเหตุของ heterogeneity ข้อ 20b กำหนดให้นำเสนอผลรวมพร้อมความแม่นยำและมาตรวัด statistical heterogeneity และข้อ 20c กำหนดให้นำเสนอผลการสำรวจสาเหตุของ heterogeneity ทั้งหมด (Page et al., 2021) ตัวอย่างประโยคจากข้อมูล BCG เป็นดังนี้
ภาษาอังกฤษ: “We pooled risk ratios using a random-effects model (REML) with the Hartung-Knapp-Sidik-Jonkman adjustment. Between-study heterogeneity was assessed with Cochran’s Q, I², τ², and a 95% prediction interval. The pooled RR was 0.49 (95% CI 0.33 to 0.73; 95% prediction interval 0.14 to 1.76; I² = 92.2%, τ² = 0.313, Q = 152.2, df = 12, p < 0.0001).”
ภาษาไทย: “ผลรวมของ risk ratio ด้วยโมเดล random-effects (REML ปรับด้วย Hartung-Knapp-Sidik-Jonkman) เท่ากับ 0.49 (95% CI 0.33-0.73) โดยมี heterogeneity สูง (I² = 92.2%, τ² = 0.313) และช่วงทำนาย 95% เท่ากับ 0.14-1.76 แสดงว่าผลในการศึกษาใหม่อาจแตกต่างกันมาก”
สำหรับนักศึกษาและนักวิจัยไทย มีสามข้อที่ช่วยให้กรรมการสอบและผู้ทบทวนบทความอ่านเข้าใจ ข้อแรก ใช้คำเรียกให้คงที่ เช่น “ความต่างระหว่างการศึกษา (heterogeneity)” เมื่อกล่าวถึงครั้งแรก แล้วใช้ heterogeneity ตลอดเรื่อง ข้อสอง ระบุซอฟต์แวร์และเวอร์ชัน เช่น R แพ็กเกจ metafor 5.0-1 และ meta 8.5.0 เพราะข้อ 13d ของ PRISMA 2020 ต้องการชื่อโปรแกรม และเก็บสคริปต์ไว้ให้ตรวจย้อนได้ ซึ่งโปรแกรม R ฟรีและมีบทแนะนำสำหรับผู้เริ่มต้น (Balduzzi et al., 2019; Viechtbauer, 2010) ข้อสาม รายงาน Q, I², τ² และ prediction interval ให้ครบ ไม่รายงานเพียงค่า I² ดูหลักการรายงานค่า effect size และ p-value ได้ในบทความ p-value คืออะไร และทำไมต้องรายงาน Effect Size ควบคู่เสมอ และรายการตรวจสถิติก่อนส่งวารสารใน ตรวจสถิติก่อนส่งวารสาร: 12 จุดที่ Reviewer ตรวจเจอบ่อย ส่วนภาพรวมของการทำ Systematic Review ทั้งฉบับสำหรับวิทยานิพนธ์ ดู วิธีทำ Systematic Review สำหรับวิทยานิพนธ์บัณฑิตศึกษาไทย
ข้อผิดพลาดที่พบบ่อย
- เลือก fixed-effect หรือ random-effects จากค่า p ของ Q-test ซึ่ง Handbook ระบุว่าไม่ควรทำ
- สรุปว่า “ไม่มี heterogeneity” เพราะ Q-test ไม่มีนัยสำคัญ ทั้งที่การทดสอบมีกำลังต่ำเมื่อการศึกษามีน้อยหรือเล็ก
- ตัดการศึกษาที่ผลต่างออกเพื่อให้ I² ต่ำลง
- รายงานเฉพาะ I² โดยไม่มี τ² หรือ prediction interval
- เลือกตัวแปรอธิบายหลังเห็นผล แล้วรายงานราวกับกำหนดไว้ล่วงหน้า
- ทำ meta-regression ทั้งที่มีการศึกษาน้อยกว่า 10 ฉบับ
สรุป
heterogeneity I2 เป็นเพียงหนึ่งในหลายค่าที่ต้องอ่านพร้อมกัน ก่อนส่งงาน ให้ตรวจรายการต่อไปนี้
- รายงาน Q (พร้อม df และ p), I² (พร้อมช่วงความเชื่อมั่น), τ² หรือ τ และ prediction interval
- เลือกโมเดลจากคำถามและเหตุผลทางคลินิก ไม่เลือกจากค่า p ของ Q-test
- ระบุตัวประมาณ τ² และวิธีสร้างช่วงความเชื่อมั่น เช่น REML กับ HKSJ
- ตรวจน้ำหนักของแต่ละการศึกษา และทำ leave-one-out
- กำหนดกลุ่มย่อยและ meta-regression ล่วงหน้าในโปรโตคอล และใช้เมื่อมีการศึกษาอย่างน้อย 10 ฉบับ
- ใช้ prediction interval อย่างระมัดระวังเมื่อมีการศึกษาน้อย
- ระบุซอฟต์แวร์ เวอร์ชัน และเก็บสคริปต์ไว้ตรวจย้อน
- รายงานให้ครบตามข้อ 13d, 13e, 20b และ 20c ของ PRISMA 2020
หากต้องการให้ผู้เชี่ยวชาญช่วยตรวจการวิเคราะห์ meta-analysis หรือการรายงาน heterogeneity ดูบริการ ทบทวนวรรณกรรม Systematic Review และ Meta-analysis ของเรา และสามารถใช้แบบฟอร์มที่ /tittot-rao/ หรืออีเมล [email protected] เพื่อสอบถาม ขอรายละเอียดเพิ่มเติม หรือสอบถามส่วนลดพิเศษสำหรับนักศึกษาและนักวิจัยที่ไม่มีทุนสนับสนุน บริการของเราดำเนินการตามแนวทาง ICMJE, COPE และ GPP3 โดยระบุการสนับสนุนด้านการเขียนและการแก้ไขในกิตติกรรมประกาศ
เอกสารอ้างอิง
- Deeks, J. J., Higgins, J. P. T., Altman, D. G., McKenzie, J. E., & Veroniki, A. A. (2024). Chapter 10: Analysing data and undertaking meta-analyses. In J. P. T. Higgins, J. Thomas, J. Chandler, M. Cumpston, T. Li, M. J. Page, & V. A. Welch (Eds.), Cochrane Handbook for Systematic Reviews of Interventions (version 6.5). Cochrane. https://training.cochrane.org/handbook/current/chapter-10
- Higgins, J. P. T., Thompson, S. G., Deeks, J. J., & Altman, D. G. (2003). Measuring inconsistency in meta-analyses. BMJ, 327(7414), 557-560. doi:10.1136/bmj.327.7414.557 PMID: 12958120
- Higgins, J. P. T., & Thompson, S. G. (2002). Quantifying heterogeneity in a meta-analysis. Statistics in Medicine, 21(11), 1539-1558. doi:10.1002/sim.1186 PMID: 12111919
- IntHout, J., Ioannidis, J. P. A., Rovers, M. M., & Goeman, J. J. (2016). Plea for routinely presenting prediction intervals in meta-analysis. BMJ Open, 6(7), e010247. doi:10.1136/bmjopen-2015-010247 PMID: 27406637
- Borenstein, M., Hedges, L. V., Higgins, J. P. T., & Rothstein, H. R. (2010). A basic introduction to fixed-effect and random-effects models for meta-analysis. Research Synthesis Methods, 1(2), 97-111. doi:10.1002/jrsm.12 PMID: 26061376
- Higgins, J. P. T., Thompson, S. G., & Spiegelhalter, D. J. (2009). A re-evaluation of random-effects meta-analysis. Journal of the Royal Statistical Society: Series A (Statistics in Society), 172(1), 137-159. doi:10.1111/j.1467-985x.2008.00552.x
- Viechtbauer, W. (2010). Conducting meta-analyses in R with the metafor package. Journal of Statistical Software, 36(3). doi:10.18637/jss.v036.i03
- Balduzzi, S., Rücker, G., & Schwarzer, G. (2019). How to perform a meta-analysis with R: a practical tutorial. Evidence-Based Mental Health, 22(4), 153-160. doi:10.1136/ebmental-2019-300117 PMID: 31563865
- Colditz, G. A., Brewer, T. F., Berkey, C. S., Wilson, M. E., Burdick, E., Fineberg, H. V., & Mosteller, F. (1994). Efficacy of BCG vaccine in the prevention of tuberculosis: Meta-analysis of the published literature. JAMA, 271(9), 698-702. doi:10.1001/jama.1994.03510330076038 PMID: 8309034
- Page, M. J., McKenzie, J. E., Bossuyt, P. M., Boutron, I., Hoffmann, T. C., Mulrow, C. D., et al. (2021). The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ, 372, n71. doi:10.1136/bmj.n71 PMID: 33782057
- Centre for Reviews and Dissemination, University of York. (n.d.). PROSPERO: International prospective register of systematic reviews (field guidance: analysis of subgroups; accessed 11 October 2026). https://www.crd.york.ac.uk/prospero/
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ