ตรวจสถิติก่อนส่งวารสาร: 12 จุดที่ Reviewer ตรวจเจอบ่อย
การตรวจสถิติก่อนส่งวารสาร คือการไล่ตรวจความถูกต้องของการวิเคราะห์ ความสอดคล้องของตัวเลข และความครบถ้วนของข้อมูลจริยธรรม ให้เสร็จก่อนที่ reviewer จะเป็นคนพบ
บทความนี้สรุปหลักฐานว่าข้อผิดพลาดทางสถิติพบบ่อยเพียงใด รวบรวม 12 จุดที่ควรตรวจตามแนวทาง SAMPL และ ICMJE และสาธิตการคำนวณค่า p ซ้ำด้วย R ทีละขั้น
ทำไมต้องตรวจสถิติก่อนส่งวารสาร: หลักฐานจากบทความที่ตีพิมพ์แล้ว
นักวิจัยจำนวนมากคิดว่าข้อผิดพลาดทางสถิติเป็นเรื่องของงานที่ถูกปฏิเสธเท่านั้น แต่หลักฐานจากบทความที่ผ่านการทบทวนและตีพิมพ์แล้วบอกตรงกันข้าม García-Berthou และ Alcaraz ตรวจความสอดคล้องระหว่างค่าสถิติกับค่า p ในบทความของ Nature และ BMJ ปี 2001 พบว่าผลการทดสอบ 11.6% (21 จาก 181) ใน Nature และ 11.1% (7 จาก 63) ใน BMJ ไม่สอดคล้องกัน และพบอย่างน้อยหนึ่งจุดในบทความ 38% และ 25% ตามลำดับ ผู้วิจัยประเมินว่าส่วนใหญ่น่าจะเกิดจากการปัดเศษ การคัดลอก หรือการจัดพิมพ์ [1]
ในสาขาจิตวิทยา Bakker และ Wicherts ตรวจ 281 บทความ พบว่าผลสถิติราว 18% รายงานไม่ถูกต้อง และราว 15% ของบทความมีข้อสรุปทางสถิติอย่างน้อยหนึ่งจุดที่เมื่อคำนวณใหม่แล้วกลับด้าน คือจากมีนัยสำคัญกลายเป็นไม่มี หรือกลับกัน [2] ต่อมา Nuijten และคณะใช้ R package ชื่อ statcheck ตรวจค่า p กว่า 250,000 ค่าจากวารสารจิตวิทยาหลักแปดฉบับระหว่างปี 1985–2013 พบว่า 49.6% ของบทความที่ใช้การทดสอบสมมติฐาน (8,273 จาก 16,695 บทความ) มีค่า p ที่ไม่สอดคล้องอย่างน้อยหนึ่งค่า และ 12.9% มีความไม่สอดคล้องขั้นรุนแรงที่อาจเปลี่ยนข้อสรุป [3] งานเดียวกันยังพบว่าความไม่สอดคล้องขั้นรุนแรงเกิดกับค่า p ที่รายงานว่ามีนัยสำคัญบ่อยกว่าค่าที่รายงานว่าไม่มีนัยสำคัญ

ตัวเลขเหล่านี้ไม่ได้บอกว่านักวิจัยตั้งใจบิดเบือน แต่บอกว่ากระบวนการทบทวนโดยผู้ทรงคุณวุฒิไม่ได้จับทุกจุด ปัญหาจึงไม่ได้มีแค่เรื่องตัวเลข Strasak และคณะทบทวนวรรณกรรมแล้วรวบรวมข้อผิดพลาดและจุดบกพร่องทางสถิติไว้ 47 รายการ กระจายตั้งแต่ขั้นวางแผนการศึกษา การวิเคราะห์ การเขียนวิธีการ ไปจนถึงการนำเสนอและตีความผล และแนะนำให้นักสถิติเข้ามามีส่วนตั้งแต่ขั้นออกแบบ เพราะความผิดพลาดในขั้นนั้นส่งผลต่อทุกขั้นที่ตามมา [4] สำหรับผู้เขียน ข้อความสำคัญคือ ข้อผิดพลาดที่ตรวจพบได้ก่อนส่ง ควรถูกแก้โดยผู้เขียนเอง ไม่ใช่ปล่อยให้กลายเป็นความเห็นของ reviewer หรือ erratum หลังตีพิมพ์
มาตรฐานที่ reviewer ใช้: SAMPL และ ICMJE
SAMPL (Statistical Analyses and Methods in the Published Literature) เป็นแนวทางการรายงานสถิติพื้นฐานสำหรับวารสารชีวการแพทย์ที่ Lang และ Altman เสนอ และอยู่ในฐานข้อมูลแนวทางการรายงานของ EQUATOR Network [5] [6] ผู้เขียนแนวทางระบุว่า SAMPL ไม่ได้พัฒนาผ่านกระบวนการฉันทามติแบบเป็นทางการ แต่สังเคราะห์จากแนวทางที่ตีพิมพ์แล้ว และออกแบบให้วารสารนำไปใส่ในคำแนะนำผู้นิพนธ์ได้ โดยเน้นว่าข้อผิดพลาดส่วนใหญ่เกิดกับสถิติพื้นฐาน ไม่ใช่สถิติขั้นสูง [5]
หลักการแรกของ SAMPL ยืมมาจาก ICMJE ซึ่งปัจจุบันยังเขียนไว้ในส่วน Statistics ของข้อแนะนำว่า ให้อธิบายวิธีการทางสถิติละเอียดพอที่ผู้อ่านที่มีความรู้และเข้าถึงข้อมูลต้นฉบับได้ จะตัดสินความเหมาะสมและตรวจสอบผลที่รายงานได้ [7] หลักการที่สองของ SAMPL คือรายงานให้ละเอียดพอที่ผู้อื่นจะนำผลไปใช้ในการวิเคราะห์ต่อได้ ซึ่งหมายถึงต้องมีตัวเศษและตัวส่วนของร้อยละ ขนาดกลุ่ม ค่าประมาณขนาดผล และช่วงความเชื่อมั่น เพราะค่า p เพียงอย่างเดียวไม่พอสำหรับการวิเคราะห์ซ้ำ [5] เรื่องค่า p กับขนาดผลเป็นหัวข้อใหญ่ที่ควรศึกษาแยก ในบทความนี้เราเน้นเฉพาะสิ่งที่ตรวจได้ก่อนกดส่ง
12 จุดสถิติที่ reviewer ตรวจเจอบ่อย
เราจัด 12 จุดเป็นสามกลุ่มตามลักษณะของปัญหา กลุ่มแรกคือความถูกต้องของการวิเคราะห์ ซึ่งถ้าผิดอาจต้องวิเคราะห์ใหม่ กลุ่มที่สองคือความสอดคล้องของการนำเสนอ ซึ่งมักแก้ได้ในต้นฉบับ แต่ทำให้ reviewer สงสัยคุณภาพทั้งบทความ และกลุ่มที่สามคือความครบถ้วนเชิงจริยธรรมและความโปร่งใส ซึ่งหลายวารสารใช้เป็นเงื่อนไขก่อนส่งต่อให้ reviewer ด้วยซ้ำ
ตารางที่ 1: 12 จุดสถิติที่ควรตรวจก่อนส่งวารสาร แบ่งเป็นสามกลุ่มตามลักษณะปัญหา
| # | จุดตรวจ | สิ่งที่ reviewer มองหา | ที่มา |
|---|---|---|---|
| ก. ความถูกต้องของการวิเคราะห์ | |||
| 1 | สถิติตรงกับคำถามและชนิดข้อมูล | ข้อมูลจับคู่ใช้การทดสอบแบบจับคู่ ข้อมูลเบ้ใช้สถิติไม่อิงพารามิเตอร์ ระบุว่าแต่ละผลใช้วิธีใด ไม่ใช่รวมรายชื่อวิธีไว้ที่เดียว | SAMPL |
| 2 | ตรวจข้อตกลงเบื้องต้น | รายงานว่าข้อมูลเป็นไปตามข้อตกลงของการทดสอบ เช่น ความเป็นเชิงเส้นของ regression ด้วยการวิเคราะห์ residual | SAMPL |
| 3 | การทดสอบหลายครั้ง | ระบุว่าปรับการเปรียบเทียบพหุคูณหรือไม่ และอย่างไร ระบุการวิเคราะห์ที่ไม่ได้วางแผนไว้ล่วงหน้า (post hoc, subgroup) ว่าเป็นการสำรวจ | SAMPL |
| 4 | ข้อมูลสูญหายและค่าผิดปกติ | บอกวิธีจัดการ missing data และ outlier รวมถึงขนาดตัวอย่างทั้งหมดและรายกลุ่มของทุกการวิเคราะห์ | SAMPL |
| ข. ความสอดคล้องของการนำเสนอ | |||
| 5 | ค่า p ตรงกับค่าสถิติและ df | คำนวณ p ซ้ำจาก t, F, χ², r และ df แล้วต้องได้ค่าที่รายงาน (ดูตัวอย่างคำนวณด้านล่าง) | Nuijten; García-Berthou |
| 6 | รูปแบบการรายงานค่า p | รายงานเป็นค่าจริง เช่น P = 0.03 ไม่ใช่ P < 0.05 ไม่เขียน NS ค่าเล็กสุดที่ต้องรายงานคือ P < 0.001 (ยกเว้นงานพันธุศาสตร์) | SAMPL |
| 7 | ตัวเลขตรงกันทุกจุด | n ในบทคัดย่อ ตาราง และเนื้อความตรงกัน ร้อยละมีตัวเศษและตัวส่วน | SAMPL |
| 8 | สถิติพรรณนาเหมาะกับข้อมูล | ข้อมูลใกล้ปกติใช้ mean (SD) ข้อมูลไม่ปกติใช้ median และพิสัยระหว่างควอไทล์ ไม่ใช้ SE แทนความแปรปรวนของข้อมูล และรายงานขนาดผลพร้อม 95% CI | SAMPL; ICMJE |
| ค. ความครบถ้วนเชิงจริยธรรมและความโปร่งใส | |||
| 9 | ระบุรายละเอียดที่ทำซ้ำได้ | ชื่อและรุ่นของโปรแกรม ระดับ α และการทดสอบหางเดียวหรือสองหาง (หางเดียวต้องให้เหตุผล) | SAMPL |
| 10 | คำรับรองจริยธรรม | ข้อความใน Methods ว่าคณะกรรมการจริยธรรมการวิจัยรับรองแล้ว พร้อมเอกสารที่วารสารกำหนด | ICMJE; J Med Assoc Thai |
| 11 | การลงทะเบียนการทดลองทางคลินิก | หมายเลขทะเบียน (เช่น TCTR) ที่ลงทะเบียนก่อนรับผู้เข้าร่วม และแสดงท้ายบทคัดย่อ | ICMJE; J Med Assoc Thai |
| 12 | แนวทางรายงานตามรูปแบบการวิจัย | checklist ของ CONSORT, STROBE, PRISMA ฯลฯ ที่ตรงกับรูปแบบงาน และส่วนสถิติที่สอดคล้องกับ checklist นั้น | SAMPL; J Med Assoc Thai |
เรียบเรียงจาก SAMPL Guidelines [5] ข้อแนะนำของ ICMJE [7] และแนวทางผู้นิพนธ์ของ J Med Assoc Thai [8] ข้อ 5 อ้างอิงงานของ Nuijten และคณะ [3] และ García-Berthou และ Alcaraz [1]
ในกลุ่มแรก จุดที่พลาดบ่อยคือการเลือกสถิติไม่ตรงกับโครงสร้างข้อมูล เช่น ใช้ independent t-test กับข้อมูลก่อนและหลังของคนกลุ่มเดียวกัน SAMPL ระบุชัดว่าต้องยืนยันว่าข้อมูลเบ้วิเคราะห์ด้วยสถิติไม่อิงพารามิเตอร์ ข้อมูลจับคู่วิเคราะห์ด้วยการทดสอบแบบจับคู่ และความสัมพันธ์ที่วิเคราะห์ด้วย linear regression เป็นเชิงเส้นจริง [5] อีกจุดคือการวิเคราะห์ subgroup ที่ไม่ได้วางแผนไว้แต่เขียนเหมือนเป็นผลหลัก SAMPL ให้ระบุการวิเคราะห์ภายหลังว่าเป็นการสำรวจ
ในกลุ่มที่สอง ผู้เขียนไทยที่ใช้ SPSS มักคัดลอกค่า Sig. = .000 จาก output ลงในต้นฉบับ แต่ค่า p ไม่มีทางเป็นศูนย์พอดี Nuijten และคณะจึงนับ p = .000 เป็นการรายงานที่ไม่ถูกต้อง [3] และ SAMPL แนะนำให้รายงานเป็น P < 0.001 [5] อีกเรื่องที่พบบ่อยคือการเขียน mean ± SD ซึ่ง SAMPL แนะนำให้ใช้รูปแบบ mean (SD) และห้ามใช้ standard error แทนความแปรปรวนของข้อมูล เพราะ SE ไม่ได้บอกการกระจายของข้อมูล [5] ส่วนตัวเลขที่ไม่ตรงกันระหว่างบทคัดย่อ ตาราง และเนื้อความ มักเกิดเมื่อมีการวิเคราะห์ใหม่ระหว่างแก้ต้นฉบับแต่แก้ไม่ครบทุกจุด
กลุ่มที่สามเป็นเรื่องที่ไม่ต้องใช้ความรู้สถิติขั้นสูง แต่ถ้าขาดจะทำให้งานไปไม่ถึง reviewer ได้ ICMJE ระบุว่าส่วน Methods ควรมีข้อความว่างานวิจัยได้รับการรับรองจากคณะกรรมการพิจารณาจริยธรรมที่เป็นอิสระ และแนะนำให้วารสารแสดงหมายเลขทะเบียนการทดลองทางคลินิกไว้ท้ายบทคัดย่อ [7] ส่วนการระบุชื่อและรุ่นของโปรแกรม ระดับ α และการทดสอบแบบหางเดียวหรือสองหาง เป็นรายละเอียดเล็กที่ SAMPL กำหนดไว้แทบทุกหมวดของการวิเคราะห์ [5] รายละเอียดการเขียนวิธีวิจัยทั้งส่วนอ่านเพิ่มได้ที่ การเขียนส่วน Methods
ตัวอย่างคำนวณ: คำนวณค่า p ซ้ำด้วย R ทีละขั้น
จุดที่ 5 ตรวจได้ด้วยตัวเองในไม่กี่นาที หลักคือ ถ้ารู้ค่าสถิติ (t, F, χ² หรือ r) และองศาอิสระ ก็คำนวณค่า p กลับได้เสมอ สมมติต้นฉบับหนึ่งรายงานผลห้ารายการดังตารางที่ 2 เราคำนวณ p สองหางใหม่ด้วยฟังก์ชันพื้นฐานของ R ดังนี้
# คำนวณ p สองหางจากค่าสถิติและ df ที่รายงานในต้นฉบับ
2 * pt(-abs(1.80), df = 28)                      # t(28) = 1.80   -> 0.0826
pf(3.10, df1 = 2, df2 = 57, lower.tail = FALSE)   # F(2, 57) = 3.10 -> 0.0527
pchisq(4.20, df = 1, lower.tail = FALSE)         # chi2(1) = 4.20 -> 0.0404
r <- 0.30; n <- 50
t <- r * sqrt(n - 2) / sqrt(1 - r^2)             # แปลง r เป็น t (df = n - 2)
2 * pt(-abs(t), df = n - 2)                      # r(48) = .30   -> 0.0343

# ช่วงจากการปัดเศษ: t = 1.80 อาจมาจาก 1.795 ถึง 1.805
2 * pt(-c(1.805, 1.795), df = 28)                # 0.0818 ถึง 0.0835
สิ่งที่ต้องระวังคือการปัดเศษ ค่าสถิติที่รายงาน 1.80 อาจมาจากค่าจริงตั้งแต่ 1.795 ถึง 1.805 จึงต้องคำนวณช่วงของ p แทนค่าเดียว Nuijten และคณะยกตัวอย่างว่า t(28) = 2.0 ให้ p = .055 ซึ่งดูเหมือนขัดกับ p < .05 ที่รายงาน แต่ t = 2.0 อาจมาจาก 1.95 ถึง 2.05 ซึ่งให้ p ระหว่าง .0498 ถึง .0613 จึงยังไม่นับว่าไม่สอดคล้อง [3] statcheck จะติดธงความไม่สอดคล้องขั้นรุนแรงเมื่อค่า p ที่คำนวณใหม่ทำให้ข้อสรุปที่ α = .05 เปลี่ยน และถ้าบทความระบุว่าใช้การทดสอบหางเดียว จะยอมรับผลที่สอดคล้องเมื่อคิดแบบหางเดียว [3]
ตารางที่ 2: ตัวอย่างคำนวณค่า p ซ้ำจากผลห้ารายการในต้นฉบับสมมติ
| ผลที่รายงานในต้นฉบับ (สมมติ) | p ที่คำนวณใหม่ | ช่วง p จากการปัดเศษค่าสถิติ | ผลการตรวจ |
|---|---|---|---|
| t(28) = 1.80, p = .03 | .083 | .082–.083 | ไม่สอดคล้องขั้นรุนแรง ข้อสรุปเปลี่ยนจากมีนัยสำคัญเป็นไม่มี (หางเดียวได้ .041 ก็ยังไม่ใช่ .03) |
| F(2, 57) = 3.10, p = .04 | .053 | .052–.053 | ไม่สอดคล้องขั้นรุนแรง ข้ามเส้น α = .05 |
| χ²(1) = 4.20, p = .04 | .040 | .0403–.0405 | สอดคล้อง |
| r(48) = .30, p = .03 | .034 | .031–.038 | สอดคล้อง (ปัดสองตำแหน่งได้ .03) |
| t(45) = 2.10, p = .041 | .041 | .0409–.0418 | สอดคล้อง |
คำนวณด้วย R 4.3.3 โดยผู้เขียน ช่วง p คำนวณจากขอบเขตการปัดเศษของค่าสถิติ เช่น t = 1.80 อาจมาจาก 1.795–1.805 ตามหลักที่ statcheck ใช้ [3]
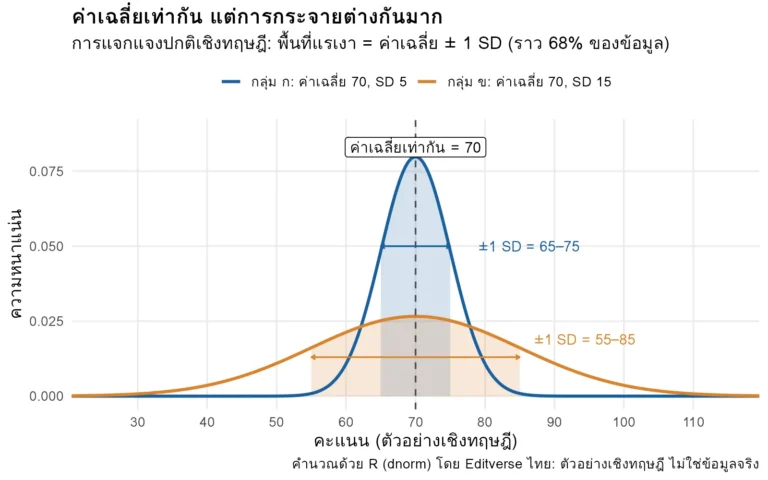
จากตารางที่ 2 มีสองรายการที่ต้องแก้ก่อนส่ง รายการแรก t(28) = 1.80 ให้ p สองหาง .083 ถึงคิดแบบหางเดียวก็ได้ .041 ซึ่งไม่ใช่ .03 อยู่ดี ภาพที่ 2 แสดงว่าค่า t ที่รายงานยังไม่ถึงค่าวิกฤต 2.048 ของ df = 28 รายการที่สอง F(2, 57) = 3.10 ให้ p .053 ซึ่งข้ามเส้น .05 เช่นกัน ทั้งสองกรณีอาจเกิดจากพิมพ์ค่าสถิติผิด ใช้ df ผิด หรือคัดลอก p จากการวิเคราะห์อื่น ผู้เขียนต้องเปิด output เดิมเพื่อหาว่าตัวเลขใดผิด ไม่ใช่เลือกแก้ค่า p ให้ดูมีนัยสำคัญ

กฎตัดสินใจ 5 ขั้นเมื่อตรวจค่า p
- ดึงทุกผลที่มีค่าสถิติ df และ p ออกมาเป็นรายการ ทั้งในเนื้อความ ตาราง และบทคัดย่อ
- คำนวณ p ใหม่ แล้วคำนวณช่วง p จากขอบเขตการปัดเศษของค่าสถิติที่รายงาน
- ถ้า p ที่รายงานอยู่ในช่วง ถือว่าสอดคล้อง ถ้าอยู่นอกช่วง ถือว่าไม่สอดคล้อง และถ้าข้อสรุปที่ α = .05 เปลี่ยน ถือว่ารุนแรง
- ผลที่รุนแรงต้องย้อนกลับไปที่ข้อมูลดิบและ output ของโปรแกรม ห้ามแก้เฉพาะตัวเลข p ให้ตรง เพราะข้อผิดพลาดอาจอยู่ที่ค่าสถิติหรือ df
- เมื่อแก้แล้ว ให้ไล่แก้ทุกตำแหน่งที่ตัวเลขนั้นปรากฏ รวมถึงข้อความอภิปรายผลที่อาศัยนัยสำคัญเดิม
สำหรับต้นฉบับที่มีผลการทดสอบจำนวนมาก statcheck มีทั้ง R package และเว็บแอปที่อ่านผลซึ่งเขียนตามรูปแบบ APA แล้วคำนวณค่า p ใหม่ให้อัตโนมัติ [9] ข้อจำกัดคือโปรแกรมอ่านได้เฉพาะผลที่เขียนครบตามรูปแบบ เช่น ไม่อ่านผลที่มีค่าอื่นแทรกระหว่างค่าสถิติกับ p และไม่อ่านผลในตาราง [3] จึงยังต้องตรวจตารางด้วยมือเสมอ Nuijten และคณะยังเสนอแนวทาง co-pilot คือให้ผู้ร่วมวิจัยอีกคนตรวจการวิเคราะห์ซ้ำ ซึ่งทำได้ทันทีในทีมวิจัยไทยที่มีอาจารย์ที่ปรึกษาหรือผู้ร่วมวิจัยหลายคน [3]
บริบทไทย: ข้อกำหนดของวารสารไทยและตัวอย่างจริง
วารสารไทยหลายฉบับนำมาตรฐานสากลมาเป็นเงื่อนไขของตนเองแล้ว ตัวอย่างที่ตรวจสอบได้คือ Journal of the Medical Association of Thailand (J Med Assoc Thai) ซึ่งเผยแพร่บนระบบ ThaiJO แนวทางผู้นิพนธ์ของวารสารกำหนดให้ผู้นิพนธ์ชื่อแรกหรือผู้นิพนธ์ประสานงานส่งเอกสารอนุญาตจากคณะกรรมการจริยธรรมการวิจัยพร้อมลายมือชื่อรับรอง ให้ผู้นิพนธ์ทุกคนเปิดเผยผลประโยชน์ทับซ้อนด้วยแบบฟอร์มล่าสุดของ ICMJE และกำหนดให้รายงานการทดลองแบบสุ่มใช้ checklist และแผนภาพของ CONSORT 2010 เป็นอย่างน้อย [8] ในส่วนนโยบายการลงทะเบียนการทดลองทางคลินิก วารสารสนับสนุนให้นักวิจัยไทยลงทะเบียนก่อนรับผู้เข้าร่วมรายแรก โดยเลือกทะเบียนที่อยู่ในเครือข่ายขององค์การอนามัยโลก หรือ Thai Clinical Trials Registry (TCTR) และระบุว่ากองบรรณาธิการเริ่มขอเอกสารหรือหมายเลขทะเบียนจากผู้ส่งบทความตั้งแต่เดือนสิงหาคม 2010 [8] [10] ขั้นตอนการลงทะเบียนดูได้ที่ คู่มือลงทะเบียน TCTR
ข้อกำหนดเหล่านี้ทำให้จุดที่ 10 ถึง 12 ไม่ใช่เรื่องที่เลือกทำหรือไม่ทำได้ แต่เป็นเงื่อนไขของการพิจารณา ในทางปฏิบัติ นักศึกษาบัณฑิตศึกษาไทยที่แปลงวิทยานิพนธ์เป็นบทความมักมีเอกสารรับรองจริยธรรมอยู่แล้ว แต่ลืมเขียนหมายเลขรับรองและชื่อคณะกรรมการลงใน Methods หรือรายงานการวิเคราะห์ตามโครงร่างที่เปลี่ยนไประหว่างทางโดยไม่ได้อธิบาย ต้นฉบับที่ขาดองค์ประกอบพื้นฐานเช่นนี้เสี่ยงถูกส่งคืนตั้งแต่ขั้นบรรณาธิการ ดังที่สรุปไว้ใน 10 สาเหตุที่ทำให้บทความถูก Desk Rejected
อีกประเด็นที่เกี่ยวกับนักวิจัยไทยโดยตรงคือเครื่องมือ ผลจาก SPSS ใช้ได้ดี แต่ต้องแปลง output ให้เป็นรูปแบบการรายงานที่วารสารต้องการ ไม่ใช่คัดลอกตารางทั้งตาราง ส่วนผู้ที่ใช้ R สามารถเก็บสคริปต์ไว้ส่งเป็นวัสดุเสริมได้ ซึ่งตอบหลักของ ICMJE ที่ต้องการให้ผู้อ่านตรวจสอบผลได้ [7] การเลือกโปรแกรมอ่านเพิ่มได้ที่ SPSS vs R vs Python
ลำดับการตรวจ 12 จุดในหนึ่งสัปดาห์ก่อนส่ง
เพื่อให้ใช้เวลาอย่างมีประสิทธิภาพ เราแนะนำให้ตรวจจากสิ่งที่แก้ยากที่สุดไปสิ่งที่แก้ง่ายที่สุด วันแรกถึงวันที่สอง ตรวจกลุ่มแรก (จุด 1–4) เพราะถ้าพบว่าใช้สถิติผิดหรือไม่ได้ตรวจข้อตกลงเบื้องต้น อาจต้องวิเคราะห์ใหม่และเขียนผลใหม่ วันที่สามถึงวันที่สี่ คำนวณค่า p ซ้ำทุกค่าตามกฎตัดสินใจข้างต้น และไล่ตรวจตัวเลขให้ตรงกันทุกตำแหน่ง (จุด 5–8) วันที่ห้า ตรวจกลุ่มที่สาม (จุด 9–12) เทียบกับคำแนะนำผู้นิพนธ์ของวารสารเป้าหมายและ checklist ของแนวทางรายงานที่เกี่ยวข้อง แล้วจึงให้ผู้ร่วมวิจัยอ่านทวนแบบ co-pilot อีกรอบ
หากได้รับความเห็นจาก reviewer เรื่องสถิติหลังส่งไปแล้ว หลักเดียวกันยังใช้ได้ คือคำนวณซ้ำ ระบุว่าแก้ที่ใดในต้นฉบับ และตอบอย่างตรงไปตรงมา รายละเอียดการตอบดูได้ที่ วิธีแก้ไขบทความหลังได้รับ Major Reviewer Comments
สรุป
ใช้รายการต่อไปนี้เป็น checklist สุดท้ายก่อนกดส่ง
- สถิติแต่ละตัวตรงกับคำถามวิจัยและโครงสร้างข้อมูล (จับคู่หรืออิสระ ปกติหรือเบ้)
- รายงานการตรวจข้อตกลงเบื้องต้น การจัดการ missing data และ outlier
- ระบุการปรับการเปรียบเทียบพหุคูณ และระบุการวิเคราะห์ที่ไม่ได้วางแผนไว้ว่าเป็นการสำรวจ
- คำนวณค่า p ซ้ำทุกค่าจากค่าสถิติและ df โดยคิดช่วงการปัดเศษ และแก้ทุกจุดที่ข้อสรุปเปลี่ยน
- รายงาน p เป็นค่าจริง ไม่ใช้ NS และไม่เขียน p = .000 (ใช้ p < .001)
- n และร้อยละตรงกันในบทคัดย่อ ตาราง และเนื้อความ ร้อยละมีตัวเศษและตัวส่วน
- ใช้ mean (SD) หรือ median (IQR) ตามการแจกแจง ไม่ใช้ SE แทนความแปรปรวน และรายงานขนาดผลพร้อม 95% CI
- ระบุชื่อและรุ่นโปรแกรม ระดับ α และหางของการทดสอบ
- มีข้อความรับรองจริยธรรม หมายเลขทะเบียนการทดลอง (ถ้ามี) และ checklist ของแนวทางรายงานที่ตรงกับรูปแบบงาน
หากต้องการผู้ตรวจอิสระอีกชั้นก่อนส่ง บริการ ตรวจสอบสถิติก่อนส่ง ของ Editverse ใช้ 12 จุดข้างต้นเป็นกรอบ ตรวจความถูกต้องของการวิเคราะห์ ความสอดคล้องของตัวเลข และความครบถ้วนของข้อมูลจริยธรรม โดยบรรณาธิการที่ถือปริญญาเอกหรือแพทยศาสตรบัณฑิตในสาขาเดียวกับคุณ แล้วส่งรายงานจุดที่ต้องแก้พร้อมเหตุผลกลับให้ผู้เขียนตัดสินใจ เราแก้ไขและยกระดับงานของคุณ เราไม่ได้ทำวิจัยแทนคุณ และไม่รับประกันการตอบรับจากวารสาร ติดต่อได้ที่ [email protected]
คำถามที่พบบ่อย
reviewer ใช้มาตรฐานอะไรตรวจสถิติ
แนวทางที่ใช้บ่อยคือ SAMPL Guidelines และข้อแนะนำของ ICMJE
ตรวจค่า p ซ้ำอย่างไร
คำนวณค่า p ใหม่จากค่าสถิติและ df ทุกค่า โดยคิดช่วงการปัดเศษ แล้วแก้ทุกจุดที่ข้อสรุปเปลี่ยน
ข้อผิดพลาดเล็ก ๆ ที่พบบ่อยคืออะไร
เขียน p = .000 แทน p < .001 ใช้ NS แทนค่าจริง ใช้ SE แทนการกระจาย และตัวเลข n หรือร้อยละไม่ตรงกันระหว่างบทคัดย่อ ตาราง และเนื้อความ
เอกสารอ้างอิง
- García-Berthou, E., & Alcaraz, C. (2004). Incongruence between test statistics and P values in medical papers. BMC Medical Research Methodology, 4, 13. doi:10.1186/1471-2288-4-13 PMID: 15169550
- Bakker, M., & Wicherts, J. M. (2011). The (mis)reporting of statistical results in psychology journals. Behavior Research Methods, 43(3), 666–678. doi:10.3758/s13428-011-0089-5 PMID: 21494917
- Nuijten, M. B., Hartgerink, C. H. J., van Assen, M. A. L. M., Epskamp, S., & Wicherts, J. M. (2016). The prevalence of statistical reporting errors in psychology (1985–2013). Behavior Research Methods, 48(4), 1205–1226. doi:10.3758/s13428-015-0664-2 PMID: 26497820
- Strasak, A. M., Zaman, Q., Pfeiffer, K. P., Göbel, G., & Ulmer, H. (2007). Statistical errors in medical research – a review of common pitfalls. Swiss Medical Weekly, 137(3–4), 44–49. doi:10.4414/smw.2007.11587 PMID: 17299669
- Lang, T. A., & Altman, D. G. (2015). Basic statistical reporting for articles published in biomedical journals: The “Statistical Analyses and Methods in the Published Literature” or the SAMPL Guidelines. International Journal of Nursing Studies, 52(1), 5–9. doi:10.1016/j.ijnurstu.2014.09.006 PMID: 25441757
- EQUATOR Network. (n.d.). SAMPL Guidelines for statistical reporting. https://www.equator-network.org/reporting-guidelines/sampl/
- International Committee of Medical Journal Editors (ICMJE). (2026). Recommendations: Preparing a manuscript for submission to a medical journal (Methods – Statistics; Ethics). https://www.icmje.org/recommendations/browse/manuscript-preparation/preparing-for-submission.html
- Journal of the Medical Association of Thailand. (n.d.). Submissions: Author guidelines (Clinical Trial Registration Policy; Research Ethics Review Committee Form; reporting guidelines). ThaiJO. https://he04.tci-thaijo.org/index.php/JMAThai/about/submissions
- Nuijten, M. B., & Polanin, J. R. (2020). “statcheck”: Automatically detect statistical reporting inconsistencies to increase reproducibility of meta-analyses. Research Synthesis Methods, 11(5), 574–579. doi:10.1002/jrsm.1408 PMID: 32275351 เว็บแอป: https://michelenuijten.shinyapps.io/statcheck-web/
- Thai Clinical Trials Registry (TCTR). (n.d.). Thai Clinical Trials Registry. https://www.thaiclinicaltrials.org/
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ