t-test แบบไหนใช้เมื่อไร: Independent, Paired และ One-sample
t-test มีสามแบบหลักที่ตอบคำถามต่างกัน คือ One-sample t-test สำหรับเทียบค่าเฉลี่ยกลุ่มเดียวกับค่าเกณฑ์ Paired t-test สำหรับข้อมูลที่วัดซ้ำหรือจับคู่ และ Independent t-test สำหรับสองกลุ่มที่ไม่เกี่ยวข้องกัน ซึ่งควรใช้รูปแบบของ Welch เป็นค่าเริ่มต้น บทความนี้ให้กฎการเลือก ข้อตกลงเบื้องต้นที่ต้องตรวจจริง ตัวอย่างการคำนวณด้วย R จากข้อมูลต้นฉบับของ Student การคำนวณ Cohen’s d และแม่แบบการรายงานตาม APA
t-test คืออะไร และแต่ละแบบตอบคำถามอะไร
t-test เป็นการทดสอบสมมติฐานเกี่ยวกับค่าเฉลี่ยเมื่อไม่ทราบความแปรปรวนของประชากรและต้องใช้ความแปรปรวนจากตัวอย่างแทน William Sealy Gosset ตีพิมพ์แนวคิดนี้ในวารสาร Biometrika ปี 1908 ภายใต้นามแฝง “Student” [1] และหนึ่งในชุดข้อมูลที่เขาใช้สาธิตคือข้อมูลชั่วโมงการนอนที่เพิ่มขึ้นของผู้ป่วย 10 คนหลังได้รับยานอนหลับสองชนิด จากงานของ Cushny และ Peebles ใน The Journal of Physiology ปี 1905 [2] ข้อมูลชุดนี้ยังมากับโปรแกรม R ในชื่อ sleep และจะใช้เป็นตัวอย่างการคำนวณในบทความนี้
สิ่งที่ตัดสินว่าควรใช้ t-test แบบใดไม่ใช่ชื่อเมนูในโปรแกรม แต่เป็นโครงสร้างของข้อมูล Kim สรุปไว้ใน Korean Journal of Anesthesiology ว่า independent t-test ใช้เปรียบเทียบค่าเฉลี่ยระหว่างสองกลุ่มที่เป็นอิสระต่อกัน ส่วน paired t-test ใช้กับข้อมูลที่จับคู่กัน และในฐานะสถิติพาราเมตริก ข้อมูลควรเป็นไปตามเงื่อนไขเรื่องการแจกแจงปกติ ความแปรปรวน และความเป็นอิสระ [3] ตารางด้านล่างสรุปความแตกต่างของแต่ละแบบ
| ชนิด | คำถามที่ตอบ | ลักษณะข้อมูล | df | ขนาดอิทธิพล |
|---|---|---|---|---|
| One-sample t-test | ค่าเฉลี่ยของกลุ่มต่างจากค่าเกณฑ์ที่กำหนด (μ0) หรือไม่ | กลุ่มเดียว ตัวแปรเชิงปริมาณ 1 ตัว | n − 1 | d = (M − μ0) / SD |
| Paired t-test | ค่าเฉลี่ยของผลต่างรายคู่ต่างจากศูนย์หรือไม่ | คนเดิมวัดสองครั้ง (ก่อน-หลัง) หรือหน่วยที่จับคู่กัน | nคู่ − 1 | dz = Mdiff / SDdiff |
| Independent t-test (Welch) | ค่าเฉลี่ยของสองกลุ่มที่ไม่เกี่ยวข้องกันต่างกันหรือไม่ | สองกลุ่มอิสระ ขนาดและความแปรปรวนไม่จำเป็นต้องเท่ากัน | Welch–Satterthwaite (มักเป็นทศนิยม) | ds หรือ Hedges’ g |
| Independent t-test (Student) | เหมือนข้างบน แต่สมมติว่าความแปรปรวนประชากรเท่ากัน | สองกลุ่มอิสระ | n1 + n2 − 2 | ds หรือ Hedges’ g |
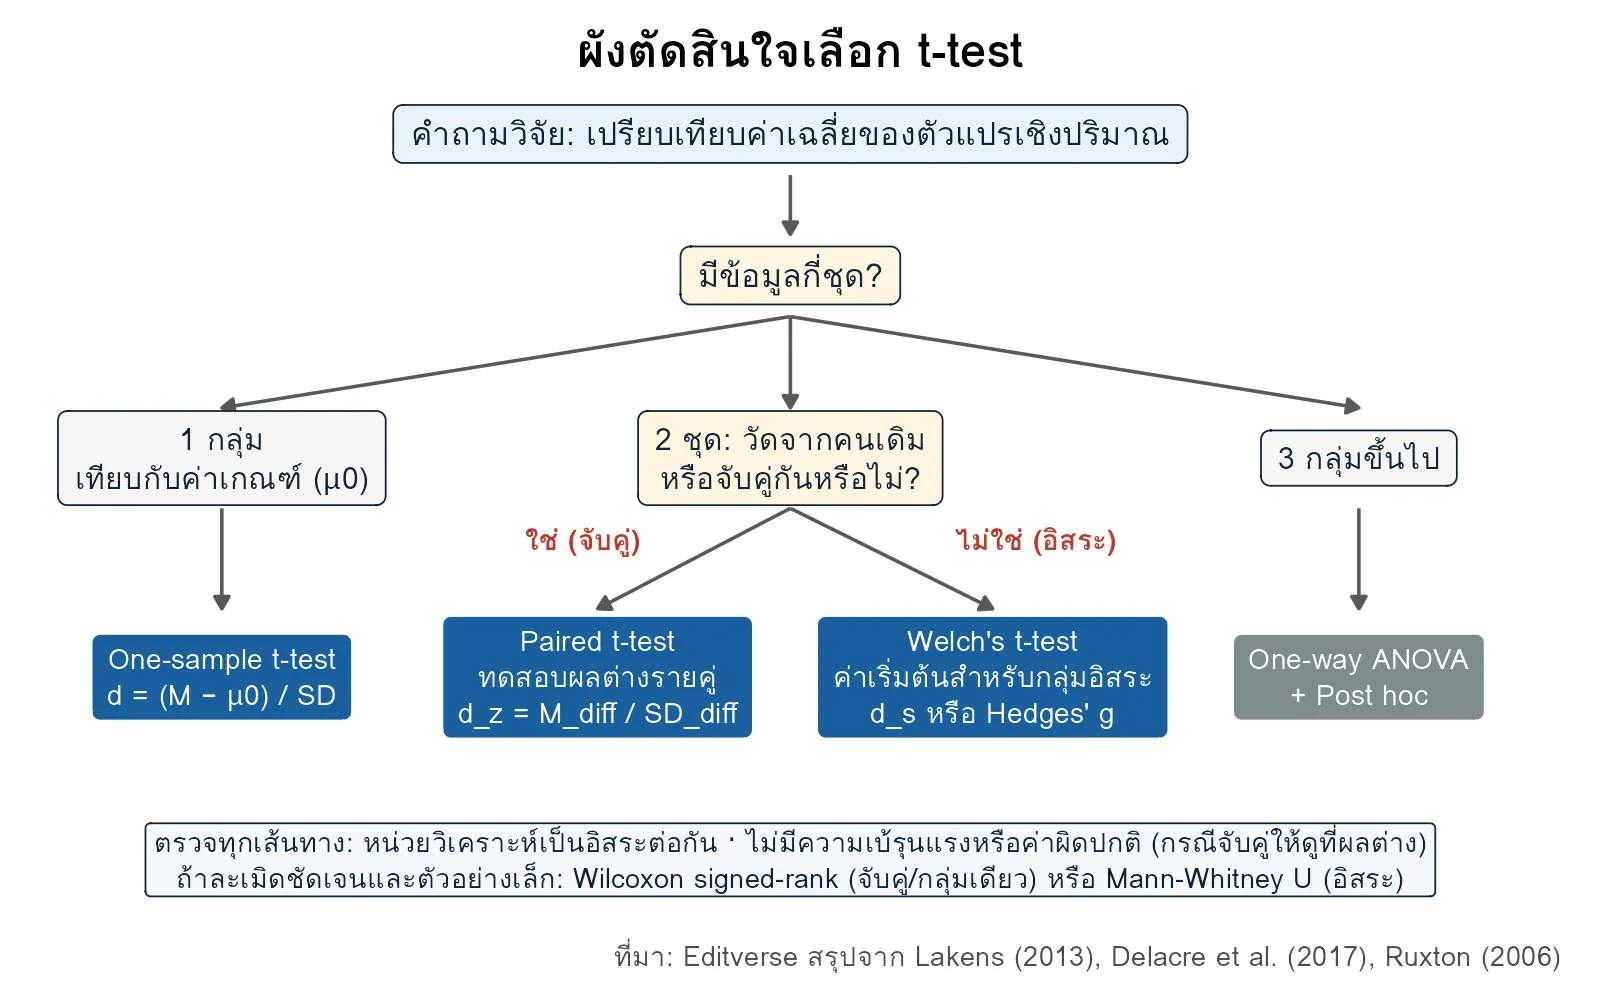
กฎการตัดสินใจจึงมีเพียงสามคำถามตามลำดับ (ภาพที่ 1): (1) เปรียบเทียบค่าเฉลี่ยกี่ชุด ถ้ามีสามกลุ่มขึ้นไปให้ใช้ One-way ANOVA แทนการทำ t-test ซ้ำหลายคู่ (2) ถ้ามีกลุ่มเดียว มีค่าเกณฑ์ที่มีความหมายให้เทียบหรือไม่ (3) ถ้ามีสองชุด ค่าแต่ละค่าในชุดหนึ่งผูกกับค่าใดค่าหนึ่งในอีกชุดหรือไม่ เช่น คนเดิมวัดก่อนและหลัง ตาซ้ายกับตาขวาของคนเดียวกัน หรือคู่แฝด ถ้าใช่คือข้อมูลจับคู่ ถ้าไม่ใช่คือกลุ่มอิสระ
ข้อตกลงเบื้องต้นที่ต้องตรวจก่อนใช้ t-test
ข้อตกลงเบื้องต้นแต่ละข้อมีน้ำหนักไม่เท่ากัน และหลายข้อตรวจด้วยการทดสอบนัยสำคัญได้ไม่ดี ลำดับความสำคัญที่ควรใช้ในทางปฏิบัติมีดังนี้
- ความเป็นอิสระของหน่วยวิเคราะห์ เป็นข้อที่สำคัญที่สุดและตรวจด้วยสถิติไม่ได้ ต้องตัดสินจากแบบแผนการวิจัย เช่น นักเรียนในห้องเดียวกันหรือผู้ป่วยจากแพทย์คนเดียวกันอาจมีคะแนนสัมพันธ์กัน การนับคนเดิมซ้ำหลายครั้งเป็นคนละรายก็ละเมิดข้อนี้
- ตัวแปรตามเป็นเชิงปริมาณ และค่าเฉลี่ยเป็นตัวแทนที่มีความหมายของข้อมูล
- การแจกแจงของค่าเฉลี่ยใกล้เคียงปกติ สิ่งที่ต้องดูคือการแจกแจงของข้อมูลในแต่ละกลุ่มสำหรับกลุ่มอิสระ และการแจกแจงของผลต่างรายคู่สำหรับ paired t-test ไม่ใช่ของคะแนนก่อนและหลังแยกกัน กราฟ Q-Q plot และ histogram ให้ข้อมูลมากกว่าค่า p จากการทดสอบความปกติเพียงตัวเดียว
- ค่าผิดปกติ (outlier) ค่าเดียวที่สุดขั้วในกลุ่มเล็กสามารถเปลี่ยนทั้งค่าเฉลี่ยและ SD ได้มาก ควรตรวจแหล่งที่มาของค่านั้นก่อนตัดสินใจ
- ความแปรปรวนเท่ากัน เป็นเงื่อนไขของ Student’s independent t-test เท่านั้น และหลักฐานปัจจุบันแนะนำให้หลีกเลี่ยงปัญหานี้ด้วยการใช้ Welch’s t-test ตั้งแต่ต้น ตามที่อธิบายในหัวข้อถัดไป
เมื่อข้อมูลเบ้รุนแรงและกลุ่มตัวอย่างเล็ก ทางเลือกที่ใช้กันคือ Wilcoxon signed-rank test สำหรับข้อมูลจับคู่หรือกลุ่มเดียว และ Mann-Whitney U test สำหรับกลุ่มอิสระ ทั้งนี้ Ruxton ชี้ว่า Mann-Whitney U ไม่ใช่ทางออกเมื่อความแปรปรวนต่างกัน และเสนอให้ใช้ Welch’s t-test กับข้อมูลที่แปลงเป็นอันดับ (rank) แทนในกรณีนั้น [4]
ทำไมควรใช้ Welch’s t-test เป็นค่าเริ่มต้นสำหรับสองกลุ่มอิสระ
Student’s independent t-test รวมความแปรปรวนของสองกลุ่มเป็นค่าเดียว (pooled variance) ซึ่งสมเหตุสมผลเฉพาะเมื่อความแปรปรวนของประชากรเท่ากัน Welch เสนอวิธีที่ประมาณความแปรปรวนแยกรายกลุ่มและปรับองศาอิสระตามข้อมูลไว้ใน Biometrika ปี 1947 [5] จึงไม่ต้องสมมติว่าความแปรปรวนเท่ากัน
t = (M1 − M2) / √(s12/n1 + s22/n2)
Delacre, Lakens และ Leys (2017) ทบทวนหลักฐานจากการจำลองและเสนอว่านักวิจัยควรใช้ Welch’s t-test แทน Student’s t-test เสมอ [6] เหตุผลหลักมีสามข้อ ข้อแรก เมื่อขนาดกลุ่มและความแปรปรวนไม่เท่ากัน Student’s t-test ให้อัตราความคลาดเคลื่อนประเภทที่ 1 คลาดจาก 5% ในการจำลองของพวกเขาที่ใช้กลุ่มขนาด 40 และ 60 คน เมื่อกลุ่มเล็กมีความแปรปรวนมากกว่า สัดส่วนค่า p ที่ต่ำกว่า .05 เพิ่มเป็น 0.083 และเมื่อกลุ่มใหญ่มีความแปรปรวนมากกว่า สัดส่วนนี้ลดลงเหลือ 0.028 ข้อที่สอง การทดสอบ Levene ที่ใช้คัดกรองก่อนมีอำนาจการทดสอบต่ำเมื่อกลุ่มเล็กและขนาดไม่เท่ากัน ข้อที่สาม เมื่อขนาดกลุ่มเท่ากัน อำนาจการทดสอบของสองวิธีแทบไม่ต่างกัน การใช้ Welch จึงแทบไม่มีต้นทุน [6]
ภาพที่ 2 เป็นการจำลองซ้ำของ Editverse ด้วย R (20,000 รอบต่อเงื่อนไข ข้อมูลแจกแจงปกติ และค่าเฉลี่ยจริงเท่ากันทุกกรณี) เมื่อกลุ่มที่ 1 มี 20 คนและกลุ่มที่ 2 มี 40 คน หาก SD ของกลุ่มเล็กเป็นสองเท่าของกลุ่มใหญ่ Student’s t-test ปฏิเสธ H0 ผิดถึง 11.2% ส่วน Welch’s t-test อยู่ที่ 5.0% ในทางกลับกัน หาก SD ของกลุ่มเล็กเป็นครึ่งหนึ่ง Student ให้เพียง 1.7% ซึ่งหมายถึงอำนาจการทดสอบที่เสียไป ส่วนเมื่อกลุ่มมีขนาดเท่ากัน (30 ต่อ 30) ทั้งสองวิธีอยู่ใกล้ 5% ในทุกเงื่อนไข

ขั้นตอนสองชั้นที่ตำราหลายเล่มยังสอน คือทดสอบ Levene ก่อนแล้วเลือกแถวผลลัพธ์ตามค่า p ก็ไม่ได้แก้ปัญหา Zimmerman (2004) พบว่าขั้นตอนนี้ไม่สามารถรักษาระดับนัยสำคัญได้และมักทำให้สถานการณ์แย่ลง โดยสรุปว่าการใช้การทดสอบแบบแยกความแปรปรวนโดยไม่มีเงื่อนไขให้การป้องกันดีที่สุดเมื่อขนาดกลุ่มไม่เท่ากัน [7] Ruxton เสริมว่าโปรแกรมอย่าง SPSS แสดงผลทั้งสองแบบพร้อมกัน ผู้วิจัยจึงควรตัดสินใจล่วงหน้าว่าจะใช้แบบใดและอ่านเฉพาะแถวนั้น [4] ใน R ค่าเริ่มต้นของฟังก์ชัน t.test() คือ var.equal = FALSE ซึ่งหมายถึงการใช้ Welch อยู่แล้ว [8] ส่วนใน SPSS ให้รายงานแถว “Equal variances not assumed”
ตัวอย่างการคำนวณ t-test ด้วย R: ข้อมูลการนอนของ Student
ข้อมูล sleep คือชั่วโมงการนอนที่เพิ่มขึ้นจากช่วงควบคุมของผู้ป่วยคนเดิม 10 คนเมื่อได้รับยาสองชนิด เอกสารประกอบของ R เตือนไว้ว่าตัวแปรชื่อ group อาจทำให้เข้าใจผิด เพราะข้อมูลเป็นการวัดจาก 10 คน ไม่ใช่สองกลุ่ม [9] นี่จึงเป็นข้อมูลจับคู่ที่ต้องวิเคราะห์ด้วย paired t-test
- ระบุโครงสร้าง: แต่ละคนมีค่าภายใต้ยา 1 และยา 2 จึงเป็นข้อมูลจับคู่ (คำถามที่ 3 ในภาพที่ 1)
- คำนวณผลต่างรายคน (ยา 2 − ยา 1): ค่าเฉลี่ยผลต่าง Mdiff = 1.58 ชั่วโมง, SDdiff = 1.23
- คำนวณค่า t: t = Mdiff / (SDdiff/√n) = 1.58 / (1.23/√10) = 1.58 / 0.389 = 4.06, df = 10 − 1 = 9
- ค่า p และช่วงความเชื่อมั่น: p = .003 (สองทาง) 95% CI ของผลต่าง [0.70, 2.46] ชั่วโมง
- ขนาดอิทธิพล: dz = 1.58 / 1.23 = 1.28
# ข้อมูล sleep ที่มากับ R (Cushny & Peebles, 1905; Student, 1908)
x1 <- sleep$extra[sleep$group == 1]   # ยา 1 (ชั่วโมงที่นอนเพิ่ม)
x2 <- sleep$extra[sleep$group == 2]   # ยา 2 (ผู้ป่วยคนเดิม 10 คน)

t.test(x2, x1, paired = TRUE)          # ถูก: t(9) = 4.06, p = .003
t.test(x2 - x1, mu = 0)                # one-sample บนผลต่าง: ได้ t เท่ากันทุกตำแหน่ง
mean(x2 - x1) / sd(x2 - x1)            # Cohen's d_z = 1.28

t.test(x2, x1)                         # ผิดแบบ: วิเคราะห์เหมือนสองกลุ่มอิสระ
                                       # Welch t(17.78) = 1.86, p = .079
บรรทัดที่สองของโค้ดแสดงว่า paired t-test คือ one-sample t-test ที่ทดสอบว่าค่าเฉลี่ยของผลต่างเท่ากับศูนย์หรือไม่ ซึ่ง Lakens ระบุว่าทั้งสองแบบให้ผลเหมือนกันทางคณิตศาสตร์ [10] บทเรียนสำคัญอยู่ที่บรรทัดสุดท้าย ถ้านำข้อมูลเดียวกันไปวิเคราะห์ผิดเป็นสองกลุ่มอิสระ จะได้ Welch t(17.78) = 1.86, p = .079 ซึ่งไม่มีนัยสำคัญ สาเหตุคือคะแนนภายใต้ยาสองชนิดของคนเดียวกันสัมพันธ์กันสูง (r = 0.80) การวิเคราะห์ผลต่างรายคนจึงตัดความแปรปรวนระหว่างบุคคลออกไป การเลือกชนิดของ t-test ผิดจึงอาจเปลี่ยนข้อสรุปของงานวิจัยได้ทั้งหมด
ตัวอย่าง One-sample t-test
สมมติว่าหลักสูตรกำหนดว่าผู้เรียนควรได้คะแนนความรู้อย่างน้อยร้อยละ 80 ของคะแนนเต็ม 25 คือ 20 คะแนน (เกณฑ์นี้เป็นค่าสมมติเพื่อการสอน) และกลุ่มตัวอย่าง 27 คนมีค่าเฉลี่ย 20.93, SD 2.25 (ค่าสถิติจากกลุ่มทดลองของ Viseskul และคณะ ซึ่งจะกล่าวถึงต่อไป) จะได้ t = (20.93 − 20) / (2.25/√27) = 0.93 / 0.433 = 2.15, df = 26, p = .041 และ d = 0.93 / 2.25 = 0.41 หมายความว่าค่าเฉลี่ยสูงกว่าเกณฑ์อย่างมีนัยสำคัญ แต่ขนาดอิทธิพลอยู่ในระดับปานกลางค่อนไปทางเล็ก และขอบล่างของ 95% CI ของค่าเฉลี่ย (20.04) อยู่เหนือเกณฑ์เพียงเล็กน้อย
Cohen’s d: คำนวณและแปลผลให้ถูกชนิด
ค่า p บอกเพียงว่าผลที่เห็นไม่น่าจะเกิดจากความบังเอิญ แต่ไม่ได้บอกว่าความแตกต่างใหญ่เพียงใด Lakens จึงแนะนำให้รายงานขนาดอิทธิพลทุกครั้ง และอธิบายว่า Cohen’s d มีหลายแบบที่ใช้ตัวหารต่างกัน [10]
- ds (กลุ่มอิสระ): ผลต่างของค่าเฉลี่ยหารด้วย pooled SD และคำนวณย้อนจากค่า t ได้ว่า ds = t × √(1/n1 + 1/n2)
- Hedges’ g: ds ที่ปรับความเอนเอียงด้วยตัวคูณ 1 − 3/(4(n1 + n2) − 9) ซึ่ง Lakens แนะนำให้รายงาน โดยเฉพาะเมื่อกลุ่มเล็ก
- dz (ข้อมูลจับคู่): ค่าเฉลี่ยผลต่างหารด้วย SD ของผลต่าง ใช้ในการคำนวณอำนาจการทดสอบ แต่เปรียบเทียบกับ ds ของการศึกษาแบบกลุ่มอิสระโดยตรงไม่ได้
- dav: ผลต่างหารด้วยค่าเฉลี่ยของ SD สองครั้ง ใกล้เคียง ds มากกว่า เหมาะเมื่อต้องการเปรียบเทียบข้ามแบบแผนการวิจัย
เกณฑ์ตีความที่ใช้กันมากคือ 0.2 = เล็ก, 0.5 = ปานกลาง และ 0.8 = ใหญ่ ตามข้อเสนอของ Cohen [11] แต่ Lakens เตือนว่าค่าเหล่านี้เป็นเกณฑ์โดยพลการและไม่ควรตีความอย่างตายตัว ควรใช้เฉพาะเมื่อไม่มีงานก่อนหน้าให้เปรียบเทียบ [10] ในข้อมูลการนอน ค่า dz = 1.28 เป็นค่าที่ได้จากผลต่างรายคน หากคำนวณ dav ด้วย SD ของยาแต่ละชนิด (1.79 และ 2.00) จะได้ 1.58 / 1.90 = 0.83 ซึ่งเล็กกว่ามาก ผู้เขียนจึงต้องระบุชนิดของ d ที่รายงานเสมอ
ตัวอย่างจริงจากงานวิจัยไทย: อ่านและตรวจผล t-test ในบทความที่ตีพิมพ์
Viseskul และคณะจากคณะพยาบาลศาสตร์ มหาวิทยาลัยเชียงใหม่ ศึกษาผลของวิดีโอออนไลน์ต่อความรู้และการปฏิบัติเพื่อป้องกันการติดเชื้อของผู้ป่วยมะเร็งในโรงพยาบาลมะเร็งแห่งหนึ่งในภาคตะวันออกเฉียงเหนือ (กลุ่มละ 27 คน) และลงทะเบียนใน Thai Clinical Trials Registry (TCTR20241030009) [12] งานนี้ใช้ทั้ง paired t-test สำหรับเปรียบเทียบก่อนและหลังภายในกลุ่ม และ independent t-test สำหรับเปรียบเทียบระหว่างกลุ่ม ตรงกับผังในภาพที่ 1 และรายงาน Cohen’s d คู่กับค่า t ซึ่งเป็นแนวปฏิบัติที่ดี
| ผลลัพธ์หลังทดลอง | กลุ่มทดลอง M (SD) | กลุ่มควบคุม M (SD) | ที่รายงานในบทความ | คำนวณซ้ำด้วย R (Student / Welch) |
|---|---|---|---|---|
| ความรู้ (เต็ม 25) | 20.93 (2.25) | 18.04 (2.49) | t = 4.473, df = 26, p < 0.001, d = 1.22 | t(52) = 4.47 / t(51.47) = 4.47, p < .001, ds = 1.22, g = 1.20 |
| การปฏิบัติ (เต็ม 75) | 61.33 (9.50) | 54.44 (6.42) | t = 3.121, df = 26, p = 0.002, d = 0.85 | t(52) = 3.12, p = .003 / t(45.65) = 3.12, p = .003, ds = 0.85 |
การคำนวณซ้ำจากค่าเฉลี่ยและ SD ในบทความยืนยันว่าค่า t และ Cohen’s d ถูกต้อง และสอดคล้องกับสูตร ds = t × √(1/27 + 1/27) เช่น 4.473 × 0.272 = 1.22 อย่างไรก็ดี มีสองจุดที่ผู้เขียนวิทยานิพนธ์ควรเรียนรู้ จุดแรก ตารางเปรียบเทียบระหว่างกลุ่มรายงาน df = 26 ซึ่งเป็น df ของการเปรียบเทียบภายในกลุ่ม ขณะที่ independent t-test ของกลุ่มละ 27 คนควรมี df = 52 (Student) หรือประมาณ 45.65–51.47 (Welch) จุดที่สอง ค่า p ของผลที่ไม่มีนัยสำคัญ เช่น t = −1.328 ที่รายงาน p = 0.100 และ t = 0.623 ที่รายงาน p = 0.268 ใกล้เคียงกับค่า p แบบทางเดียว (คำนวณได้ .098 และ .269 ส่วนค่าสองทางคือ .196 และ .539 ตามลำดับ) แต่บทความไม่ได้ระบุทิศทางของการทดสอบ ข้อสรุปหลักที่มีนัยสำคัญไม่เปลี่ยนแปลง แต่ทั้งสองจุดแสดงว่าการรายงาน df และการระบุว่าเป็นการทดสอบทางเดียวหรือสองทางช่วยให้ผู้อ่านตรวจสอบผลได้
บริบทไทย: t-test ในวิทยานิพนธ์และวารสารวิชาการไทย
วิทยานิพนธ์ระดับบัณฑิตศึกษาในไทยจำนวนมากใช้ SPSS และรายงาน t-test เป็นตารางค่าเฉลี่ย ค่า t และค่า Sig. ข้อผิดพลาดที่ควรระวังเมื่อใช้โปรแกรมนี้ ได้แก่เลือกแถวผลลัพธ์ของ Independent Samples Test ตามผล Levene ทั้งที่ควรกำหนดไว้ในบทที่ 3 ล่วงหน้า [4] ใช้ independent t-test กับข้อมูลก่อน-หลังของคนกลุ่มเดียว รายงาน “Sig. = .000” แทน p < .001 และไม่รายงานขนาดอิทธิพล
ประเด็นขนาดอิทธิพลได้รับการอภิปรายในวงวิชาการไทยด้วย สำเริง ไกยวงค์ เขียนในวารสารปัญญาภิวัฒน์ว่าขนาดผลกระทบเป็นผลลัพธ์ที่สำคัญที่สุดของการทดสอบสมมติฐาน เพราะสื่อความสำคัญในทางปฏิบัติที่การทดสอบนัยสำคัญบอกไม่ได้ [13] สำหรับนักวิจัยที่จะส่งบทความไปวารสารนานาชาติหรือวารสารไทยที่ใช้รูปแบบ APA การเขียนบทที่ 3 ให้ระบุชนิดของ t-test ระดับนัยสำคัญ ทิศทางการทดสอบ และชนิดของ Cohen’s d ตั้งแต่ขั้นโครงร่าง จะลดการแก้ไขในขั้นสอบและขั้นพิจารณาบทความได้มาก ดูแนวทางเพิ่มเติมได้ที่บทความ การเขียนส่วน Methods และ การเลือกระหว่าง SPSS, R และ Python
วิธีรายงานผล t-test ตามรูปแบบ APA
คู่มือ APA ฉบับที่ 7 กำหนดรูปแบบการรายงานสถิติในเนื้อความ [14] กฎที่ใช้กับ t-test โดยตรงสรุปจากแนวทางของ Purdue OWL ได้ดังนี้ [15]
- สัญลักษณ์สถิติที่เป็นอักษรละตินพิมพ์ตัวเอียง เช่น t, p, M, SD, d และใส่ df ในวงเล็บหลัง t
- ค่าที่มากกว่า 1 ไม่ได้ เช่น p ไม่ต้องมีเลขศูนย์นำหน้า (p = .042) ส่วนค่าที่เกิน 1 ได้ เช่น d ให้ใส่ศูนย์ (0.41)
- รายงาน p แบบตรงตัวสองหรือสามตำแหน่ง และเมื่อน้อยกว่า .001 ให้เขียน p < .001 (ไม่เขียน .000)
นอกจากนี้ Ruxton แนะนำว่าเมื่อใช้ Welch’s t-test ควรระบุชื่อการทดสอบพร้อมรายงานค่าเฉลี่ย ความแปรปรวน และขนาดตัวอย่างของแต่ละกลุ่ม ค่า t, df ที่คำนวณได้ และค่า p [4] ส่วนขนาดอิทธิพลและช่วงความเชื่อมั่นควรรายงานคู่กันเพื่อให้ผู้อ่านเห็นขนาดของผลต่างจริง [10] ตัวอย่างด้านล่างใช้ตัวเลขที่คำนวณในบทความนี้
| ชนิด | ตัวอย่างประโยครายงาน (APA) |
|---|---|
| Welch’s t-test | กลุ่มทดลอง (M = 61.33, SD = 9.50, n = 27) มีคะแนนการปฏิบัติสูงกว่ากลุ่มควบคุม (M = 54.44, SD = 6.42, n = 27), Welch’s t(45.65) = 3.12, p = .003, ผลต่าง = 6.89, 95% CI [2.45, 11.33], ds = 0.85 |
| Paired t-test | ยา 2 เพิ่มชั่วโมงนอนมากกว่ายา 1 โดยเฉลี่ย 1.58 ชั่วโมง (SDdiff = 1.23), t(9) = 4.06, p = .003, 95% CI [0.70, 2.46], dz = 1.28 |
| One-sample t-test | คะแนนความรู้เฉลี่ย (M = 20.93, SD = 2.25) สูงกว่าเกณฑ์ 20 คะแนน, t(26) = 2.15, p = .041, 95% CI ของค่าเฉลี่ย [20.04, 21.82], d = 0.41 |
ข้อสังเกตคือ df ของ Welch มักเป็นทศนิยม ให้รายงานสองตำแหน่ง และในตารางผลลัพธ์ภาษาไทยควรใช้หัวคอลัมน์และสัญลักษณ์ชุดเดียวกับเนื้อความ หากใช้การทดสอบทางเดียว ต้องระบุเหตุผลเชิงทฤษฎีไว้ในบทที่ 3 ก่อนเก็บข้อมูล ไม่ใช่เลือกหลังจากเห็นผล
สรุป
- เลือก t-test จากโครงสร้างข้อมูล: กลุ่มเดียวเทียบเกณฑ์ใช้ One-sample, คนเดิมหรือหน่วยจับคู่ใช้ Paired, สองกลุ่มอิสระใช้ Independent และสามกลุ่มขึ้นไปใช้ ANOVA
- สำหรับสองกลุ่มอิสระ ใช้ Welch’s t-test เป็นค่าเริ่มต้น โดยไม่ต้องทดสอบ Levene ก่อน และระบุไว้ในบทที่ 3 ล่วงหน้า
- ตรวจความเป็นอิสระจากแบบแผนการวิจัย และตรวจการแจกแจงด้วยกราฟ (กรณีจับคู่ให้ดูที่ผลต่าง)
- อย่าวิเคราะห์ข้อมูลก่อน-หลังเป็นสองกลุ่มอิสระ ตัวอย่างข้อมูลของ Student แสดงว่าผลเปลี่ยนจาก p = .003 เป็น p = .079
- รายงาน M, SD, n, t(df), p แบบตรงตัว, 95% CI และ Cohen’s d พร้อมระบุชนิด (ds, g, dz หรือ dav)
- ระบุว่าเป็นการทดสอบสองทางหรือทางเดียว และตรวจว่า df ตรงกับชนิดของการทดสอบ
หากคุณวิเคราะห์ข้อมูลเสร็จแล้วและต้องการให้ผู้เชี่ยวชาญตรวจว่าเลือก t-test ถูกชนิด คำนวณขนาดอิทธิพลถูกต้อง และเขียนรายงานตามรูปแบบที่วารสารกำหนด ทีมบรรณาธิการของ Editverse ซึ่งมีวุฒิปริญญาเอกหรือแพทยศาสตรบัณฑิตในสาขาของคุณ ให้บริการวิเคราะห์และตรวจสอบสถิติงานวิจัย เราแก้ไขและยกระดับงานของคุณ โดยไม่ได้ทำวิจัยแทนคุณ
คำถามที่พบบ่อย
เลือก t-test แบบใดให้ตรงข้อมูล
กลุ่มเดียวเทียบค่าเกณฑ์ใช้ One-sample คนเดิมหรือหน่วยจับคู่ใช้ Paired สองกลุ่มอิสระใช้ Independent และถ้ามีสามกลุ่มขึ้นไปให้ใช้ ANOVA
ทำไมควรใช้ Welch’s t-test เป็นค่าเริ่มต้น
สำหรับสองกลุ่มอิสระ Welch’s t-test ไม่ต้องสมมติว่าความแปรปรวนเท่ากัน จึงใช้ได้โดยไม่ต้องทดสอบ Levene ก่อน และควรระบุไว้ในบทที่ 3 ล่วงหน้า
วิเคราะห์ข้อมูลก่อน-หลังเป็นสองกลุ่มอิสระได้หรือไม่
ไม่ได้ ข้อมูลที่วัดซ้ำในคนเดิมต้องใช้ Paired t-test ตัวอย่างข้อมูลของ Student ในบทความแสดงว่าผลเปลี่ยนจาก p = .003 เป็น p = .079 เมื่อวิเคราะห์ผิดแบบ
เอกสารอ้างอิง
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. doi:10.2307/2331554
- Cushny, A. R., & Peebles, A. R. (1905). The action of optical isomers: II. Hyoscines. The Journal of Physiology, 32(5–6), 501–510. doi:10.1113/jphysiol.1905.sp001097 PMID: 16992790
- Kim, T. K. (2015). T test as a parametric statistic. Korean Journal of Anesthesiology, 68(6), 540–546. doi:10.4097/kjae.2015.68.6.540 PMID: 26634076
- Ruxton, G. D. (2006). The unequal variance t-test is an underused alternative to Student’s t-test and the Mann–Whitney U test. Behavioral Ecology, 17(4), 688–690. doi:10.1093/beheco/ark016
- Welch, B. L. (1947). The generalization of “Student’s” problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. doi:10.1093/biomet/34.1-2.28
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch’s t-test instead of Student’s t-test. International Review of Social Psychology, 30(1), 92–101. doi:10.5334/irsp.82
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. doi:10.1348/000711004849222
- R Core Team. (n.d.). t.test: Student’s t-Test (R documentation, package stats). The R Project for Statistical Computing. https://stat.ethz.ch/R-manual/R-devel/library/stats/html/t.test.html
- R Core Team. (n.d.). sleep: Student’s Sleep Data (R documentation, package datasets). The R Project for Statistical Computing. https://stat.ethz.ch/R-manual/R-devel/library/datasets/html/sleep.html
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. doi:10.3389/fpsyg.2013.00863 PMID: 24324449
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates. doi:10.4324/9780203771587
- Viseskul, N., Kasatpibal, N., Suwan, N., Chaywong, Y., & Pholdee, N. (2025). Effectiveness of using an online instructional video for preventing infections among Thai patients with cancer: A quasi-experimental study. Belitung Nursing Journal, 11(2), 215–223. doi:10.33546/bnj.3681 PMID: 40256386
- สำเริง ไกยวงค์. (2560). ขนาดผลกระทบ: ผลลัพธ์ที่สำคัญที่สุดของการทดสอบสมมติฐาน. วารสารปัญญาภิวัฒน์, 9(1), 276–287. https://so05.tci-thaijo.org/index.php/pimjournal/article/view/85055
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). doi:10.1037/0000165-000
- Purdue Online Writing Lab. (n.d.). Numbers and statistics (APA Style, 7th ed.). Purdue University. https://owl.purdue.edu/owl/research_and_citation/apa_style/apa_formatting_and_style_guide/apa_numbers_statistics.html
มีคำถามหรือต้องการใบเสนอราคา?
ส่งข้อความสั้นๆ ถึงเรา ตอบกลับภายใน 24 ชั่วโมงในวันทำการ